by angus | 2026-09-26
學生用 AI 做功課快了,錯誤也多了。做功課要先想、再用,並交代思考過程
協作者:張Sir與AI
這半年,張Sir聽過不少家長、老師和學生談 AI 做功課。學生說,功課快多了。家長也輕鬆了,還說終於有信心輔導孩子,AI 在背後幫了不少忙。老師以前很在意學生有沒有用 AI,現在習慣了,不太去查,自己備課也快得多。大家起初都說滿意,多聊兩句,幾句抱怨便陸續出來:錯誤多,論證費時,推理過程沒人細看。生成式 AI,「生」就「成」了。
澳門互聯網研究學會今年六月在世界互聯網項目年會發表居民調查結果,七月再於網站刊出報告及詳細數據。張Sir七月也曾撰文分析。用戶以 5 分為滿分替自己的 AI 素養打分,「使用生成式 AI 時遵守倫理道德」平均有 4.0 分,「知道甚麼是 AI 幻覺」卻只有 2.6 分。AI 幻覺(AI hallucination)就是模型寫出看似合理、其實錯誤甚至憑空捏造的內容。另有 45% 用戶說,自己從不或只是偶爾核查 AI 給出的信息。受訪用戶給自己的倫理分數頗高,對 AI 會怎樣出錯卻不太清楚,收到答案後也未必動手查。
人為甚麼會跟着 AI 答錯
用計數機計數、用手機記電話、用導航找路,都是把一小部分工作交給工具,心理學稱為認知卸載(cognitive offloading)。張Sir年初談 AI 寫作的誤區時用過這個詞。人雖然省了力,方向盤還在自己手上,因為要算甚麼、打電話給誰、去哪裡,心裡一早清楚。
按計數機之前,人已經知道自己要算哪條數,結果離不離譜也有個大概。到了 AI,答案和理由一併出現,語氣還很有把握。讀着讀着,一不留神,連要做判斷也忘了。
賓夕法尼亞大學沃頓商學院的 Steven Shaw 與 Gideon Nave 今年一月把這種情況稱為認知放棄(cognitive surrender)。他們找來一千多人做實驗,回答一些很容易憑直覺選錯的推理題,旁邊有 ChatGPT 隨時可問。研究人員暗中動了手腳,讓 ChatGPT 在一半題目給錯答案。碰到這些錯誤答案,問過 ChatGPT 的人有八成照抄,答對的反而比完全不用 AI 的人少,信心卻更高。研究人員後來改成答對一題便給獎金,也讓參加者每做完一題立即知道對錯。肯推翻錯誤答案的人由兩成升到四成多,仍然未過半。
用 AI 做功課,學到的反而少了
實驗室裡的推理題,幾分鐘便做完,對錯也很快揭曉。學生每天靠 AI 少想一步,功課照樣交得出去,影響要過一段時間才看得出來。美國皮尤研究中心去年秋天訪問 13 至 17 歲青少年,54% 表示用過聊天機器人幫忙做功課。
沃頓商學院另一個團隊在土耳其一所高中做過實驗,讓近一千名學生分三組練習數學。一組可以隨便問 GPT-4;一組使用老師設定的 GPT Tutor,裡面有教師提供的解法和常見錯誤,通常只提示,不直接給答案;第三組只用課本。隨便問 GPT-4 的學生,練習成績比課本組高 48%,收走 AI 後再考試,成績卻低了 17%。GPT Tutor 組跟課本組相比,考試成績沒有明顯差別。AI 把答案一步步寫在眼前,學生看得「熟口熟面」,很容易當成自己已經學懂。
香港大學與斯德哥爾摩大學的團隊今年六月發表一份追蹤研究。他們查看內地中部一個縣 26,811 名初一至高三學生兩年半的紀錄,再按學生開始使用 AI 的先後時間比較。研究估計,使用 AI 後,功課分數升了 18%,做功課的時間少了三成;到了閉卷月考,成績在半年內跌了 20%,約兩年後的中考和高考成績分別跌了 24% 和 18%。研究團隊發現,約八成 AI 用戶呈現「功課外判」特徵,學習損失也主要發生在這一組。使用 AI 後仍花相若時間做功課的學生,損失較小。
有些 AI 產品近年加入學習模式,只給提示,不直接交答案,做法跟土耳其實驗的 GPT Tutor 相近。不過,學生可以自行決定是否打開。追蹤研究團隊的吳延暉近日接受《人物》訪問時說,內地市面早已有逐步講解的學習工具,多數學生仍會選即時給答案的通用 AI,把省下的時間拿去做別的事。功課若只看最後答案,學生選最快的工具很自然。老師怎樣給分,很大程度決定學生怎樣用 AI。連思考過程也計分,學生才有理由打開學習模式。
內地、香港和澳門怎樣做
國家教育部基礎教育教學指導委員會 2025 年 5 月發布《中小學生成式人工智能使用指南(2025年版)》。小學生不得獨自使用開放式內容生成功能;到了初中,要開始分析 AI 內容是否合乎邏輯;高中生則可結合技術原理做探究。指南明確禁止學生把 AI 生成的內容直接當作功課或考試答案,老師也要帶學生找出 AI 文本的漏洞。
香港教育局今年六月公布《中小學數字教育發展藍圖》。當中的《中小學應用人工智能教學指南》提醒老師,學生若用 AI 代替思考,容易變成「高技術低思維」。功課不宜讓學生直接提交 AI 生成的內容;老師可在課堂上即時口頭查問,也可要求學生交出思考過程。教育局去年底的調查顯示,54.2% 小學和 70.2% 中學已有至少一半老師使用 AI 輔助教學。
澳門方面,教青局表示已透過課程法規、教材、教師培訓和向學校提供建議指引等配套推進人工智能教育。2026/2027 學年的措施包括補充教材、培訓教師,以及資助學校設立「人工智能實驗教室」。前述居民調查顯示,不少用戶仍弄不清 AI 怎樣出錯,也沒有養成查證的習慣。
國際方面,經合組織(OECD)與歐盟委員會今年六月正式發布中小學 AI 素養框架,以批判力去評估 AI 輸出是其中一項重點;PISA 2029 也會加入「媒體與AI素養」評估領域。屆時,各地學生判斷 AI 答案的能力便有數據可供比較。
功課可以怎樣改
即使有指南,也未必管得到每一道功課。學生會不會直接問 AI 拿答案,還要看老師怎樣出題、怎樣給分。張Sir年初談中小學生用 AI 做功課時,提出過三個做法:
- 學生先寫骨架。 做理科題,先寫已知條件、題目要求、準備使用的公式,再記下每一步的理由。做文科題,就用自己的話寫出立場、理由、例子和結論。寫得粗糙不要緊,老師反而看得到學生有沒有想過。
- AI 坐教練位,只負責提問。 學生把骨架交給 AI,有學習模式就打開,叫它繼續追問。例如:這一步依賴甚麼前提?有沒有反例?這個例子能代表整體嗎?換個題型還成立嗎?結論是否要收窄?
- 學生重寫定稿,交代改了甚麼。 隨功課附上一小段紀錄,寫下最初怎樣問 AI、AI 怎樣回答,自己接受和修改了哪些內容,又用了甚麼資料查證,有沒有標示 AI 參與。
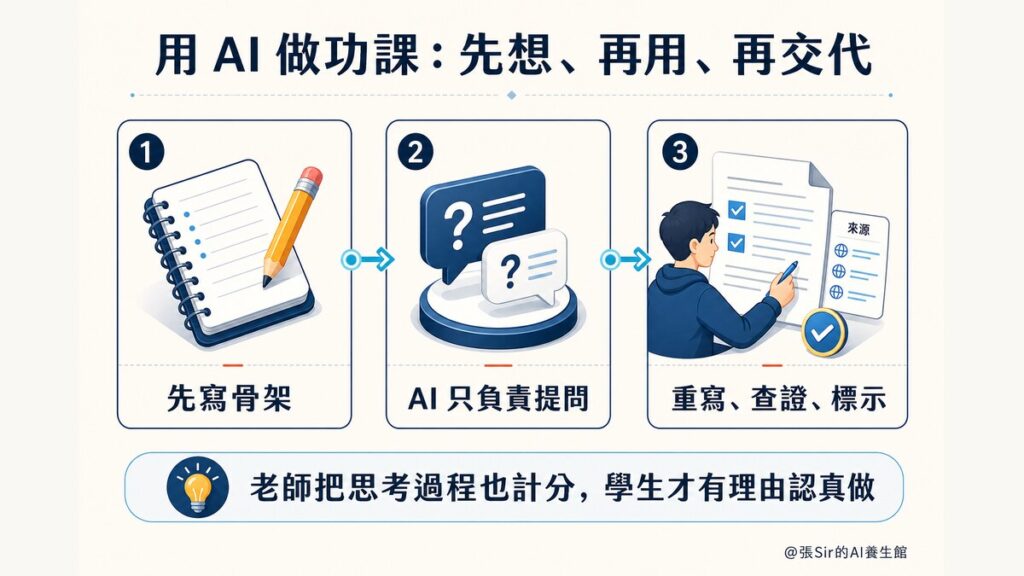
沃頓實驗已經給了獎金,每做完一題又立即公佈對錯,結果仍有過半人跟着 AI 答錯。學生若先寫下自己的思路,AI 答甚麼便有得比較。老師也要把一部分分數放在骨架、提問回合和重寫版本上,學生才會認真走完這三步。
張Sir一位清華大學的朋友,最近在朋友圈說起他的岳父,正好是個例子。老人家年屆九十,退休前是清華數學系教授,長年教數學分析,也參加過全國考研數學命題組,平日仍以演算數學題為樂。聽說大模型解題厲害,他便拿來逐題試,發現豆包的確又快又好。直到有一題,豆包的答案和他自己推的不一樣,他翻查推算過程,發現模型草率地把一個收斂、發散的判斷弄錯了。他指出之後,豆包很快改正,還誠懇道歉。老人家說:「原來大模型也會出錯,也不是那麼可靠!」朋友回了他一句:「認知吝嗇嘛,人機皆然。」能省力就省力,心理學叫認知吝嗇(cognitive miser)。老教授肯花這份力,自己先推了一遍,AI 的錯處才藏不住。
課堂上也可以刻意讓學生發現 AI 的錯。例如,上歷史課,學生先請 AI 解釋一個事件,再逐個查人名、年份和因果,便可能找到被它混在一起的相近事件。科學題可以從推理步驟入手,看看哪一步表面像教科書,實際已經走錯。語文課則可比較 AI 和真人寫的文章,談談為甚麼文字流暢,裡面仍然可能沒有多少想法。學生自己發現了 AI 一次錯,下次再看到同樣肯定的答案,自然會多查一步。
家長和老師想知道孩子有沒有真的想過,可以問四句:不看稿,能不能口頭講一遍?能不能舉一個反例?能不能說清楚自己改了哪裡?為甚麼改?四個問題都答得出,思考多半還掌握在學生手上。這比逐份追查孩子有沒有用 AI 省力,也更有用。
資源差距會在課室放大
同一份功課帶回家,有些學生可用付費工具,還有家長陪着;有些只有一部手機和免費版本,打開 AI 最常做的就是問答案。澳門調查也看到不同群體的差距:18 至 34 歲用戶的 AI 素養平均 3.6 分,學生群體 3.5 分,家庭主婦、退休及失業群體只有 3.2 分。家裡幫不上忙的學生,更需要學校照顧。
香港的教學指南也提醒老師,如果要求學生在家使用付費功能,或者把佔分很重的功課留在家做,評估可能有失公平。皮尤的調查還發現,約四成美國 13 至 17 歲青少年的家長從未和子女談過 AI 聊天機器人。
AI 會錯,學生最好親眼見過一次,重要答案也要學會找回資料來源核對。自己和同學的個人信息、照片、聲音,不應隨手輸入 AI。交功課時用過 AI,就清楚標示。這些都是每個學生都要學的基本數碼常識。
AI 讓答案來得很快,學校能做的,是在功課裡替學生留出先想一遍、再查一遍的時間。
後記:這篇文章怎樣寫成
這篇文章由張Sir和 AI 協作完成,前後來回二十多輪。張Sir先定下骨架,手上有年初兩篇舊文和七月的澳門調查分析,再把香港、內地及其他地方的材料加進來。開場裡家長、老師和學生說過的話,都是張Sir親耳聽到的。清華老教授的故事來自朋友分享,經朋友同意刊出。AI 幫忙找資料,也負責起草和改寫,約五分鐘便交出初稿。
之後,張Sir接着用了約五小時查證、校對和修改。初稿引用沃頓論文時,跟着學院介紹稿寫獎金加即時對錯能令人「明顯更願意」推翻錯誤答案。張Sir要求查看原文,由於網站做了反爬蟲機制,大模型爬不了,張Sir再手動下載 PDF 核對,才看到肯推翻的人只由兩成升到四成多,大多數人依然照抄。AI 又把「高技術低思維」按新聞報道歸入《學習架構》,張Sir翻開教育局原文,才確認它出自《教學指南》。內地兩萬六千名學生的追蹤研究,是張Sir要求補反面案例後找到的;另一個流傳甚廣的美國案例只能找到二手轉述,張Sir一般不太採用,最後刪去。
澳門那句「暫時未見官方公佈相關的使用指引」,原是張Sir自己的措辭。定稿前,他仍要求再查一次,結果在政府去年九月的《施政特寫》找到教青局已向學校提供建議指引的說法,原句便不能再留。發佈前,張Sir也把稿件交給另一個前沿 AI 模型交叉審閱。對方建議收窄內地研究的因果語氣,並把約數換成精確數字,這兩項改動都採用了;其他意見由張Sir逐項決定取捨。
這二十多輪改稿,大部分時間都花在翻原文、核數字。張Sir先有自己的判斷,才知道哪些地方值得追下去。那位九十歲的老教授能找出 AI 的錯,正因為他已經親手把題目推過一遍。
@張Sir的AI養生館 – 學習智人
***
參考資料
人物.(2026年9月15日)。AI正在「懲罰」那些用它寫作業的中學生。人物(微信公眾號)。
香港特別行政區政府教育局.(2026)。中小學數字教育發展藍圖(附篇二:中小學應用人工智能教學指南)。
教育部基礎教育教學指導委員會.(2025)。中小學生成式人工智能使用指南(2025年版)。中國教育和科研計算機網。
張Sir.(2026年2月10日)。AI寫作最大的誤區:你幹了,卻不負「責任」。張Sir的AI養生館。
張Sir.(2026年2月11日)。讓思考看得見:中小學生如何善用 AI 做功課?。張Sir的AI養生館。
張Sir.(2026年7月8日)。會用 AI,不等於有 AI 素養:澳門AI應用調查給教育界的啟示。澳門互聯網研究學會。
新華社.(2025年5月13日)。學生作業考試禁止人工智能「代勞」。新華網。
澳門互聯網研究學會.(2026年7月2日)。解碼生成式人工智能行為。
澳門互聯網研究學會.(2026年7月7日)。生成式AI走入日常:AI素養與新數碼鴻溝成關注焦點。
澳門特別行政區政府.(2025年9月28日)。【施政特寫】推進人工智能全學段教育及社區通識教育 聯動多方協作培育高質素科技人才。
澳門特別行政區政府.(2026年8月28日)。2026/2027學年教育及青年工作措施。
Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. Proceedings of the National Academy of Sciences, 122(26), e2422633122.
OECD. (n.d.). *PISA 2029 media and artificial intelligence literacy*.
OECD & European Commission. (2026). *Empowering learners for the age of AI: An AI literacy framework for primary and secondary education*. OECD Publishing.
Pew Research Center. (2026, February 24). *How teens use and view AI*.
Shaw, S. D., & Nave, G. (2026). *Thinking—fast, slow, and artificial: How AI is reshaping human reasoning and the rise of cognitive surrender* \[Working paper]. The Wharton School, University of Pennsylvania.
Strömberg, D., Lei, V., & Wu, Y. (2026). *The generative AI learning penalty: Evidence from Chinese secondary education* (CEPR Discussion Paper No. 21577). Centre for Economic Policy Research.
by angus | 2026-09-24
從本地部署到全棧數據治理,政府及企業選擇 AI 方案時還要看甚麼
最近內地接連出現兩宗 AI 數據安全事件。第一宗,用戶原以為請求由正在使用的 AI 產品直接處理,卻未必知道數據可能在背後被轉交至另一家公司的模型。第二宗,使用者在本機安裝 AI 編程工具,工具卻在背景建立整個工作區的快照,並嘗試送上雲端。
在這兩宗事件中,用戶都未曾主動將敏感數據提供給任何第三方,數據卻沿着產品預設的路徑流了出去。
兩宗事件,揭示同一條數據鏈
2026 年 9 月,Anthropic 指部分內地 AI 服務把用戶請求轉交 Claude 處理,再將結果返回原有產品。據《香港01》引述報告,部分請求涉及企業代碼、登錄憑證及政府相關數據;有關指控仍須更多獨立證據核實。
同月,內地多家媒體報導,智譜旗下 AI 編程助手 ZCode 被發現會在背景建立本地工作區快照,並嘗試上傳至外部雲端。事件曝光後,智譜移除相關功能、發佈修正版並開源 ZCode,表示相關數據從未用於模型訓練。
兩宗事件指向同一個採購盲點:界面上的品牌名稱,交代不了完整的數據路徑。供應商可能調用第三方模型、雲服務或分包商,客戶端的預設功能也可能擴大數據流向。機構採購的其實是一整條數據處理鏈,模型或界面只是其中一環。
管好內部使用,還要看供應商
政府部門和企業近來都在訂立 AI 使用守則:哪些文件不能上傳、哪些數據要先刪去身份信息、哪些工作要由主管批准,規定愈來愈仔細。內部人員管住了,下一個問題便是:供應商在後台怎樣處理數據,機構看得見嗎?
當前,不少 AI 使用守則首先規範員工,這一步必須做。供應商一端也要有另一張清單:
- 產品實際調用哪一個模型?
- 數據會經過哪些服務器及地區?
- 系統會否連接第三方接口或分包服務?
- 供應商的技術人員能否遠程接觸客戶數據?
- 輸入、輸出及系統日誌會保存多久?
- 數據會否用於模型訓練或產品改進?
- 發生事故後,機構能否取得完整紀錄?
這些問題有些要寫進合約,有些要從系統架構、權限設定及日誌中核實。單靠一句「我們重視數據安全」,回答不了。
本地部署也不會自動安全
把 AI 部署在本地,有助收窄數據流動範圍,但不會自動切斷所有外部連接。服務器即使設於自己的機房,系統仍可能連接外網,應用仍可能取得過大的文件權限,模型也可能透過接口調用外部服務。
本地部署主要回答核心系統和數據存在哪裡,其餘環節仍要逐一管控。一套可管理的 AI 環境,至少要控制外部連接,按職責設定數據權限,限定每個應用可調用的知識範圍,為敏感操作加入審批及人工覆核,並保留模型調用、文件存取及輸出日誌。供應商的運維權限也要有範圍、有時限、有紀錄。
採購前,先要一張數據流向圖
機構評估 AI 供應商,不能只比較模型能力或硬件規格,還要同時檢視模型部署、應用開發、權限治理、日誌及持續運維。每一層由誰提供、由誰負責、出事時由誰追查,都要事先寫清楚。層與層之間一旦留白,發生數據事故時便難以釐清責任。
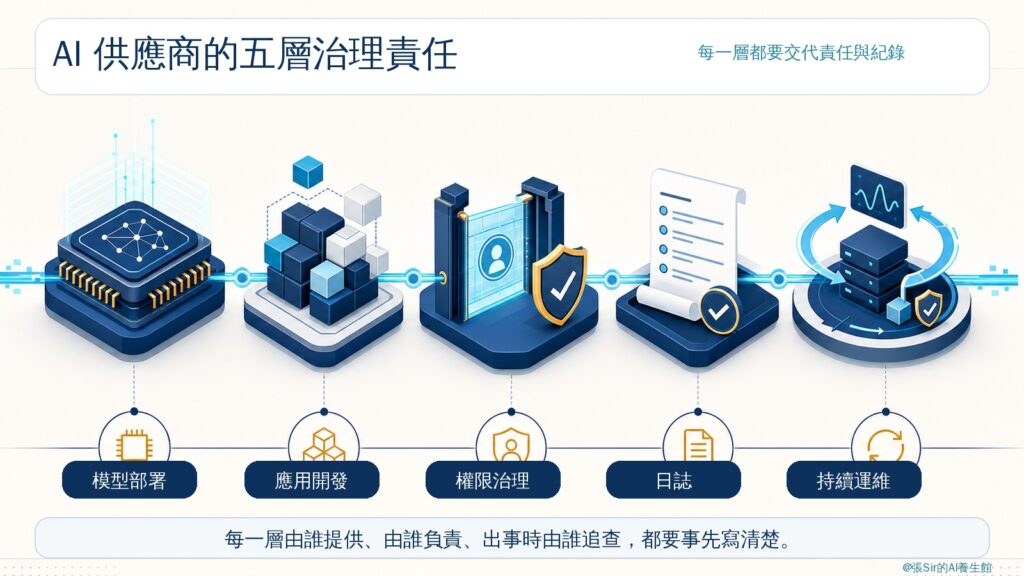
機構可以在採購前要求供應商畫出一張完整的數據流向圖:數據從哪裡進入、經過哪些模型和服務器、誰能接觸、保存多久,以及每一步留下甚麼紀錄。能把這張圖交代清楚,機構才有足夠依據判斷供應商是否可信。
協作者:張Sir與AI
參考資料
香港01。(2026年9月12日)。〈Anthropic指中國AI公司蒸餾攻擊 敏感資料也送交 北京反駁報告〉。
財新網。(2026年9月21日)。〈智譜被指未經用戶允許上傳數據 隨後致歉並開源ZCode〉。
第一財經。(2026年9月21日)。〈智譜完成ZCode開源並整改,承諾相關代碼數據未用於模型訓練〉。
36氪。(2026年9月20日)。〈智譜ZCode傳包風波,那些沒回答的事〉。
by angus | 2026-09-24
同樣是胃酸倒流,丁香泡水好,但未必人人合適
朋友Iris在寫字樓上班,冷氣從早開到晚,午飯常配一杯凍奶茶。飯後不久,喉嚨便湧上一口清稀的酸水,胃部隱隱不適,按住肚子、喝口暖水才舒服些;晚上一躺平,胃酸又往上泛,有幾晚被嗆醒,手腳卻一直是凍的。
前幾篇講喉嚨黏、夜咳,都提過胃酸倒流,不少讀者看完便追問,胃酸倒流可以怎樣從中醫養生入手。我當時隨口答了一句:丁香泡水。Iris的情況偏寒,丁香性溫;若是另一類燒心口苦的人,答案便不同。
胃氣往上走,人就躺不安穩
按中醫理論,胃氣以下降為順。《素問·逆調論》引過一句「胃不和則臥不安」,講的是胃氣不順、往上逆,人便躺不安穩,睡也睡不好。胃酸倒流偏偏在躺平之後最容易發作,嗆咳、燒心一來,睡眠跟着被打斷。
同樣是胃酸往上湧,傳統上常從寒熱兩種傾向理解。偏寒時,較常見清稀酸水、胃部隱隱不適、喜暖怕冷、吃生冷後發作、大便偏稀;偏熱時,較常見燒心、酸水帶苦、口乾口苦,壓力大、熬夜或吃煎炸辛辣後加重,大便偏乾。這些表現可以交叉出現,不能只憑「泛吐清水」或「燒心口苦」其中一項自行判斷。丁香、生薑性溫,偏熱傾向明顯的人喝了,燒心可能更甚。
反覆發作、拖了一段時間的,單靠食療就不夠了。偏寒吐酸水,傳統上常參考《傷寒論》吳茱萸湯,以吳茱萸、人參、生薑、大棗溫中降逆;偏熱燒心,則多用黃連配少量吳茱萸,即《丹溪心法》的左金丸。吳茱萸、黃連都不是日常食材,這類配伍要由執業中醫師辨證開方,不宜自行抓藥試服。下面兩杯茶只作日常調養參考。
偶爾一次燒心很常見,若每星期發作兩次以上,或出現吞嚥困難、吞嚥時疼痛、體重無故下降、嘔血、黑便,應看醫生。胸口灼痛若伴氣促、冒冷汗,或痛向左臂、下巴擴散,可能是心臟問題,要立即求醫。
晚飯與睡覺之間
比起喝哪杯茶,晚飯時間往往影響更大。晚飯與上床之間最好相隔兩至三小時,晚上那一餐吃七分飽。睡覺時把床頭一端墊高10至15厘米,墊床腳或在床褥下放楔形墊都可以;只多疊幾個枕頭,頭抬高了,腰腹反而被摺起來,用處不大。咖啡、酒、朱古力、薄荷、煎炸辛辣和汽水都是常見的觸發食物,各人反應不同,記下自己吃了甚麼之後會發作,比整張清單照單全戒實際。
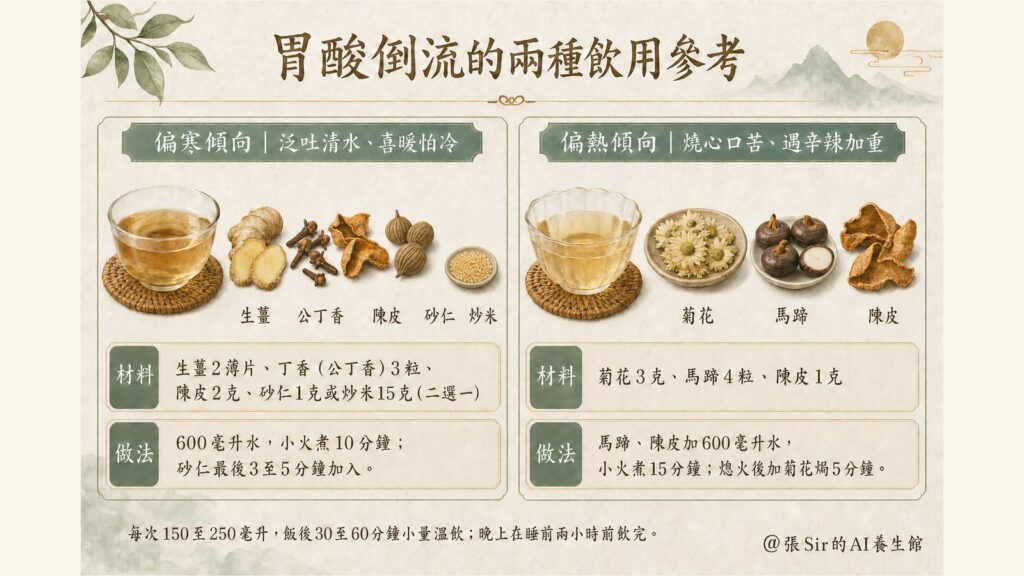
泛吐清水、喜暖怕冷:偏寒傾向的飲用參考
材料:生薑2薄片(溫中止嘔)、丁香(公丁香)3粒(溫中降逆)、陳皮2克(理氣和胃),另加砂仁1克(化濕醒脾,拍碎)或炒米15克(健脾和胃),二選一。
做法:生薑、丁香、陳皮加600毫升清水,煮滾後轉小火煮10分鐘;用砂仁的,拍碎後在最後3至5分鐘才放入,免得香氣煮散;用炒米的,白米以乾鍋小火炒至微黃,與其他材料一同下鍋。濾出溫飲。在辦公室可放入保溫杯,以熱水焗15分鐘,砂仁同樣留到最後5分鐘才加。煮成後按需要分1至2次飲用,每次約150至250毫升,不必勉強飲完;飯後30至60分鐘小量溫飲,晚上如要喝,應在睡前兩小時前飲完。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用。
生薑、丁香溫中降逆,傳統上用於胃寒嘔逆、泛吐清水;陳皮理氣和胃,減少飯後脹悶。砂仁芳香,醒脾化濕,胃脘脹悶明顯時較合用;炒米即廣東人家常用的焦米,取其和胃,廚房隨手可做,茶湯也多一份米香。丁香氣味濃烈,三粒已足夠,放多了口舌會發麻。
加減:胃口差、大便偏稀,加乾淮山10克(健脾止瀉)。
燒心口苦、遇辛辣加重:偏熱傾向的飲用參考
材料:菊花3克(清肝瀉熱)、馬蹄4粒(清熱生津)、陳皮1克(理氣和胃)。
做法:馬蹄去皮洗淨,拍碎,與陳皮加600毫升清水,煮滾後轉小火煮15分鐘,熄火後放入菊花焗5分鐘,濾出溫飲。煮成後按需要分1至2次飲用,每次約150至250毫升,不必勉強飲完;飯後30至60分鐘小量溫飲,晚上如要喝,應在睡前兩小時前飲完。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用。
菊花傳統上用於清肝熱,針對壓力一大、胃就燒起來這一類;馬蹄清熱生津,口乾口苦時較合用;陳皮只放1克,理氣和胃,也免得整杯過涼。
加減:情緒緊繃時發作更明顯,加玫瑰花2朵(疏肝解鬱)。
誰不適合:孕婦、哺乳期人士、兒童、長者、慢性病及長期服藥者,飲用前先問醫生;正在服用胃藥者不要自行停藥。菊花屬菊科,對菊科植物過敏者不宜。偏熱傾向明顯者不喝丁香那杯,偏寒傾向明顯者不喝菊花那杯;飲後燒心加重便停。
兩個穴位
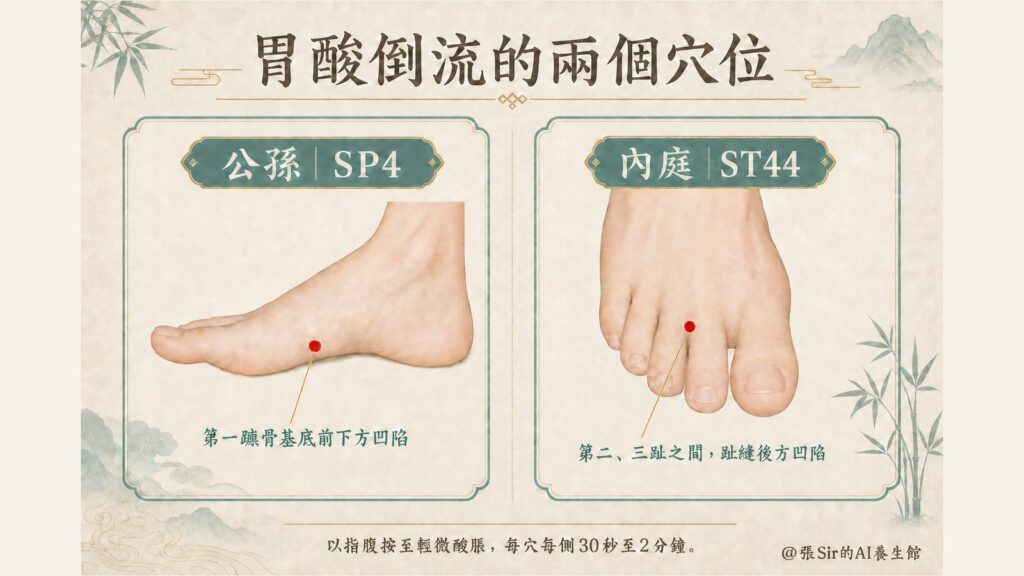
公孫(SP4):腳內側,大腳趾後方那根長骨(第一蹠骨)底端的前下方,腳背與腳底皮膚交界的凹陷處。傳統上用於健脾和胃,偏寒一類較常配用。
內庭(ST44):腳背第二、三趾之間,趾縫後方的凹陷處。傳統上用於清胃熱,燒心口苦一類較常配用。
以指腹按至輕微酸脹即可,每穴每側30秒至2分鐘。飯後一小時內不按,皮膚破損或紅腫處不按。
Iris後來把凍奶茶換成溫水,晚飯提早到七點半,床頭墊高,偏寒那杯喝了幾天,半夜被胃酸嗆醒的次數少了,她自己也說不準是哪一樣起了作用。睡不安穩,胃只是其中一個原因,心、肝、腎各有各的牽連,接下來幾篇會逐一寫。
參考來源
姚春鵬譯注。《黃帝內經》。北京:中華書局,2010。引文見《素問·逆調論》。
National Institute of Diabetes and Digestive and Kidney Diseases. (n.d.). Acid reflux (GER & GERD) in adults. https://www.niddk.nih.gov/health-information/digestive-diseases/acid-reflux-ger-gerd-adults
World Health Organization. (2008). WHO standard acupuncture point locations in the Western Pacific Region. https://iris.who.int/handle/10665/353407
本文提及之人名及情節純屬虛構,內容只作學習參考,不構成任何醫療建議,如有不適請就醫。
協作者:張Sir 與 AI @張Sir的AI養生館 2026
by angus | 2026-09-23
只做判斷、不寫文字的 AI,換題不用重新訓練,答錯了仍要靠人發現
二十多年前,張Sir和團隊開始做內容分析、數據挖掘和輿情分析。研究員先寫好一本編碼簿(codebook,列明每個類目怎樣定義、怎樣判斷的手冊),編碼員對着一疊疊新聞,逐篇回答同一組問題:這篇報道講哪個議題,對涉及的某政府部門是正面、中立還是負面,要不要列入當日重點。答案早就列好,只能選,不能自由發揮。
後來數據多了,人手追不上,便改用機器學習。意圖分類、風險評分、情感分析,做法大同小異。先人工標註幾千條樣本,訓練一個模型,數據丟進去,分個類、打個分數、算個機率,把握大的自動處理,把握小的由人複核。這類分類器在大語言模型出現之前已經遍地都是,在自家服務器上就能跑,毋須上雲。
所以最近看到 Jev 在開發者圈子突然走紅,張Sir第一個反應是有點疑惑,這個概念不是很久以前就有了嗎?近幾年 AI 行業的技術和營銷越來越難分開看,一樣東西走紅,未必等於它是新東西。細看下去,Jev 的做法又確實有幾處跟過去不同。
一個只負責判斷的模型
Jev 是 TypeSafe AI 在2026年9月推出的模型,創辦人 Diogo Almeida 曾在 OpenAI 參與 ChatGPT 背後的研究。官方稱它為 System One Model,名字借自心理學家 Kahneman 對快思考與慢思考的區分。大家熟悉的 GPT、Claude、Gemini 、Deepseek和Kimi等,主要負責生成內容,Jev 不寫文字,只做判斷。一封客服電郵進來,系統要知道的往往只是一個標籤,例如「帳單問題,96%」,然後把信轉給帳務部。Jev 回傳的就是這種東西。
它有三種問法:從幾個選項中選一個,按標準打分,或者判斷一句話成立的機率。每個答案都附一個機率,程序照着決定下一步。有開發者把它形容為一個懂自然語言的 if/switch,也就是程序裡按條件分岔的那幾行語句。官方公佈的速度是每次70至500毫秒,價錢是每百萬輸入 token(模型計算文字量的單位)0.042美元,輸出不收費。
以前難在哪,現在不同在哪
以前做分類,一個任務一個模型。客戶意見分主題、客服信件分流、網上內容審核,這三類張Sir團隊都做了很多年,最花時間的往往不是訓練,是類目一改就要重來。客戶要把一個類目拆細,新議題冒起要加類目,舊類目用久了要合併,這類調整經手過的多不勝數,每一次都要重新標註一批樣本、重新訓練。網上出現一種新的詐騙說法,審核模型也要等新樣本收夠才認得出。
Jev 的做法是在調用時才寫題目和選項。同一個模型,今天用來分客戶意見,明天用來判斷一條帖文是否涉及詐騙,改幾行文字便可以,這一點最值得看。不過這個做法並非 Jev 首創。2019年前後已有零樣本分類(zero-shot classification,不用預先標註、調用時才告訴模型有哪些類別),大語言模型面世後,用提示詞叫它分類更是常見。
以往的零樣本分類模型快而便宜,理解力有限;換成大語言模型,理解力上去了,速度和價錢又成了問題。Jev 想做的,是讓一個專用模型同時具備自然語言理解、低延遲、機率輸出和低價格。它的理解力和機率是否真的較可靠,目前主要只有官方評測,還要等獨立測試。
Jev 引起開發者注意,也跟 AI 系統的用法在變有關。大語言模型出現後,大家一度習慣甚麼都丟給大模型;現在開始有人回頭想,單純的分類、判斷和路由(決定任務由誰處理),也許可以交給更專門、成本更低的模型。AI Agent(能自行分步完成任務的 AI)的流程裡,充滿這類小判斷:下一步用哪個工具,這個結果要不要再查,任務該由哪個模型處理。每一個都叫通用大模型來判斷,往往較慢,也較貴。比較合理的分工,是由 Jev 做分類和判斷,理解、推理和寫作仍由大模型負責,動作則由程序執行。
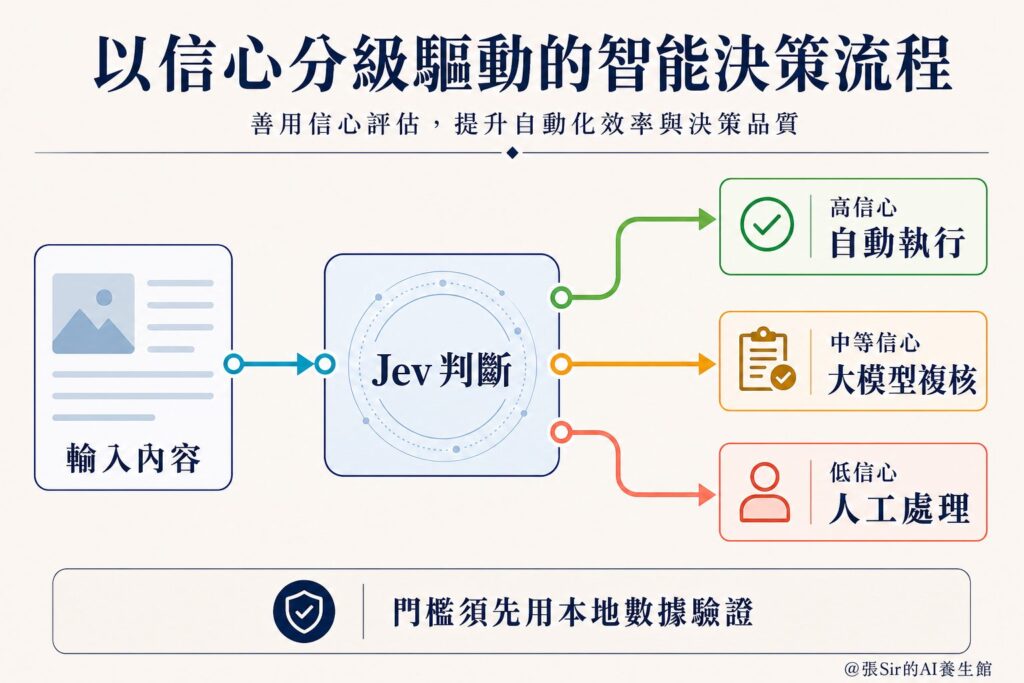
有了機率,分工便有依據。機率高的自動執行,中等的再由大模型判斷,低的轉人工處理。以前團隊也按機率分流,只是在一個模型內部分;現在分流的對象,變成了不同的模型和人。
開源項目 fast-jev-compaction 示範了另一種用法。它讓 Jev 替寫代碼的 AI 助手清理記憶,逐條判斷舊的工具調用和結果還要不要,過時的刪走或截短,留下的一字不改。以往這一步多數由大模型寫摘要,容易漏掉檔案路徑、錯誤訊息這類細節。Jev 不用寫,只判斷甚麼該留、甚麼可以忘。這也帶出一個問題:AI 每一次真的都需要生成文字嗎?
優點和要留神的地方
Jev 快、便宜、輸出格式固定,機率可以直接用來設定自動化的門檻,前提是門檻先用自己的數據驗證過。它的限制同樣要看清楚。Jev 不寫文章、不作解釋,答案範圍要預先定好,題目寫得含糊,結果也會含糊。官方把「不會幻覺」界定為不會產生預設選項以外的答案;答案落在選項之內,選錯仍然可能。做輿情的人都知道,把一條負面帖判成中立,比格式出錯麻煩得多,因為表面上看不出問題。
官方公佈的數字也要打個折扣,首頁那句「快193.6倍、省444.6倍」出自自家設計的測試,官方也承認屬偏高一端;答對與否,是跟兩個大模型的平均答案比,並非由專家核定。完整的模型架構、參數規模、訓練細節和可重現的論文,至今都未公開。繁體中文、粵語和中英夾雜的表現,截至截稿,也未見公開評測。
這幾年 AI 新名詞太多,一個東西剛出來就被捧成未來,過一陣子大家又集體遺忘。所以張Sir現在習慣先等一下,看它解決了哪些以前很難解決的問題,還是把以前就有的東西,用新一代 AI 的方式重做一次。以目前公開的資料,下結論還太早。
檢驗這類模型,可以借用內容分析的老方法
在獨立評測出來之前,機構可以先自己測。換題變得容易,題目出得好不好就更要緊,類目要互斥、要窮盡、邊界要清楚,這是編碼簿的基本功。判斷準不準,要拿人工編碼作標準答案。兩位受過訓練的編碼員先各自判斷同一批樣本,計算彼此的一致程度(業內稱為編碼員間信度);達到要求後,分歧的個案再經討論或由第三人裁決,得出一套人工確認的標準答案(業內稱為金標準),最後拿模型的答案來比較。近日有人拿 Jev 跟大模型分揀同一批新聞,兩邊結果九成四一致,便說 Jev 好用;可是兩邊都沒有跟人工答案核對過,一致不等於正確。
學術界和市場使用內容分析這套方法已有幾十年,工具也現成。有興趣的讀者可參考DiVoMiner 平台,它同時支援人工編碼、AI 編碼和信度測試,不少知名高校的師生都在用。在 Google Scholar 上,可以檢索到不少以它做內容分析的論文,當中不乏 SSCI(社會科學引文索引)期刊。
例如 Chang 等人(2021)比較了內地、香港和台灣十年間三萬多篇中文新聞;Law 等人(2025)收集香港親子論壇 Baby-Kingdom 上一萬七千多條有關中醫的留言,按八個主題的編碼簿,在平台上做情感和語義網絡分析;Zhang 等人(2023)分析網上醫患對話,兩位編碼員在平台上獨立編碼一百段樣本,信度係數達0.86(1代表完全一致)。
同樣的方法也可以核對模型給出的機率。模型說有九成把握的那批答案,實際答對多少,要用本地樣本算過才知道,廠商的整體數字不能直接沿用;類目一改,又要重算一次。繁中、粵語和中英夾雜的本地語料,正是 Jev 還沒有公開評測的部分,用在本地場景之前,這一步省不得。哪些數據可以送出機構做測試,也要先按敏感程度分清楚。
本地知識有多重要,團隊做過一次內部實驗,張Sir在〈當 AI 從個人助手走進企業工作〉介紹過。同一組15宗政務寫作任務,改良版的平均質量分由62.9升至77.5,並由實際用戶並排比較兩個版本。改善主要來自清楚的任務要求、本地知識和人工反饋,單靠換模型做不出來。那次測的是寫作,判斷類的任務,相信道理也相通。
類目用久了也會過期,公司部門改名、新議題冒起,編碼簿和測試樣本都要有人定期更新;模型換了新版本,舊的門檻也要重測。〈政府公文 AI 的第 90 天〉一文談的正是這件事。
Jev 值得一試,試的時候拿自己的數據,挑幾道常見的判斷題,跟人工的答案對一次,心裡便有數。
協作者:張Sir和AI
延伸閱讀:團隊的 TI(Trusted Intelligent)系列,信得過的 AI 應用方案。
參考資料
張Sir(2026年8月21日)。當 AI 從個人助手走進企業工作。張Sir的AI養生館。https://www.anguscheong.net/2026/08/21/ai-agent-enterprise-work/
張Sir(2026年9月2日)。政府公文 AI 的第 90 天。張Sir的AI養生館。https://www.anguscheong.net/2026/09/02/government-document-ai-day-90/
Almeida, D. (2026, September 15). Introducing System One models & Jev. TypeSafe AI. https://typesafe.ai/blog/introducing-system-one-models-and-jev
Chang, A., Schulz, P. J., Jiao, W., & Liu, M. T. (2021). Obesity-related communication in digital Chinese news from Mainland China, Hong Kong, and Taiwan: Automated content analysis. JMIR Public Health and Surveillance, 7(11), e26660. https://doi.org/10.2196/26660
Law, M., Ho, K. H., & Cui, X. (2025). Exploring Hong Kong public attitudes and concerns about traditional Chinese medical treatments: A study on discussion forum responses. International Journal of Pharmaceutical and Healthcare Marketing, 19(3). https://doi.org/10.1108/IJPHM-05-2024-0039
Tran, T. (2026). fast-jev-compaction \[Computer software]. GitHub. https://github.com/tamaratran/fast-jev-compaction
Zhang, W., Zhou, F., & Fei, Y. (2023). Repetitions in online doctor–patient communication: Frequency, functions, and reasons. Patient Education and Counseling, 107, 107565. https://doi.org/10.1016/j.pec.2022.11.007
by angus | 2026-09-21
夜咳口乾可從養陰潤肺入手,心煩難眠還要顧心安神
同事Jessica前陣子連續幾晚睡不好。有時半夜咳醒,喉嚨乾得像砂紙磨過,喝兩口水才能再睡;有時整晚沒有咳,卻躺着胡思亂想,心裡煩,第二天說話也特別容易急。她問我:兩種都算睡不好,是不是喝同一杯安神茶就可以?
按中醫理論,《素問·宣明五氣》講五臟各有所藏,「肺藏魄,心藏神」。魄安,人睡下去才穩,半夜不容易被自己的呼吸驚醒;神安,情緒才定得住。夜裡咳醒,是肺陰不夠,魄不安,道理跟喉嚨卡卡的乾、皮膚起白屑的乾一樣,只是這次在夜裡發作;心煩難眠,是肺陰虛的日子久了,累到心那邊去,神不安,表現成情緒躁、腦子停不下來。
這兩種情況的辨證方向不一樣。單純夜咳口乾,重點還是潤肺;心煩難眠、腦子一直在空轉,重點要顧到心。不過,夜咳、心煩、難眠也常見於鼻敏感、胃酸倒流、更年期、焦慮或其他情緒相關狀況,不能一概歸咎於肺陰不足。
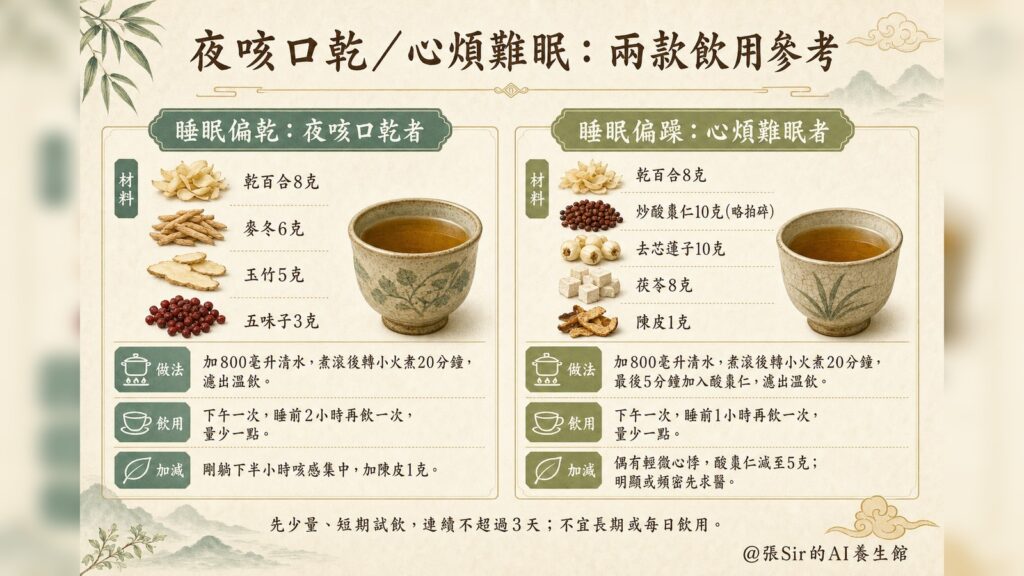
睡眠偏乾:夜咳口乾者的飲用參考
材料:乾百合8克(養陰潤肺)、麥冬6克(養陰生津)、玉竹5克(滋陰潤燥)、五味子3克(斂肺止咳)。
做法:材料略沖洗,加800毫升清水,煮滾後轉小火煮20分鐘,濾出溫飲。以上為一名成人的一日分量:下午一次,睡前2小時再飲一次,量少一點,以免夜尿。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用。
百合麥冬玉竹養陰潤肺,五味子性偏收斂,少量加入有助減少夜裡反覆咳醒。睡前2小時飲用,是讓身體有時間代謝掉多餘水分,不至於半夜起身上廁所反而打斷睡眠。
加減:咳感集中在剛躺下那半小時,加陳皮1克理氣。
睡眠偏躁:心煩難眠者的飲用參考
材料:乾百合8克、炒酸棗仁10克(寧心安神,略拍碎)、去芯蓮子10克(養心安神)、茯苓8克(寧心健脾)、陳皮1克(理氣防滯)。
做法:酸棗仁拍碎備用。其餘材料略沖洗,加800毫升清水,煮滾後轉小火煮20分鐘,最後5分鐘加入酸棗仁,濾出溫飲。以上為一名成人的一日分量:下午一次,睡前1小時再飲一次,量少一點,以免夜尿。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用。
酸棗仁是這杯茶的重點,傳統上用於寧心安神;蓮子、茯苓同樣養心健脾,百合仍然補肺陰,陳皮只放1克,減一減滋膩感。這杯兼顧心肺,著眼於心煩、易怒、腦子停不下來這幾種表現。
加減:平常偶有輕微心悸,減酸棗仁至5克,觀察反應;若心悸明顯或頻密,不宜自行以茶調整,應先求醫。
誰不適合:感冒發燒期間不宜。服用鎮靜類藥物,或正在戒斷、調整藥物劑量者,先問醫生;孕婦、哺乳期人士、兒童、長者、慢性病及長期服藥者也先問醫生。飲後口更乾或心悸加重便停;若伴胸痛或情緒持續低落,應該就醫。
兩個穴位
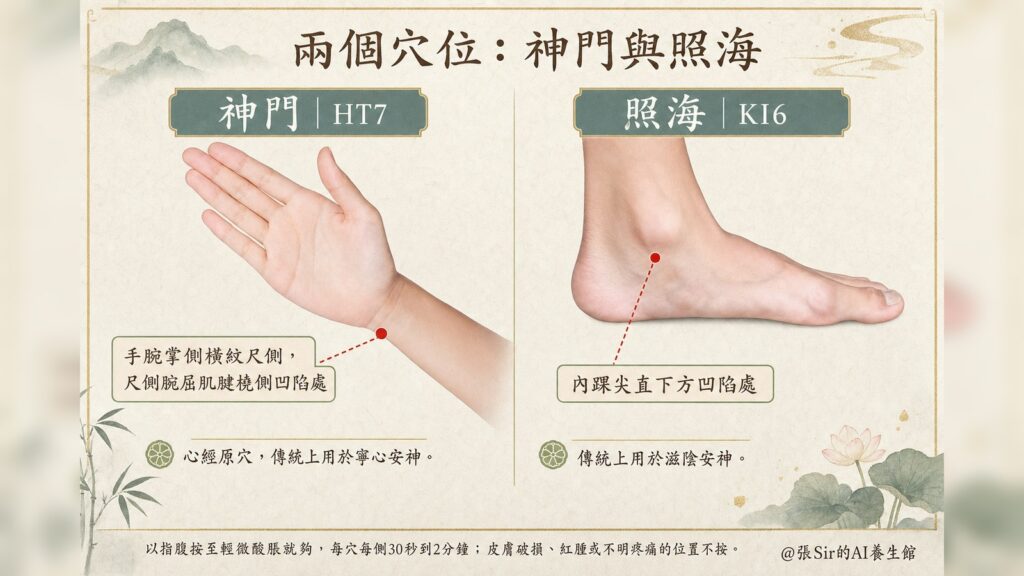
神門(HT7):手腕掌側橫紋尺側,尺側腕屈肌腱橈側凹陷處。傳統上是心經原穴,用於寧心安神。
照海(KI6):內踝尖直下方凹陷處。傳統上用於滋陰安神,陰虛引起的失眠常配這個穴位。
以指腹按至輕微酸脹就夠,每穴每側30秒到2分鐘。皮膚破損、紅腫或不明疼痛的位置不按。
Jessica後來把兩種情況分開記下來:夜咳口乾時,用百合麥冬玉竹那一杯;心煩難眠時,才換成酸棗仁蓮子。兩杯茶各有側重。喉嚨、皮膚、睡覺,這三篇說的其實是同一件事——肺陰不夠,會從不同地方冒出來,認得出是哪一種,才不會喝錯茶。
不過這杯酸棗仁蓮子茶,顧的是跟著肺陰虛一起發作的那種心煩難眠。若心悸、易醒、易受驚嚇這些表現本身就很明顯,不是跟着喉嚨乾、皮膚乾一起來的,背後常常是心自己的問題,食療能打的底有限,接下來想找一篇專門講清楚。晚上睡得好不好,通常還要看肝跟腎——一個管情緒能不能收得住,一個管人躺下去之後,身體是不是真的靜得下來。心、肝、腎,接下來想連着寫幾篇,最後再看它們怎樣互相牽連。Jessica也先不急着找下一杯茶,把哪一晚咳醒、哪一晚只是心煩難眠記下來。睡不好的樣子分清楚了,往後才知道該看哪裡。
參考來源
姚春鵬譯注。《黃帝內經》。北京:中華書局,2010。引文見《素問·宣明五氣》。
World Health Organization. (2008). WHO standard acupuncture point locations in the Western Pacific Region. https://iris.who.int/handle/10665/353407
本文提及之人名及情節純屬虛構,內容只作學習參考,不構成任何醫療建議,如有不適請就醫。
協作者:張Sir 與 AI @張Sir的AI養生館 2026
by angus | 2026-09-20
單純乾燥可從養陰潤燥入手,泛紅痕癢還要辨風、熱與濕
同事Wendy前陣子每次沖完涼,小腿和手臂內側的皮膚總有一層繃緊感,摸上去有點刺。睡前搽了潤膚乳,第二天照樣起白屑,有時甚至甩皮。她說有一晚癢得受不了,抓到微微泛紅,之後那幾天反而更癢,潤膚乳也愈搽愈不舒服。
《素問·六節藏象論》有一句「肺者,氣之本,魄之處也,其華在毛,其充在皮……通於秋氣」,講的是肺與皮毛、秋令的關係。按中醫理論,肺陰不足、津液失於濡養時,皮膚可以出現乾燥、繃緊和脫屑等表現;道理與上一篇《喉嚨卡卡,時黏時乾,怎麼回事》所講的乾有相通之處,只是這次表現在皮膚。下文食養與穴位均依此思路作日常調養參考。
Wendy這兩種表現方向不同。單純乾燥、繃緊和脫屑,可以從養陰潤燥的方向理解;若同時泛紅、灼熱和痕癢,中醫還會考慮兼有風、熱或濕。不過,乾、紅、癢也常見於濕疹或接觸性皮炎。若某款潤膚產品愈搽愈紅、愈癢,先停用該產品,不代表所有保濕都不適合。
日常護理先從沖涼和保濕做起:避免水溫過熱、時間過長,輕輕印乾皮膚後,趁仍微濕時搽上成分簡單、無香料的潤膚品。若皮膚紅腫迅速擴大、滲液、化膿、出現水泡、明顯疼痛或伴發燒,應先求醫。
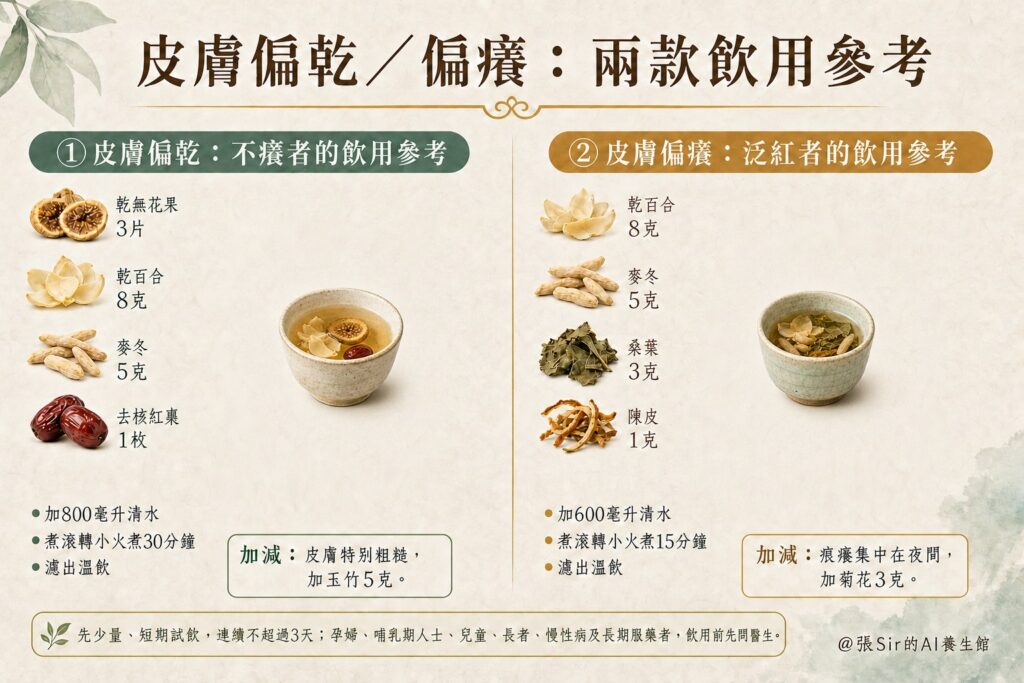
皮膚偏乾:不癢者的飲用參考
材料:乾無花果3片(潤肺利咽,免浸泡)、乾百合8克(養陰潤肺)、麥冬5克(養陰生津)、紅棗1枚(去核,調味)。如有時間,也可以用乾銀耳5克(滋陰潤燥)代替無花果,但銀耳要先泡發,辦公室養生壺處理不太方便。
做法:無花果沖洗後對半切開,其餘材料略沖洗,加800毫升清水,煮滾後轉小火煮30分鐘,濾出溫飲。改用銀耳的做法:銀耳先浸泡2小時至軟化,撕成小塊,其餘步驟相同,煮40分鐘至銀耳略帶黏稠即可,銀耳可連湯食用。以上為一名成人的一日分量,分兩次飲用。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用。
無花果、百合和麥冬取養陰潤燥、生津的方向,紅棗只放一枚調味,不追求甜度。大便偏軟的人宜少量試飲,任何版本飲後若腹瀉加重便停。
加減:皮膚特別粗糙,加玉竹5克(養陰生津)。
皮膚偏癢:泛紅者的飲用參考
材料:乾百合8克、麥冬5克、桑葉3克(疏風清熱)、陳皮1克(理氣防滯)。
做法:材料略沖洗,加600毫升清水,煮滾後轉小火煮15分鐘,濾出溫飲。以上為一名成人的一日分量,分兩次飲用。
試飲:先少量、短期試飲,連續不超過3天觀察反應,不加糖,也不宜長期或每日飲用。
百合和麥冬取養陰潤燥之意;桑葉偏於疏風清熱、清肺潤燥,陳皮則取少量理氣防滯之意。
加減:痕癢集中在夜間,加菊花3克(疏風清熱)。
誰不適合:孕婦、哺乳期人士、兒童、長者、慢性病及長期服藥者,飲用前先問醫生、中醫師或藥師;飲後不適便停。腎功能不全、需限鉀或服用華法林等抗凝血藥者,無花果版本先問專業人士。控糖者計入全日碳水;易腹瀉、胃寒者減量減頻。
兩個穴位
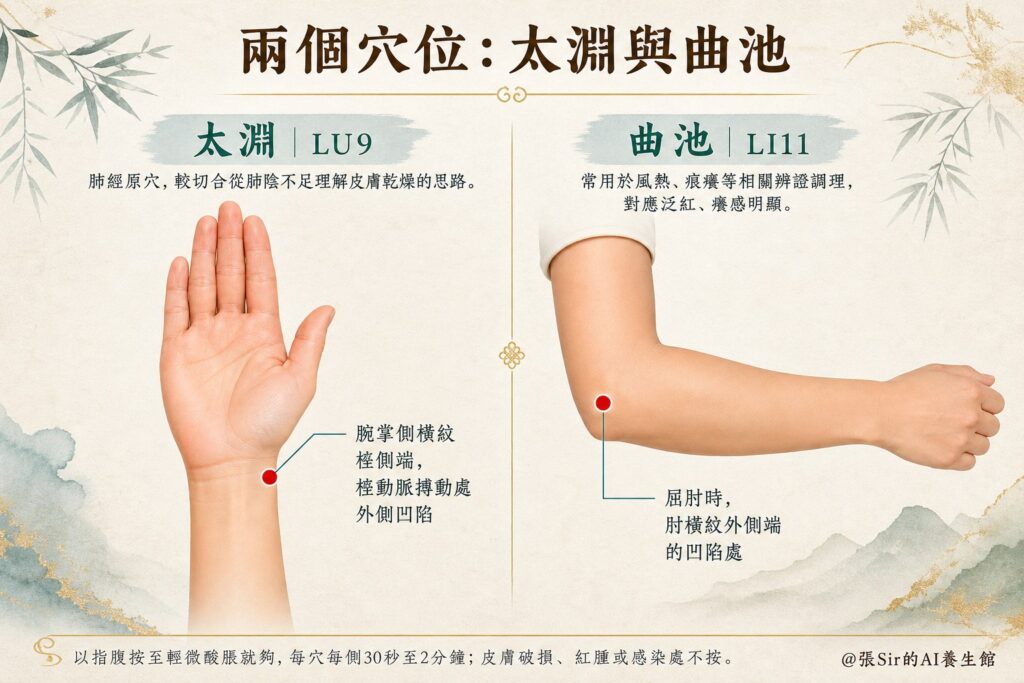
太淵(LU9):手腕掌側橫紋橈側端,在橈動脈搏動處外側的凹陷。太淵是肺經原穴,較切合這篇從肺陰不足理解皮膚乾燥的思路。
曲池(LI11):屈肘時,肘橫紋外側端的凹陷處。曲池常用於風熱、痕癢等相關辨證調理,對應泛紅、癢感明顯這一路。
以指腹按至輕微酸脹就夠,每穴每側30秒至2分鐘。皮膚破損、紅腫或感染處不按。
Wendy試了一輪,把單純乾燥和泛紅痕癢分開處理,也調整了沖涼和潤膚習慣。她說脫屑和抓損少了。上一篇的喉嚨,這一篇的皮膚,都可從肺陰不足、失於濡養去理解;下一篇再看看,同一個問題還可能怎樣影響夜間睡眠。
參考來源
姚春鵬譯注。《黃帝內經》。北京:中華書局,2010。引文見《素問·六節藏象論》。
World Health Organization. (2008). WHO standard acupuncture point locations in the Western Pacific Region. https://iris.who.int/handle/10665/353407
本文提及之人名及關係純屬虛構,內容只作學習參考,不構成任何醫療建議,如有不適請就醫。
協作者:張Sir 與 AI @張Sir的AI養生館 2026
by angus | 2026-09-19
早上黏、下午乾是兩回事,一味去潤,黏的那邊可能更黏
朋友Angela最近總在上課前清兩下喉嚨。早上起床,喉嚨黏著一層,吞口水像卡了甚麼;到下午三四點,冷氣吹得久,喉嚨轉成又乾又癢,含著喉糖也頂不了多久。她問我,是不是要開始「潤肺」了。
白露已過,身邊不少人跟Angela一樣,第一件事就是想潤肺。只是同一把喉嚨,早上黏、下午乾,未必適合用同一種方法處理;沒有分清楚就一味滋潤,有些人反而會覺得更黏膩。《黃帝內經》病機十九條有一句「諸氣膹鬱,皆屬於肺」,中醫可從肺氣宣降失常理解胸悶、氣促等表現;脾胃運化不佳而水濕停聚時,也可能出現痰多、喉中黏滯。至於下午乾癢、痰少、說話後聲沙,中醫則常從津液不足、肺失濡潤考慮。
港澳雖漸入秋,仍然炎熱有雨,喉嚨不適未必全由季節引起。冷氣房濕度偏低、飲水不足和長時間說話,都可能加重乾癢;早上黏痰也可能與鼻敏感、鼻涕倒流、胃酸倒流、感染或其他呼吸道問題有關。若症狀反覆或原因不明,應由醫生評估。
下文茶飲及穴位均按中醫理論作日常調養參考。
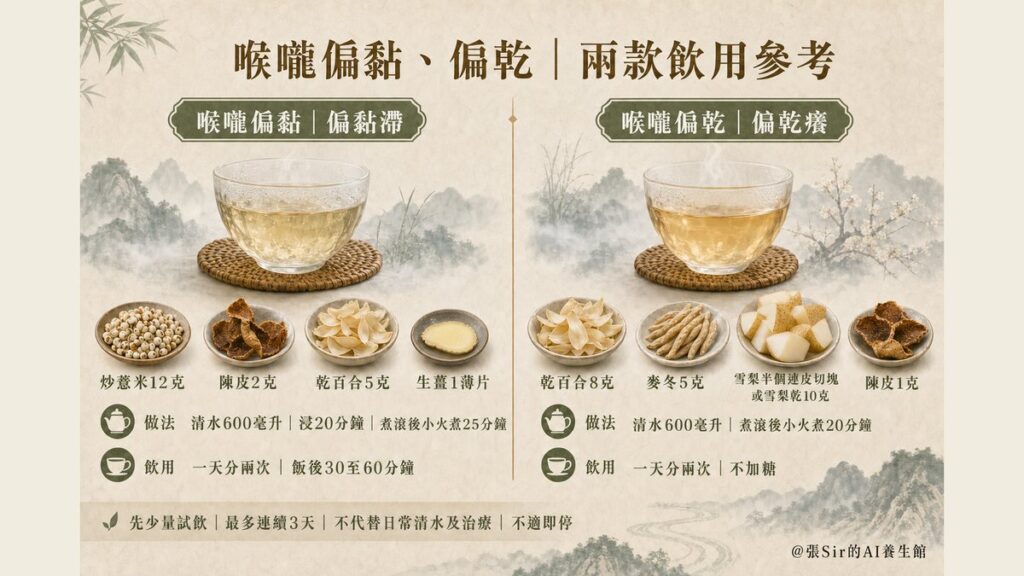
喉嚨偏黏:偏黏滯者的飲用參考
以下按當下偏黏或偏乾的表現區分,不是單憑早上或下午選茶。
材料:炒薏米12克(健脾滲濕)、陳皮2克(理氣化痰)、乾百合5克(養陰潤肺)、生薑1薄片(溫中和胃)。
做法:材料略沖洗,加600毫升清水浸20分鐘,煮滾後轉小火煮25分鐘,濾出溫飲。一劑供一名成人一天分兩次,飯後30至60分鐘飲用。
試飲:先少量、短期試飲,連續不超過3天觀察反應;即使感覺合適,也不宜長期或每日飲用,不代替日常清水,也不代替治療。
這一杯茶以炒薏米和陳皮打底,取健脾滲濕、理氣化痰的用意;百合只放5克,照顧黏中帶乾的情況;生薑一薄片則取溫中和胃、調和偏涼材料之意。
喉嚨偏乾:偏乾癢者的飲用參考
材料:乾百合8克、麥冬5克(養陰生津)、雪梨半個(連皮切塊,生津)或雪梨乾(雪梨片)10克、陳皮1克。
做法:如用鮮雪梨,洗淨、去芯去籽,連皮切塊;如用雪梨乾,不用額外處理。材料略沖洗,加600毫升清水,煮滾後轉小火煮20分鐘,濾出溫飲。一劑供一名成人一天分兩次。
試飲:先少量、短期試飲,連續不超過3天觀察反應,不加糖,也不宜長期或每日飲用。
百合和麥冬取養陰潤燥之意,較切合乾癢、痰少、說話後聲沙等表現。雪梨連皮同煮,帶一點自然甜味,不用另外加糖;辦公室不方便準備鮮果,也可換成無加糖的雪梨乾。陳皮只放1克,取少量理氣防滯之意。
誰不適合:孕婦、哺乳期人士、兒童、長者、慢性病及長期服藥者,飲用前先問醫生、中醫師或藥師;發燒、腹瀉或胃口很差時先停飲。飲後不適便停;若呼吸困難,立即求醫。吞嚥困難、痰帶血、胸痛,或咳嗽、聲沙超過兩星期,也應就醫。
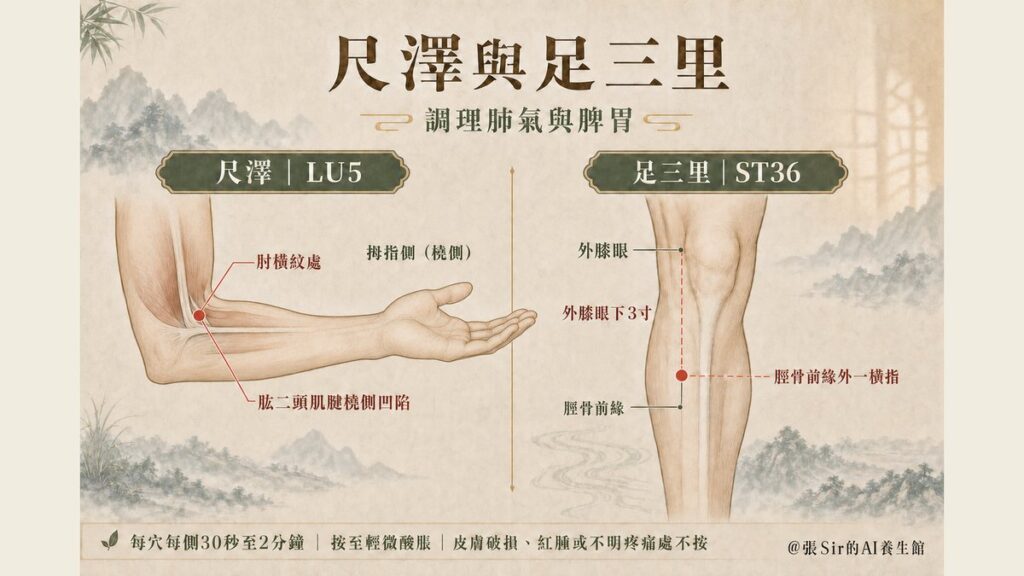
兩個穴位
尺澤(LU5):手肘微彎,肘橫紋處、肱二頭肌腱橈側緣的凹陷。按中醫傳統,此穴常用於肺系相關表現的辨證調理。
足三里(ST36):外膝眼下約四橫指,以本人手指寬度估算,位於脛骨前緣外一橫指。按中醫傳統,此穴常用於脾胃相關表現的辨證調理。
以指腹按至輕微酸脹就夠,每穴每側30秒至2分鐘。皮膚破損、紅腫或不明疼痛的位置不按。
Angela試了幾天,除了按不同感覺選擇飲品,也增加日常飲水、減少長時間說話,喉嚨不適慢慢減少。喉嚨黏與乾只是症狀,先分清楚情況,比一律「潤肺」更重要。接下來再看看,中醫所說的肺陰不足,還可能怎樣表現在皮膚。
參考來源
姚春鵬譯注。《黃帝內經》。北京:中華書局,2010。引文見《素問.至真要大論》。
World Health Organization. (2008). WHO standard acupuncture point locations in the Western Pacific Region. https://iris.who.int/handle/10665/353407
本文內容只作學習參考,不構成任何醫療建議,如有不適請就醫。
協作者:張Sir與AI @張Sir的AI養生館 2026
by angus | 2026-09-19
AI 套語和句式都改過,全文為甚麼仍然不像自己寫的
刪掉「不是……而是……」和幾種變體,我把稿子再交給同事看。他看完仍然只說:「讀起來有點怪。」具體哪一句有問題,他一時講不出來,只覺得這篇文章不像我平常的文字。
上一篇結尾提到三類問題,包括句式套路、慣用套語和寫作旁白,當時預告下一篇會逐句檢查。這三類問題依然存在,現在的處理方式卻有所不同。之前主要靠禁用清單逐個搜,目前的大模型已能在篇幅合適時讀完整篇文章,再按照人工確認過的案例,找出字面不同、寫法相近的句子。
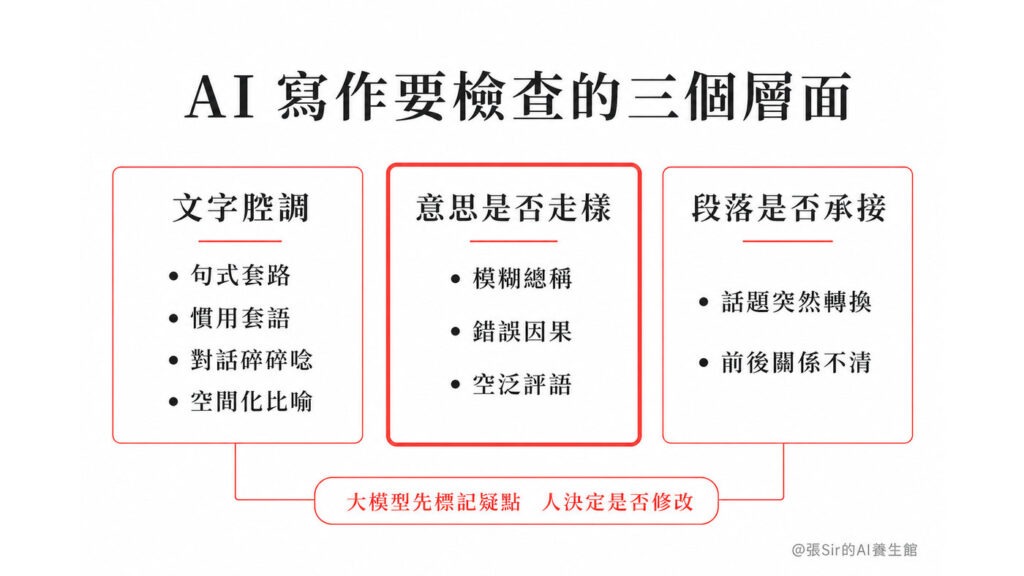
第一類是句式套路
「不是 A,而是 B」仍是最先要看的句式,因為它正是上一篇和本篇標題所追問的問題。「A 沒有錯,只是 B」和「問題不在 A,關鍵在 B」只是換了連接詞,寫法沒有改變。比如「問題不在 AI 能力,而在作者判斷」,便把兩個可能同時存在的問題寫成二選一;直接改成「AI 可能漏判或誤判,作者也要決定哪些修改可以接受」,意思更準確。
「真正的 X,從來不是 Y」和「你以為 A,其實是 B」也屬於同一家族,前者替讀者重新定義,後者先替讀者安排一個想法,再用「其實」翻轉。大模型可以先找出結構相近的句子,人再判斷兩邊有沒有根據。作者真的在記錄自己前後認知的改變,可以保留「原以為……後來發現……」;替讀者預設想法的句子,直接寫結論通常更自然。
第二類是慣用套語
再看套語,「值得注意的是」、「總體而言」等說法在字面上最容易認出。以「值得注意的是,登入流程仍然相當繁複」為例,刪掉開頭幾個字,後半句依然沒有說明登入究竟麻煩在哪裡。在報告類協作裡,假如資料寫明登入要經過三個頁面,第二頁還要重新輸入帳號,直接把這些情況寫出來便夠了。
把禁用清單、作者過去的文章和人工確認過的改稿案例交給大模型,它可以標記清單內的套語,也能找出「值得一提」、「整體來看」等近義變體。審稿結果要列出原句和位置,方便作者逐項確認。
第三類是對話碎碎唸
上一篇暫時把第三類叫作「寫作旁白」,更準確的說法是人機對話殘留(或碎碎唸)。跟 AI 對話時,「你說得對,剛才我忽略了一條規則」、「我會先檢查全文,再給你修改版」、「審核通過,可以發表」都是正常回應。這些話若原封不動出現在文章裡,讀者看到的便只是作者和 AI 的後台對話。
「審核通過,可以發表」可以直接刪掉;「你說得對,剛才我忽略了段落承接」若包含有用信息,可以改成「早期稿由套語直接轉到概念命名,兩段缺少承接」。對話裡的確認、道歉、工作安排和進度報告,都要先判斷有沒有正文需要的內容,再決定刪除或改寫。
前三類主要讓文字帶上容易辨認的 AI 腔調,逐段往下讀,還會遇到四個更深的問題:一個總稱代替幾件不同的事、空間化比喻反覆出現、並列資料被寫成因果,以及評語沒有增加內容。
「使用門檻」代替了三個不同問題
假設一份企業稿同時提到培訓不足、審批權限不清和舊數據搬不過去,AI 卻把三個問題一律稱為「使用門檻」。後續分析繼續使用這個總稱,沒有再說明每個問題的原因和做法。讀者因而無法知道公司應該補培訓、釐清審批權限,還是安排數據遷移。
幾種情況可以同屬一個大概念,但原因和處理方法不同,分析時便要逐項交代。「使用門檻」這個總稱如令這些差異消失,便不應代替具體名稱。
生活裡也有相同情況,例如小朋友晚飯後不肯做功課,可能是看不懂題目、太累,或者只想玩手機。AI 若一律寫成「學習動機不足」,家長看完仍然不知道要先講解題目、讓孩子休息,還是收起手機。總稱省了幾個字,三件事的處理方法也跟着不見了。
空間化比喻用成了固定腔調
另一個一直被漏掉的習慣,是用空間動詞描寫抽象的東西,例如「信號散在句子之間」、「問題落在字面上」、「意思藏在細節裡」。這類空間化比喻偶爾使用沒有問題,反覆出現時,文章便會帶着同一種腔調,像是每個抽象概念都有一個位置。
我自己在寫這篇稿子時就中招。
回查「散在」、「落在」、「藏在」、「放進」、「擺在」、「飄在」六組空間動詞,上一篇發布版和本篇初稿共有七次實際用例,三次已出現在上一篇。這次修改經過多輪核稿仍有殘留,說明我們沒有在一輪檢查中改乾淨。
並列功能被寫成因果
假設一份產品報告的材料只列出手機審批、統一文件格式和保留操作記錄三項功能,AI 卻寫成:「手機審批省下時間,團隊便有餘力統一文件;格式統一之後,操作記錄自然也更完整。」材料沒有說前一項會造成後一項,這段因果關係是 AI 寫稿時加上去的。
研究報告、政策分析或產品文件的核稿,還要逐句對照原始材料。先確認材料談的是同一對象和同一時段,再檢查它是否真的說明前一件事造成後一件事。材料只說兩者相關,文章也只能寫成相關;只列出幾項功能,便按並列方式寫。
「很實在」沒有增加內容
這次審稿多次遇到「原因很實在」、「說法很直接」、「做法很到位」、「邏輯很清晰」和「這一點很關鍵」等句子。這類「很+評價詞」幾乎可以接在任何題目後面,聽起來像已經下了結論,實際只告訴讀者作者的態度,沒有增加判斷標準或新內容,也容易因為句子通順而被放過。
文章寫完「這個做法不需要額外添置設備」,若隨即再加一句「這個建議很實在」,後一句便可以刪掉。即使後面附有理由,也通常只需保留理由,例如直接寫「現有電腦已經能運行,不用再批一筆設備預算」。報告材料沒有交代成本或工作影響,便標記為待查,不要讓 AI 自行補寫。核稿時看到「很實在」、「很直接」、「很到位」、「很清晰」、「很有意思」,可以先拿掉評語再讀一次;意思沒有減少,便不用放回去。
上面四類問題大多在一段之內已能看出端倪,其中因果是否有根據,還要對照原始材料。另一些問題則要把相鄰幾段連起來讀才看得出來。
單段沒有語病,段落之間卻缺少承接
這篇文章的早期版本曾幾次突然轉題,上一段談固定套語,下一段直接改談概念命名,沒有說明兩者都會以簡略說法代替具體內容。其後談到比喻和檢查步驟時,也沒有交代它們跟前文有甚麼關係。
「接下來看看」本身是正常的文章過渡語;若前後兩段有實質關係,仍要把關係說清楚。例如,把固定套語清單交給大模型,它可以先標記命中位置;同一名稱在前後句是否仍指同一件事,則要比較上下文。這樣才能說明文章為甚麼由套語轉去概念檢查。
大模型可以先概括每段實際說了甚麼,再比較相鄰兩段是否談同一問題,以及後一段是在補充證據,還是轉到新問題。兩段如果聲稱前後相承,讀者卻看不出中間關係,便要重寫段首、補足關係,或調整段落次序;文章合理轉入另一個新問題時,不必勉強替兩段補上因果。
寫完後,讓大模型通讀一次
一般寫稿可以先把全文、禁用清單和幾個已確認的改稿例子交給大模型,請它列出可疑句子的原文和位置,說明問題,再提出改法。需要比較個人語氣時,才補充自己過去的文章;研究報告或產品文件則另附原始材料,涉及事實和因果的修改仍要由人核對。
大模型列出的結果不等於定稿。作者要逐項決定問題是否成立,改句有沒有偏離原意,以及自己的用詞和語氣是否被改掉。這篇文章由我一個人和AI協作去寫,一句話是否保留,可以按個人判斷決定;換成十幾個人一起寫,便要說清楚修改理由和共同標準。機構團隊怎樣記錄這些判斷,讓各人按同一準則核稿,會是下一篇要處理的問題。
協作者:張Sir和AI
後記
這篇文章先後跟模型 C 和模型 G 協作,按現有文件和兩邊復盤,至少經過十五個主要版本、超過四十輪討論和逐段修改。這次來回特別多,因為我們一邊改文章,一邊建立審稿規則,不代表每篇稿都要經過相同輪數。後幾個版本花的時間更多,主要用來判斷哪些建議可以接受,以及改句有沒有偏離張Sir原來的意思和語氣。
整個協作中最重要的一次衝突,發生在「我自己在寫這篇稿子時就中招。」這句。張Sir認為它是整段的精華,模型 G 卻因為這句命中「不要用短句替整段定調」的規則,擅自改成較平滑的長句。張Sir要求恢復原句後,模型 G 這樣回答:
因為我把「避免段首短句」這條規則放在你的明確取捨之上,擅自把原句改成較平滑的版本。這是錯的。規則服務作者,不能反過來磨掉作者認為最有力的一句。
這次衝突說明,大模型可以讀規則,執行時仍會漏;交叉審讀不能取代作者判斷;規則寫進文件,也不代表每次都會真正執行。這段坦白後來被放在張Sir的通用審稿規則文件的開頭,成為最高原則。AI 能加快起稿和初步審讀,最後的取捨仍由人負責;每次接受或拒絕修改的理由保存下來,下一次才有可靠案例可以參考。
by angus | 2026-09-12
跟 AI 協作寫專欄大半年,這句話總是揮之不去
「不是……而是……」,大概是最容易被認出來的 AI 句型。隨便打開一篇疑似 AI 寫的稿子,十有八九能找到它的變體。張Sir大半年前開始用 AI 協作寫專欄,第一批稿子幾乎每段都有這個句型。一路加規則、加禁用詞清單,AI 味確實淡了不少,它卻換了幾種說法繼續出現。有個朋友讀出了規律,開玩笑說,只要看到先肯定、再轉折的句子,他就知道是 AI 寫的,懶得往下看。
這條句式早就寫進我的AI味禁用清單,提醒也重複了不止一次。清單管用的話,它理應絕跡,結果只是換個樣子又冒出來——「這個方向沒有錯,只是……」「出發點是好的,但是……」,跟「不是……而是……」骨架不同,家族相同:先擺一個說法,再用另一個說法換掉或推翻,都是靠對照或否定往下推進。
一整個家族的毛病,一條規則管不住。要弄清楚為甚麼,得往下鑽一層,看看 AI 到底怎樣生成一句話。
AI 每次只往下接一個字詞
生成式 AI 背後的大語言模型(LLM),靠一套叫「自回歸生成」的機制寫東西。它根據前面已經出現的文字,算出下一個候選字詞的機率分佈,再從中挑一個接下去。技術上,這個字詞單位叫 token,可能是一個字、一個詞的一部分,也可能是標點。為了方便理解,下面姑且稱作「字詞」。
挑法可以調整。有時直接選機率最高的,有時按機率抽樣,所以同一句話重新生成一次,字詞未必相同。不過,基本動作沒有變:挑完一個,把它連同前文再送進模型,計算下一個;下一個出來,再算下一個,一路寫到句子結束。
拿一句最基本的話走一遍,便看得更清楚。要它寫一句以「今天」開頭的話,接下來大概率會談「天氣」,很少突然跳到「香蕉」,因為在這個語境下,前者的機率高得多。寫到「今天天氣」,下一步很可能出現「很好」「不錯」「有點悶」這類詞,不會無緣無故轉去「發射衛星」。每一步都看着前面已經寫出的字詞,從機率分佈裡再挑一個。
這個例子當然簡化了實際運算,但有一點很重要:模型眼前最直接的路,往往是過去文字中走過很多次的路。前文一旦把方向帶到某個位置,後面的候選字詞也會跟着改變。
同一套機制,也可能把它帶回「先肯定、再轉折」這條老路。要它評一份會議紀要,普通寫法可能直接指出漏了甚麼;一旦要求「講得深入一點」,它可能先寫「這份紀要」。前文有「深入」這個要求,「記錄得」「寫得」這類評價詞便可能更容易出現,句子於是走到「這份紀要記錄得算清楚」。肯定鋪好了,後面也容易接上「問題是」「不過」「真正欠缺的是」。
最後出來的,便可能是:「這份紀要記錄得算清楚,問題是,它沒有交代誰負責跟進。」讀者看到的是完整句式;模型輸出時,字詞仍是一個接一個落下。這段示範只用來說明前文怎樣影響後面的選擇,並非模型後台的逐字實錄,也不能證明它事前完全沒有佈局。無論內部有沒有局部計劃,輸出仍按字詞順序生成。
這條路徑的一個來源,很可能是語料中常見的搭配;模型的後期訓練也可能把它進一步強化。許多模型在訓練後期會加入人類偏好資料;周全、有分寸、兼顧正反的答案,通常較容易得到肯定,模型因而可能更傾向採用先肯定、再轉折的寫法。這是一個合理推測,目前還不能當成已被單獨驗證的直接成因。
禁掉「問題是」只能避開一個詞,改不了整體偏好。它換成「不過」「然而」「真正關鍵在於」,一樣可以走完整個結構。語料中的常見搭配,加上後期訓練可能帶來的偏好,兩股力量很可能疊在一起。即使生成時帶有隨機性,這種句式仍會反覆出現。
模型也並非完全沒有提前佈局。Lindsey 等人(2025)研究 Claude 3.5 Haiku 的內部運算時,發現它寫押韻詩句之前,可能已在準備句尾的候選押韻字。這些候選字還會反過來影響整句怎樣鋪排;研究人員改動相關內部特徵後,模型甚至會重組句子,走向另一個句尾。
這項發現提醒我們,「模型只會想到一個字才算下一個」說得太死。它可以做局部預先佈局,但這跟人先形成一個較完整的意思,再挑詞落筆,仍有差別。研究觀察到的是特定模型、特定任務下的內部路徑,也不能直接推成所有模型、所有寫作都會如此。
另一個差別,是模型在同一次生成裡只能往前走,已經輸出的字詞不能回頭撤銷。有人會問,叫它重寫一遍,不就等於回頭改了嗎?重寫仍是把原文和新指令當成前文,從頭再算一遍。人改稿則會停在某一句,對照前後意思,換一個詞、挪一個位置,再回頭看整段是否成立。兩個過程看起來都產生了新版本,走法並不相同。
禁用詞清單再詳細,也補不上這個差距。它可以改變下一個字詞的機率,卻沒有替模型加上一位會停筆、回看、猶豫和取捨的編輯。
叫它自查,其實是再寫一次
模型缺少這種人類式的預先構思和回看修訂。叫它檢查一遍剛寫的東西,指令連同原文會一起變成新的前文,它再接着往下算,生成一段評語。這跟人回頭核對「我剛才為甚麼這樣寫」,是兩件事。
舉個更貼近日常的例子。兩公婆吵完架,誰都不先開口,各自滑手機,晚飯也沒吃。這是人會寫的句子。AI 常常會把它改成:「兩人的沉默,映照的是彼此在情緒表達上的落差。」
叫它檢查「映照」這句順不順,它會怎樣做?它會把原文、檢查指令和前後語境一起重新處理,再生成一段評語。模型可能從語義、上下文關係和過往見過的寫法中,判斷「映照」過於書面,或者「情緒表達上的落差」離生活太遠。類似句子曾經怎樣被批評和改寫,也會成為判斷線索,但不等於它只看句子的表面長相。
這個判斷多數時候是準的。準確的來源,包括模型對語義和上下文的內部表徵,也包括大量文字中累積下來的統計規律。判斷得準,不代表它以人的方式讀懂了你,更不表示它能回到第一次生成時,完整追查自己為甚麼選了「映照」。
這也解釋了,為甚麼「請再檢查一次」有時有效,有時原地打轉。新一輪生成可能剛好走到較自然的路,也可能換掉一個詞,保留原來那副骨架;甚至會把「不是……而是……」改成「問題不在……關鍵在……」,表面不同,熟悉的味道仍在。
把規則清單放進提示詞,它會成為模型生成時的上下文。系統指令、用戶要求和正文通常帶有不同角色與位置,對輸出的影響也不一定相同;不過,規則本身仍然是一項文字指示,沒有程式過濾器那種逐字攔截的強制力。規則寫得越抽象,「行文要自然」這五個字能提供的線索越少。模型知道這是一項要求,卻未必知道你口中的「自然」究竟長甚麼樣。
一句具體的「原句這樣寫,後來改成這樣」,情況便不同。前後兩句直接把差異擺出來:哪個抽象名詞被拿掉,哪個評論句改成生活動作,哪個轉折被拆開。模型可以在眼前模仿這些變化,效果通常比再加一句「不要有 AI 味」實在得多。
清單只能抓到看得見的 AI 味
AI 味大致可分成三類,清單對它們的作用並不一樣。

第一類:詞語/套語痕跡。「值得注意的是」「總體而言」「原因很簡單,也很現實」這類固定說法,逐字搜尋便能找到,是清單最容易處理的部分。這些話單獨出現沒有問題;同一篇文章密集而規律地重複,AI 味才會冒出來。
詞語清單的好處是明確。搜到「總體而言」,可以直接判斷要留、要改還是要刪。問題也在這裡:處理得太順手,很容易讓人把全部注意力放在幾個顯眼的詞上,以為換掉它們,文章便乾淨了。
第二類:句式套路 。前面「先肯定、再轉折」便屬於這一類。它不靠某個詞存在,靠的是一整套組合方式。「不是 A,而是 B」「A 沒有錯,只是 B」「問題不在 A,關鍵在 B」,字面各有不同,推進方法幾乎一樣。
逐字比對抓不到這一類,只能靠人細讀。讀的人能否察覺整段文章總在先擺一邊、再推向另一邊,決定了這個套路會不會被抓出來。同一份禁用清單交給不同的人核稿,結果差很遠,原因就在這裡。
第三類:寫作旁白。「這一段要處理的問題是」「接下來我們將深入探討」「以下分三點說明」這類話,全在談文章準備怎樣寫,沒有繼續講事情本身。偶爾一句可以帶路,句句都替讀者報幕,文章便像有人站在旁邊不停解說。
三類問題混在一份規範裡,詞語/套語和寫作旁白較容易辨認,清乾淨後,人便可能以為整份稿子都乾淨了。句式套路原封不動,讀起來還是怪,只是一時說不出怪在哪裡。
句式套路帶來的代價,也不只是一點彆扭。讀者說不出哪裡不對,第一反應往往是懷疑「這篇是不是敷衍了事」,作者的可信度跟着打折。放大到整個內容生態,越來越多人用同一批模型工具寫東西,如果都停在詞語/套語清單這一步,大量內容便會共享相近的句式框架,寫作原本該有的聲音差異,也會慢慢被磨平。
提供範例,比再加規則有用
句式套路不能靠逐字比對清走,具體例子卻能把差異直接放到模型眼前。前面的兩公婆,便可以存成一組對照:
改前:兩人的沉默,映照的是彼此在情緒表達上的落差。改後:兩公婆吵完架,誰都不先開口,各自滑手機,晚飯也沒吃。
「不要抽象」「寫得自然一點」只是要求;這組例子則把改法攤了出來:拿掉「映照」「情緒表達」「落差」,換成不開口、滑手機、沒吃飯三個看得見的動作。模型未必知道你怎樣定義「自然」,卻能模仿這個改動方向。
挑一句上次寫得生硬的話,連同改法一起存起來,攢到十幾條,再交給模型作範例,通常比累積幾十條抽象規則管用。例子也要持續更新;同一批改法反覆放進提示詞,模型可能受範例制約,把新句式套成另一種固定格式。這是目前處理句式套路最實用的辦法之一,仍然需要人一路看、一路換。
這也是【學習智人】常說的雙向筆記:把自己讀出的「哪裡怪」記下來,反過來餵給 AI。人負責判斷和取捨,AI 根據具體對照再試一次;下一次哪裡仍然生硬,又變成人的新筆記。兩邊的工作接起來,協作才會真的向前走。
這篇稿子本來就是張Sir跟 AI 一句一句核對和改出來的。讀者看到的張Sir味道、裡面的判斷和想法,價值遠比殘留的一點 AI 味重要。那點 AI 味,也隨着這份雙向筆記一次次累積和修正,慢慢淡了下來。
下一篇,就從詞語/套語痕跡、句式套路和寫作旁白這三類 AI 味開始,一句一句拆,一種一種治。
協作者:張Sir和AI
後記
這篇文章動筆前,張Sir先跟 AI 來回討論約24輪;初稿面世後,前後累積超過40輪對話、至少10個完整版本及多次局部修改,期間還加入另一個 AI 交叉審讀,逐項核對技術表述、行文和標題。人負責辨認問題和作出取捨,AI 提供解釋與改法,一段一段磨成現在的樣子,也把人機協作真正費工夫的地方示範了一遍。
參考資料
Lindsey, J., Gurnee, W., Ameisen, E., Chen, B., Pearce, A., Turner, N. L., Citro, C., Abrahams, D., Carter, S., Hosmer, B., Marcus, J., Sklar, M., Templeton, A., Bricken, T., McDougall, C., Cunningham, H., Henighan, T., Jermyn, A., Jones, A., … Batson, J. (2025, March 27). On the biology of a large language model. Transformer Circuits. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
by angus | 2026-09-09
頭重和疲倦未必只因濕重,還要看脾胃之氣
下午兩點的會議室,一半人在打呵欠,另一半手裡端着咖啡。這個時段的疲倦幾乎是辦公室常態,很少人會當一回事。阿莉也在那間會議室裡,不過她的疲倦已經拖了一段日子。
她照前篇《谷氣,不是你想的那樣》裡的山藥、茯苓、陳皮三味茶飲喝了五天,肚子那陣脹感確實輕了,中午之後也沒那麼難受。偏偏早上起床頭還是重的,下午照樣口乾。
肚脹鬆了,精神卻沒有跟上。問題就在這個落差。
肚脹改善,精神未必跟着回來
《谷氣,不是你想的那樣》講過「飯裡那口氣」,也就是穀氣。按中醫理論,古人以清者上升、濁者下降來描述穀氣化生之後的功能。《黃帝內經.素問.陰陽應象大論》有「清陽出上竅,濁陰出下竅」,後世常用這句話理解脾胃所化精微上達頭面、濁物向下而行。
若沿用這套理解,阿莉的情況可以暫時理解為消化方面有改善,頭重、疲倦和口乾卻沒有。這時還可考慮脾胃之氣不足等方向,未必只是濕還沒清乾淨。
若仍當成濕未清而繼續排,部分人可能更覺口乾;若兼有脾胃之氣不足,處理重點便會不同。
這裡要補充一下,清陽升降是傳統醫學描述功能的講法,沒有對應的現代生理指標,也解釋不了所有的疲倦。
那氣升不上來,古人怎樣處理?約八百年前,李東垣已經系統討論過這類思路。
祛濕之外,李東垣還重視升清
金元時期的李東垣(李杲)著有《脾胃論》,承接《內經》貴胃氣的思想,卷上寫「百病皆由脾胃衰而生也」。今人常用「內傷脾胃,百病由生」概括他的學說。
上篇《濕氣越排越乾,不是更好嗎?》講的五種思路,有些偏於祛除濕滯,有些兼顧健脾和溫化。李東垣則特別重視另一個常被忽略的方向,就是升發脾胃清陽。
《素問.陰陽應象大論》另有「風勝濕」三字。李東垣在書中把羌活、防風、升麻、柴胡等稱為風藥,按不同證候取其升發陽氣、勝濕和升散的作用。情況就如濕衫掛在密不透風的房裡,摸上去總是黏手;打開窗,有風流通,通常乾得較快。這只是用來說明古人的取象,人體不會這樣直接。後世也強調風藥辛散,中病即止、病去便停。
《脾胃論》中可作這一思路例子的方劑之一,是升陽益胃湯。原方以黃芪為重,配人參、炙甘草益氣,以半夏、陳皮、白朮、茯苓等調中祛濕,再用羌活、防風、獨活、柴胡升散,另以小量黃連、白芍清熱和營。原書所述證候包括肢體困重、飲食不化、嗜臥乏力,也可能同時見口苦舌乾。這張方材料多屬中藥材,須由中醫師辨證使用,不宜在家照方自配。
家裡能做的,是在飲食上取健脾、和胃和清潤的溫和方向,但不等同升陽益胃湯的方義或作用。
一款以粉葛入饌的健脾食養湯
這款從《谷氣,不是你想的那樣》的山藥、茯苓、陳皮三味茶出發,再加入炒薏米、生薑和廣東湯水常見的粉葛。
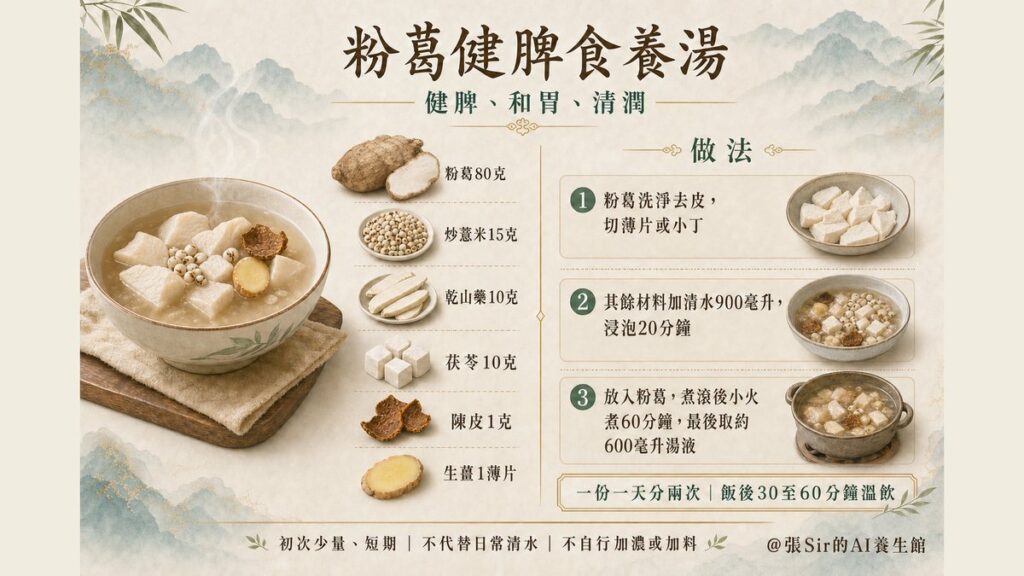
材料:粉葛80克、炒薏米15克、乾山藥10克、茯苓10克、陳皮1克、生薑1薄片。
做法:粉葛洗淨去皮,切成薄片或小丁。其餘材料略為沖洗,加入900毫升清水浸泡20分鐘,再放入粉葛。煮滾後轉小火煮60分鐘,按水量補少量熱水,最後取約600毫升湯液。一份一天分兩次,飯後30至60分鐘溫飲。
怎樣試:初次以少量、短期為原則,同時記下飯後脹感、頭重、身體困重、口乾和大便。這款湯不代替日常清水,也不需要自行加濃或加料。
傳統食養裡,山藥和茯苓偏於健脾,炒薏米健脾滲濕、性質較生薏米平和,陳皮與生薑偏於理氣和胃。山藥、茯苓、炒薏米、陳皮和生薑,前兩篇已分別提過。
這次特別想談的是粉葛。這裡用的是廣東湯水常見的食用粉葛,不是藥房裡按克使用的藥用葛根飲片。兩者同屬葛類,但來源、成分比例和用法不同,不能按重量互換。粉葛放在這裡取其清潤、生津的食養方向,也讓整款湯不至於一味偏向滲濕。它與李東垣所用的羌活、防風等風藥,更不是同一回事。
誰不適合:孕婦、哺乳期人士、兒童、慢性腎病、心臟衰竭患者,以及正在使用藥物或其他補充品的人士,飲用前先問醫生或藥劑師,並說明完整材料和份量。對材料過敏者不宜。粉葛性質偏涼,平日容易腹瀉或胃部怕冷的人少飲。飲後若口乾、腹脹、大便異常或其他不適加重,應停止飲用。
傳統穴位按壓
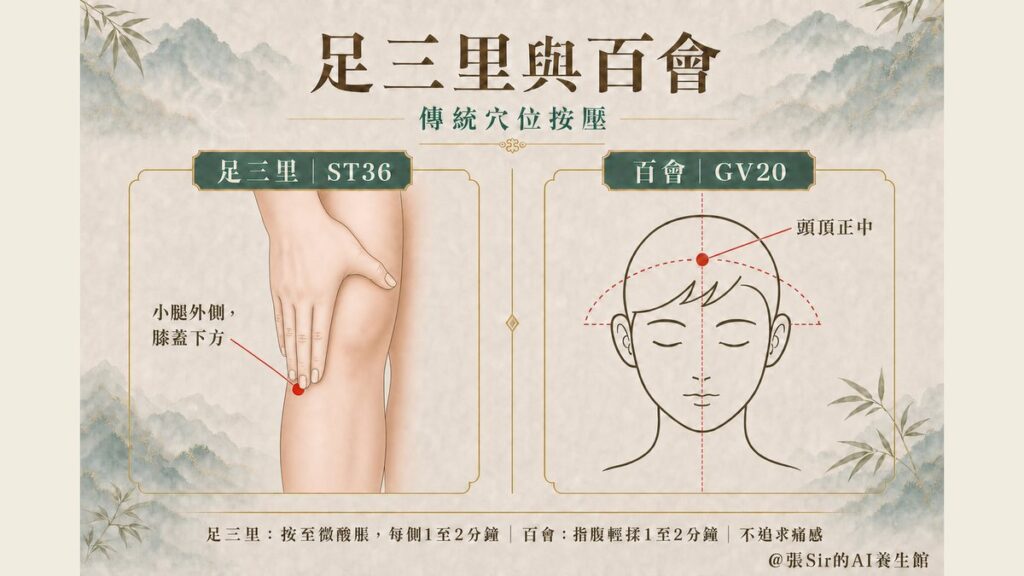
茶湯之外,足三里和百會也可以按一按。足三里在小腿外側、膝蓋下方,傳統上用於調理脾胃和氣血;百會在頭頂正中,傳統上用於頭重、精神不振這類表現。兩個穴位可配合圖示找位置。
足三里以拇指按至輕微酸脹,每側1至2分鐘。百會只用指腹輕輕按揉1至2分鐘,力度要比腿上輕得多,不要用力按壓或叩擊。頭皮有傷口,或近期外傷、手術尚未康復,不按該處。按壓時出現頭暈或其他不適,立即停止。
關於脾胃這三篇文章,說到底,是提醒自己:見濕不能只顧排,見累也不能只顧補。若症狀持續不退,還是要交給醫生或中醫師查清楚。
回到阿莉。五天的紀錄只能說明消化方面有改善,頭重和口乾卻沒有。接下來更值得記的,是睡眠時間、飲水量、辦公室冷氣溫度,以及一天裡起身走動多少次。
下午兩點辦公室那陣疲倦,答案未必在茶杯裡。
參考資料
王冰,注。(2005)。黃帝內經素問。人民衛生出版社。
李杲(李東垣)。(2005)。脾胃論。人民衛生出版社。
國家藥典委員會。(2020)。中華人民共和國藥典:2020 年版。中國醫藥科技出版社。
World Health Organization. (2008). WHO standard acupuncture point locations in the Western Pacific Region. https://iris.who.int/handle/10665/353407
本文內容只作學習參考,不構成任何醫療建議,如有不適請就醫。
協作者:張Sir與AI @張Sir的AI養生館 2026
