by angus | 2026-10-22
AI 每次回答都會回看前面的對話,錯誤和舊的要求留得愈多,後面愈容易不聽話
協作者:張Sir與AI
上一篇《提示詞還要學嗎?》發出後,有朋友跟張Sir說,他已經照著做,不背提示詞公式,直接和 AI 對話,哪裡不對就叫它改。可是談得愈久,AI 反而愈不聽話,改過的錯處會再出現,後面補的要求也好像視而不見。
這個問題正好補上上一篇沒有講完的一半,把 AI 當同事,用日常說話邊做邊改,方法沒有錯,只是同一段對話拖得太長,錯誤、舊要求和轉題全部堆積在一起,AI 便可能被前面的內容牽著走。
設想一場會議開了幾個小時,主管先叫人按部門整理,後來改為按地區,最後又刪去一項數字。三個版本都放在桌上,卻沒標明哪份仍然有效,同事便可能拿著舊版繼續做。AI 面對長對話,也要同時看著新舊要求、自己之前的答案、文件和工具結果。
聊久了,表現便變得忽好忽壞
今年 4 月,Microsoft Research 和 Salesforce Research 公布一項研究,把原本一次講完的要求拆開,讓 15 個模型逐步收到資料,再和一次講齊的版本比較,共測試超過 20 萬段模擬對話。
研究為 15 個模型完成任務的答案評分。用戶一次講齊要求時,模型平均約有 90 分;要求拆到多輪才逐步講完,平均只剩 65 分。
研究還把同一道題重複測試十次。較高分的一端只下降約 16%,高分和低分之間的距離卻增加 112%。意思是模型仍然答得出好答案,但有一些對話會差得很遠。研究人員回看這些失敗對話,發現模型常在資料還沒講完時先猜答案,後面再沿著早段的猜測走。同一項工作,有時答對,有時從第一步開始走偏,用戶感受到的就是忽好忽壞。
一句更正有時改不回來,是因為新一輪對話不會擦掉前面的答案,模型仍然看得到那條錯路。輪數只是表面,對話裡留下了什麼,對後面的輸出影響更大。
對話裡的內容,不會自動分出輕重
上下文(context)是 AI 當下可以看到的全部內容,包括對話歷史、文件、規則和工具結果。模型的視窗能放得下很多資料,不代表應該全部放進去。裡面每多一項,AI 便多一項內容要分辨和取捨。
長對話究竟會在哪裡出錯?從事 AI 工程工作的 Drew Breunig 看過多種人工智能代理失靈的情況,在 How Long Contexts Fail 文章裡整理成四類,之後再於 How to Fix Your Context 一文說明處理方法。
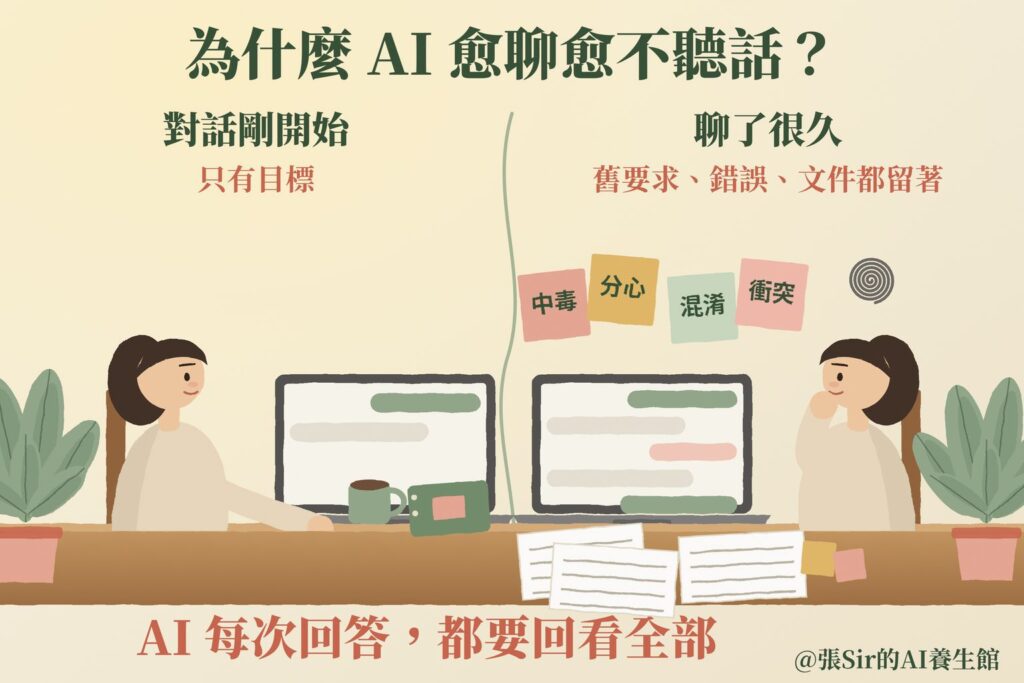
第一類「中毒」,就是很多人熟悉的人工智能幻覺(hallucination,即 AI 編造出來的內容)留在對話裡。發現後立即改正,問題還不大;後面每一輪都把它當成事實,整段對話便會走偏。
- 中毒(Context Poisoning),AI 出現幻覺,後面一直把錯誤當真。先核對重要資料,錯了便停止沿用。
- 分心(Context Distraction),資料太多,AI 被舊紀錄困住,忘了原來要做什麼。先摘要出目前的目標和進度。
- 混淆(Context Confusion),文件、工具和規則太多,AI 不知道先用哪一個。只保留這次需要的材料。
- 衝突(Context Clash),新舊要求同時存在,像幾個老闆一起發指令。移除舊版本,再交代完整新版本。
以上四種情況也會互相牽連,錯誤先令對話中毒,資料增加後開始分心,用戶再改要求,新舊版本便互相衝突。
這種幻覺怎樣一路留下來,研究論文《Breaking Contextual Inertia》附錄有一個例子。用戶問物理治療總費用,AI 自行加上「保險承擔 80%」,用戶從未提供這個條件。後來用戶補上每小時收費 125 美元,AI 仍沿用保險假設,算出 600 美元;按用戶實際提供的條件,答案應是 3,000 美元。
研究者把這種固守先前推理、連用戶更正也難以扭轉的傾向稱為上下文慣性(contextual inertia)。AI 收到了更正,可是前面的錯誤已經成為後面計算的起點。
就算沒有明顯錯誤,內容太長也會分心。Chroma 的研究團隊稱這種現象為上下文退化(context rot)。他們的技術報告測試 18 個模型,其中一項測試只給約 300 個詞元(token,即 AI 處理文字的基本單位)的相關內容,表現都比讀取約 11.3 萬個詞元的完整歷史好。上下文視窗放得下,不代表全部內容都有幫助。
除了資料太長會分心外,選項太多則會混淆。設想一個人工智能代理(AI agent)有 50 個工具,這次只需查訂單進度,其餘工具的說明仍然全部放在對話裡。可選的工具愈多,選錯的機會也愈多。
辦公室也常見新舊要求的衝突,同事先叫 AI 把各部門的數字分成三張表,主管後來改為合在一張總表。若只補一句「不要分開」,AI 仍不知道原來的欄目和小計是否保留。改成「只交一張總表,以部門為列,不另做分表」,才完整取代舊要求。
要求一路改,AI 最容易掉隊
表格版本改來改去,仍算同一件工作。日常對話還有更大的轉向,連任務的對象和用途也換了。寫一封信,可能經過這幾輪:
- 先幫我寫一封客戶信。
- 語氣再正式一點。
- 不要提到降價。
- 改成給法務看的版本。
- 等等,剛才那個條件還是要保留。
前兩句仍在修改同一封信,到了「改成給法務看」,對象和用途都變了。AI 若沒有重新整理目前版本,法務稿裡仍可能出現已經刪去的降價內容。
這種中途改口和轉題,正是《LLMs Get Lost in Evolving User Intent》測試的情況。研究把交給大語言模型(LLM)的題目由一次問完改成最多七輪,再加入三種變化:補充條件、改掉先前條件,以及轉去做另一項相關工作。轉題可以是先找餐廳,後來改為訂位;放回上面的例子,就是由寫客戶信改成寫法務稿。九個較新的模型在數學題上的表現全部下降,轉題造成的下降最大。
研究者再分開測試對話變長和要求改變。GPT-5.1 做同一批數學題,只用意思不變的內容把四輪延長至七輪,準確率由 87.0% 變成 87.5%;七輪裡加入更多方向轉變,便降至 82.0%。多三輪沒有令成績下降,改方向才有影響。客戶信改成法務稿後,讀者、用途和判斷標準都換了;舊對話仍在談怎樣說服客戶,AI 便容易沿著已經作廢的目標繼續寫。
整理目前版本,再開啟新對話
多輪對話的問題既然來自舊內容累積,處理時就要先把目前仍然有效的內容分出來。對話開始變亂時,先不要再補一句指令。請 AI 整理一份「目前版本」,只留下五類內容:
- 現在要完成什麼。
- 哪些要求仍然有效。
- 哪些舊要求已經作廢。
- 哪些事實、數字和來源已經核對。
- 還有哪些假設和問題未確認。
AI 整理完,人還要看一遍。數字和來源有沒有錯,作廢條件是否仍混在裡面,AI 自行加上的假設有沒有被當成事實,這些都要檢查。確認後,把這份目前版本貼進新對話,讓 AI 只按現行要求繼續工作。
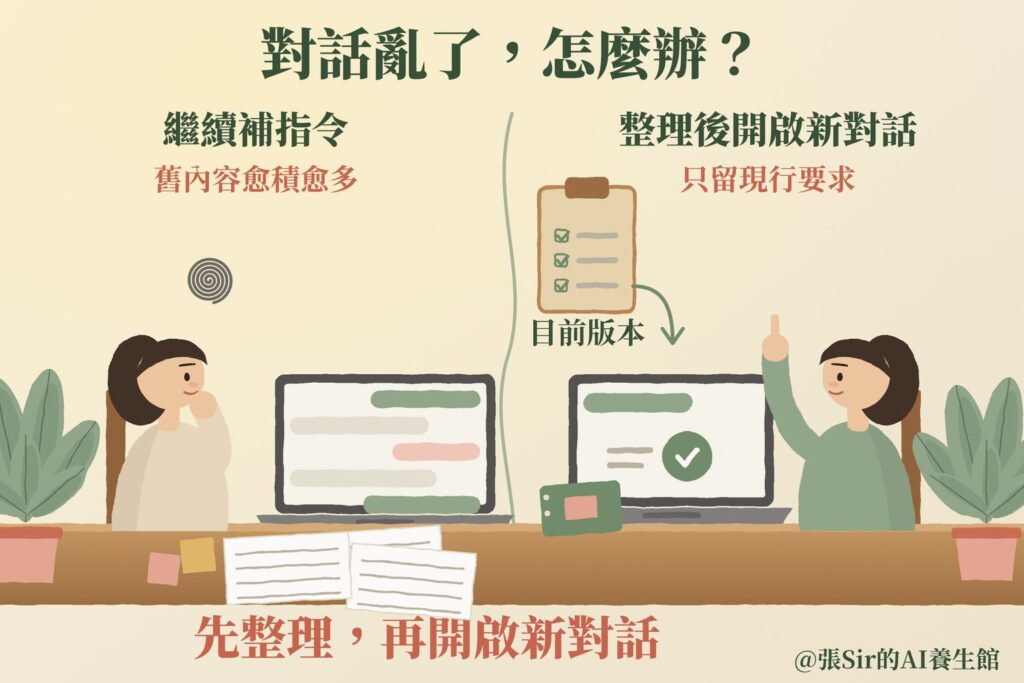
貼進新對話的,就是這次任務的最新狀態。上一篇談過覆盤和 Skill,常用的語氣、標準和流程可寫進 Skill;這次的進度、數字和臨時決定,只放進新對話。兩類資料分開,一次性的要求便不會混入長期規則。
資料分開後,支援 Skill 的 AI agent 可以代為整理;尚未支援的,便由用戶把目前版本貼進新對話。兩種做法都要由人確認目標和核對結果。
本文開頭提到的那位朋友,不用再學一條更長的提示詞。繼續補指令,只會令舊對話更長。整理目前版本,核對後再開啟新對話,AI 看到的便只有現行要求,不必再猜哪一句才算數。這樣,改過的錯處不容易再冒出來,後面補的要求,也較容易被 AI 看見。
@張Sir的AI養生館 – 學習智人
參考資料
Breunig, D. (2025, June 22). How long contexts fail. dbreunig.com.
Breunig, D. (2025, June 26). How to fix your context. dbreunig.com.
Chen, X., Zhang, Z., Guo, S. Y., & Zou, D. (2026). Breaking contextual inertia: Reinforcement learning with single-turn anchors for stable multi-turn interaction. In Findings of the Association for Computational Linguistics: ACL 2026 (pp. 6302–6318). Association for Computational Linguistics.
Hong, K., Troynikov, A., & Huber, J. (2025, July 14). Context rot: How increasing input tokens impacts LLM performance. Chroma.
Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs get lost in multi-turn conversation. The Fourteenth International Conference on Learning Representations.
Tack, J., Laban, P., & Neville, J. (2026). LLMs get lost in evolving user intent (arXiv:2607.20734). arXiv.
by angus | 2026-10-20
未必!對著 AI 把事情說清楚,下次一句話就聽你話
協作者:張Sir與AI
這幾個星期,張Sir寫了好幾篇文章,談怎樣去除內容裡的 AI 味、AI 在學校裡怎樣用、不同階段該用哪個層級的 AI。《老師和學生,用的是同一種 AI 嗎?》發出之後,不少朋友追問張Sir,什麼時候開班授課。
若開班的話,頭一個問題就是教什麼。如果內容只是一套套提示詞(prompt,即給 AI 的指令)公式,那就未必需要。模型的能力變得很快,今天還要特別寫明的 prompt,下一代可能已經不再需要。
前沿模型公司 Anthropic 旗下編程工具 Claude Code 團隊的 Boris Cherny,7 月底在一場公開訪談裡,談到新一代模型能做什麼,也談到提示詞工程(prompt engineering,即研究怎樣把指令寫得更有效)。他說,一年前最熱門的職位之一是提示詞工程師,這類熱門職位和潮流一波接一波,來了又去。現在更值得花功夫的,是把一項看來有點太難的工作交給模型,再想辦法讓它在過程中檢查自己的工作。他認為,多數人最容易漏掉的正是驗證。
隨著模型的進化,提示詞已沒有大家想像中那麼重要了。把 AI 當成一位新同事,講明想做什麼,看到問題再慢慢溝通和修正,通常比花很多時間研究公式划算。Cherny 在同一場訪談裡也提到,有多年經驗的工程師常把指令寫得過分仔細,連每一步怎樣做也替模型決定。他形容,大家正在學習怎樣把模型當同事。
這裡說「未必要學」,指的是固定公式和萬用句式。任務要做什麼、資料從哪裡來、什麼不能碰、怎樣才算完成,仍然要交代。人可以放下那些炫技式的寫法,表達力卻不能省。能不能把自己的想法講清楚,比記住多少提示詞技巧重要得多。
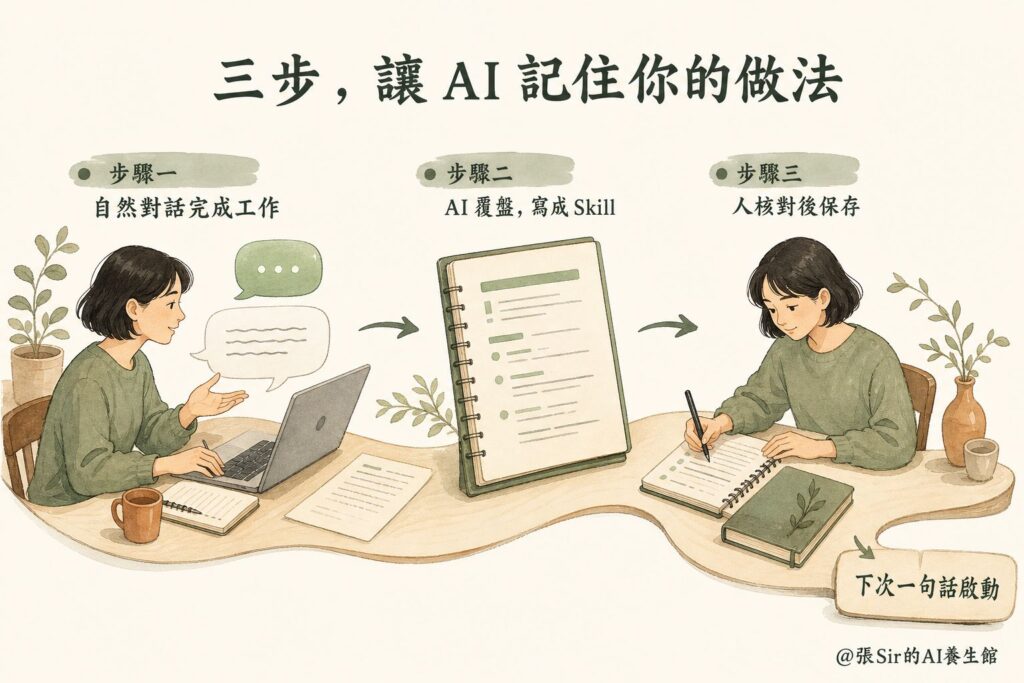
整個方法只有三步。先用自然對話把工作完成,再叫 AI 覆盤並寫成 Skill,最後由人核對後保存。下次遇到同類工作,一句話便可以調用。
先說清楚,再邊做邊改
設定角色、規定步驟、套用固定格式,很多都是模型較難理解人的意圖時留下來的做法。現在的模型較能理解日常語言,也容許用戶來回修改。簡單工作往往直接說便可以,不少舊 prompt 已經用不上。
例如要修改一段文字,直接說「幫我改得專業一點,給家長看,不要太官腔」已經可以開始。結果太生硬,便指出哪一句不像自己;內容漏了,便叫它補回。這就是自然對話,不用先學一套格式。
工作較複雜,也只是多交代幾句。報告給誰看、可以使用哪些資料、哪些內容不能猜、最後怎樣才算合格,知道多少便先說多少。AI 做出第一版之後再改,通常比花時間砌一條完美提示詞實際。
把 AI 當同事,只是說溝通方式相近。AI 不知道用戶沒有說出口的公司規定,也不會為錯誤負責,所以資料和結果仍要由人核對。提示詞公式可以少學,表達和判斷不能省。
做完一次,叫 AI 幫你覆盤
自然對話容易開始,但視窗一關,剛才改過什麼、哪些要求有效,也可能跟著消失。下一次再做同類工作,又要從頭說一遍。
所以,工作完成後多走一步,叫 AI 覆盤。用戶不用自己寫報告,只要說:「回頭看看這次工作,我改過什麼?哪些要求下次還會用到?整理成規則。」AI 便可以從對話中找出重複出現的要求。
例如,用戶改稿時說:「這篇太像新聞摘要,我要的是有立場的分析,而且你把一份報告的預測寫得太肯定。」工作完成後,AI 把這次修改整理成兩條規則:以後轉述資料,要接著寫出張Sir的判斷;引用預測,要用「估計」「可能」等字眼,並交代成立條件。用戶確認 AI 沒有理解錯,便叫它把兩條規則寫進 Skill。下次再寫分析文章,這些要求就不用重新交代。
張Sir寫專欄用的寫作引擎,是一份動筆前交給 AI 閱讀的寫作規則,現在已更新至第十一版。每篇文章完稿後都有復盤,錯處就這樣慢慢變成規則。有一次,AI 寫了「怕返工反而更慢」。返工在內地常指重做,在港澳卻是上班,意思完全不同。引擎後來便加上一條:在上述情況下,返工表示來回修改。於是,後來直接出來的結果便會避開港澳讀者容易誤解的地區說法。
規則不用一開始全部想好,也不用由用戶逐條編寫。工作做完一次,一句話叫 AI 覆盤,AI 便幫忙整理,人負責核對。一個錯誤留下一條規則,下次便少犯一次。
寫成 Skill,下次一句話開始
核對過的規則,可以寫成技能包(Skill,即一份讓 AI 知道某類工作該怎樣做的說明)。名字聽起來有點技術,可以把它理解成一份交給 AI 的工作筆記。裡面記著文章給誰看、慣用什麼語氣、哪些寫法不要用、資料怎樣核對,以及交稿前要檢查什麼。
請 AI 根據剛才的覆盤整理 Skill 初稿,人再讀一遍,刪掉不需要的內容,改正理解錯誤的地方。確認後保存,下一次只要說一句要做什麼,便不用把相同要求全部重講一次。
Anthropic 官方的 Skill 撰寫指引建議的也是這個次序。先用普通對話把工作做一遍,留意自己反覆交代過什麼,再請 AI 整理成 Skill。放進日常工作後,看到它出錯,再回頭修改。
到了這一步,用戶下次只要說「啟動 Skill,把這份資料寫成內部講稿」,AI 便可以按已保存的規則開始工作。
不懂 IT,也可以用這個方法
看到 Skill,有人可能以為又要學寫程式、建立資料夾和設定系統。這些是平台背後的工作,無需一般用戶去做。平台預先設定好之後,用戶只需自然對話。第一次把事情說清楚,完成後叫 AI 覆盤並寫成 Skill,自己核對後保存。下次再做,只要說一句想做什麼。
覆盤、整理和保存,可以交給人工智能代理(AI agent,即能自己安排步驟和調用工具完成工作的 AI 程序)。AI agent 可以根據這次對話,找出反覆出現的要求,整理成 Skill,再把草稿交給人核對。用戶不用知道文件放在哪裡,也不用自己處理載入規則等技術細節。
正如前文談過,大家手上的 AI 未必處於同一層級。有些平台可以建立和調用 Skill,有些還不可以。如果用戶的 AI 沒有這項能力,本文這套做法便暫時用不上;有的話,平台設定由提供系統的人處理。用戶仍只需說清楚自己想要什麼,判斷結果是否合用。
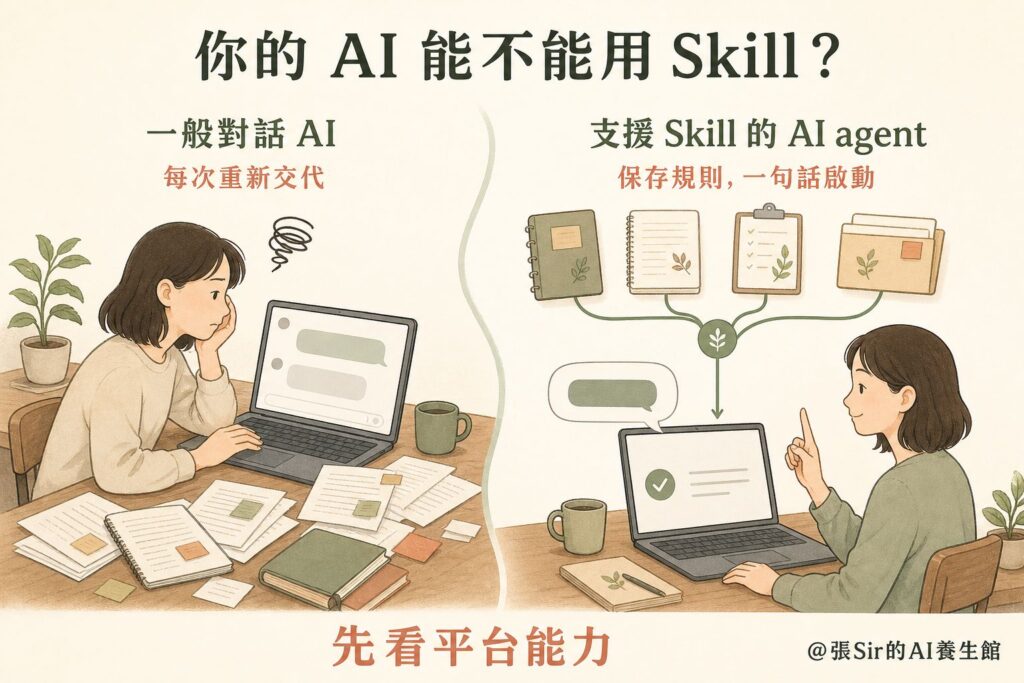
張Sir和團隊目前使用的自研 AI agent 平台,做的也是這件事。用戶說一句想做什麼,AI agent 在背後讀取已確認的規則;工作完成後,再把這次的新修正整理出來,交給人決定要不要保留下來。
提示詞仍然會用,但一般用戶不用把它學成一門複雜的公式課。先把事情說清楚,邊做邊改,完成後叫 AI 覆盤,再由人核對並保存成 Skill。這個循環多走幾次,下次一句話,AI 便較容易按你的方法去做。
@張Sir的AI養生館 – 學習智人
參考資料
Anthropic. (n.d.). Skill authoring best practices. Claude Docs.
Y Combinator. (2026, July 27). Boris Cherny: We cut 80% of Claude Code’s prompt [Video]. YouTube.
by angus | 2026-10-18
學生使用AI已日常化,學校要先看清工具、用法和判斷的差距
協作者:張Sir與AI
張Sir聽過老師說,備課的工作多,用人工智能(AI)起草很快,可是校對、改正和調整格式很花時間,餘下的精力,不夠再去深究怎樣和學生一起用 AI。
不少學生已經把 AI 用到功課、資料搜尋和文章修改,哪個模型順手便用哪個。當老師還在想一份教材哪部分交給 AI,學生可能已經在免費版、付費版、內地和海外模型之間來回切換。
老師和學生都說自己在用 AI,手上的可能根本不是同一種 AI,看到的功能也不是同一回事。誰用得多,僅佔這道差距的一部分。
大家說的 AI,可能不是同一個 AI
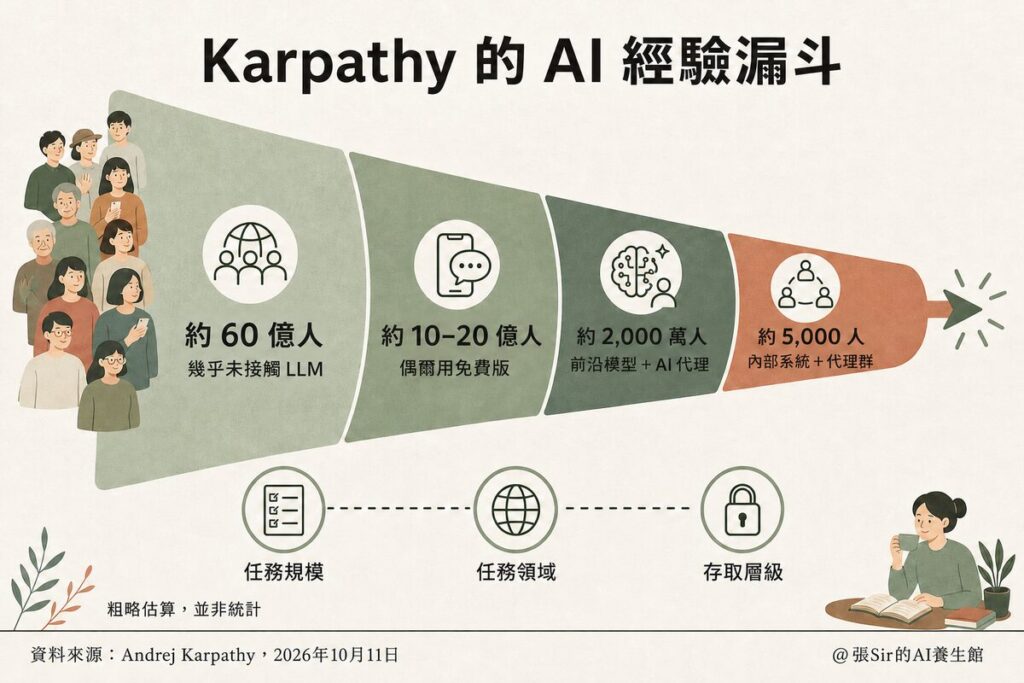
Andrej Karpathy 最近把這種差距畫成一個漏斗。10 月 11 日,他重貼今年 4 月的一則 X 貼文,形容人們接觸到不同等級的 AI,又用它們處理不同規模和領域的任務,因此對這些系統究竟能做到什麼,形成截然不同的認識。原來「兩群人各說各話」的局面,已變成一道愈來愈陡的漏斗。
Karpathy 是 OpenAI 的創始成員之一,曾任特斯拉(Tesla)人工智能總監,也在史丹福大學教過深度學習(deep learning,一種訓練人工神經網絡的方法)。2024 年,他創辦 AI 教育公司 Eureka Labs;2025 年提出氛圍編程(vibe coding,用日常語言叫 AI 寫程式)一詞;2026 年 5 月加入 Anthropic。他在 AI 圈影響力很大,這則貼文已有數百萬次觀看。
他描繪的漏斗最寬一層約有 60 億人,幾乎沒有接觸過大型語言模型(large language model,LLM,即 ChatGPT 一類能生成文字的人工智能)。往窄一層看,約 10 億至 20 億人偶爾使用免費版,把 AI 當成搜尋或寫作工具,覺得它有點方便,也有點笨。Karpathy 說,不少數學和編程以外的專業人士就停在這一層,包括每天忙著與人溝通的管理層。
把漏斗再收窄,約 2,000 萬人在數學和編程工作中使用前沿模型(frontier model,即各家實驗室當前最強的模型)。他們接觸到能接手大型項目的 AI 代理(AI agent,即能自己分步完成任務的 AI)。有些工作以前要做幾星期甚至幾個月,現在輸入一道指令,AI 便可以開始處理。最後是最窄的一層,約有 5,000 人,接觸到尚未公開的內部系統,看著成千上萬個 AI 代理連續工作幾星期,處理大型軟件工程、網絡攻防、科學發現和數學問題。到了這一層,人類連審閱 AI 產出的速度也開始追不上。
Karpathy 說,這些只是「在餐巾紙上作的粗略估算」(napkin math)。同一時間,有人覺得 AI 只是一個不太可靠的聊天工具,有人已經看著它接手過去要做幾個月的工作。雙方談的都叫 AI,經驗卻差得很遠。
差別在哪裡?第一是問題有多大。問一個幾句話便答完的問題,很難看出前沿模型的能力;把一個真正重要、需要做幾星期的項目交給它,差別才會出現。第二是任務能不能核對答案。Karpathy 認為,數學和編程較容易驗證結果,因此較能顯示前沿模型的能力。第三是能用到哪一層,免費版、付費版,還是實驗室內部版本。
港澳還面對另一個現實,不同公司的模型、內地與海外服務,即使同樣分為免費版和付費版,功能也可能不同;帳戶、地區、學校政策和付費安排,還有供應限制的版本。老師說「AI 做不到」,學生卻說「早就可以」,兩邊未必有人說錯,可能用的是不同的系統。
Karpathy 的漏斗沒有按行業劃分,企業和職場同樣適用。設想一間公司,有人每天把大型項目交給前沿模型和 AI 代理;有人仍把 AI 當成聊天或寫作工具;三種人坐在同一張會議桌前,看到的卻是三種 AI。管理層聽完兩邊的說法,如何決定公司怎樣做變成新的議題。職場裡老闆和同事對速度的不同想法,張Sir在《老闆嫌不夠快,同事怕做得太快》談過。
回到學校,老師卡在哪一步
張Sir認為,不少老師的實際使用仍接近 Karpathy 所說的偶爾使用一層。老師已經用 AI 備課和寫教材,到了批改、分析學生答案和判斷學生學習情況,往往便停下來。這些工作責任較大,錯了也較難發現,老師自然用得保守。
根據三位香港立法會議員今年 6 月公布的一份教師問卷調查結果,收到 185 份校長、科主任和前線教師的回應。備課和教材設計得到 3.5 至 4.0 分(滿分 5 分);分析學生答案和學生學習情況,不少受訪者只給 1 至 2 分。近六成學校仍由教師各自摸索,全校已有政策和培訓支援的只有約 12.4%。調查結果也顯示,老師最常用的是 Gemini、DeepSeek 和豆包這類通用對話工具,對 AI 代理和檢索增強生成(retrieval-augmented generation,RAG,讓 AI 先查指定資料再作答的技術),超過 70% 的受訪者「完全沒有使用或不懂如何使用」。報告提到,沒有校本教材庫,AI 生成的內容容易不符合香港課程標準,同工因此不敢放手讓它參與核心的課業評改。這份問卷雖然只有 185 份回應,但仍可以當作一個側面參考。
另一端,學生使用 AI 已經成為日常。張Sir的文章引用過最新的PISA香港報告顯示,53% 的香港 15 歲學生每星期至少一次用 AI 聊天機械人幫助學習。澳門互聯網研究學會的2025年居民調查則呈現,學生網民使用生成式人工智能(generative AI,即能生成文字、圖像等內容的 AI)的比例為 74%。
那麼,教師得到多少時間追上去?根據澳門教青局回覆立法議員質詢時說,2025/26 學年起,資訊科技教師每學年至少接受 10 小時 AI 培訓,其他教師至少 6 小時。訂出最低培訓時數,至少把 AI 培訓正式納入教師專業發展,也讓資訊科技教師有較多時間深入學習。這組時數不能用來判斷老師掌握了多少,卻是一個制度起點。工具變得很快,接下來還要看培訓是否貼近教師的實際任務,以及學校有沒有政策、工具和持續支援。前述香港問卷裡,已有全校政策和培訓支援的學校只有約 12.4%。
英美教育也有相近的壓力,英國高等教育政策研究所(Higher Education Policy Institute,HEPI)今年 3 月訪問 1,054 名全日制本科生,95% 用過 AI,94% 用生成式 AI 協助被評核的功課;68% 認為 AI 技能很重要,只有 48% 覺得教學人員有幫他們掌握這些技能。美國 Gallup 與沃爾頓家族基金會訪問 2,069 名中小學教師,在 10 項任務中,至少一項有正式指引的教師佔 18%;34% 完全沒有指引,48% 只有非正式指引。到了批改、回饋和分析學生數據這些責任較大的工作,過半教師連指引也沒有。
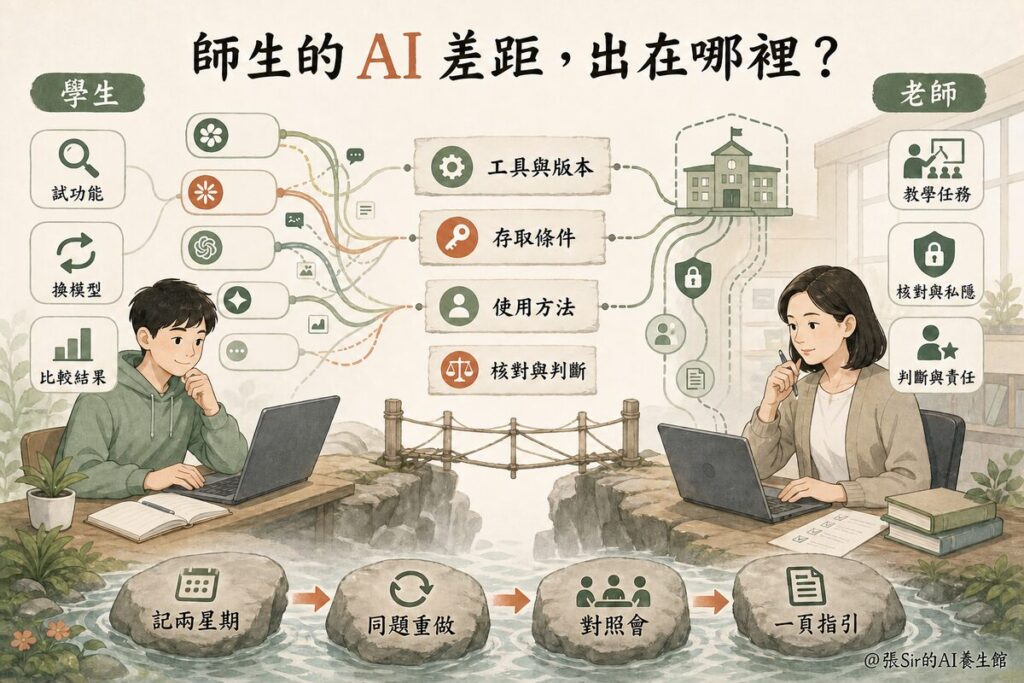
學生使用已經普遍,能力未必成熟;老師培訓時數少,也不能說老師不懂。不少學生接觸 AI,就像摸索新遊戲一樣,會自己試功能、換模型、比較結果。多數老師讀書時沒有這種工具,今天除了要學會使用,還要想清楚怎樣放進課堂、出了錯由誰負責。學生可以邊用邊試,老師卻要同時追技術和教育,兩邊起步的時間與承擔的責任自然不同。
AI 省了時間,為什麼老師仍然很忙
用 AI 備課能否省下時間,要看交給它什麼工作。
Gallup 今年 10 月的調查訪問了 1,952 名美國中小學教育工作者,59% 在 2025/26 學年用過 AI。用過的人當中,13% 說 AI 讓自己多出很多時間,51% 說多出一些,可以留給他們認為最重要的教學工作;29% 說沒有影響,7% 說反而更花時間。什麼工作最重要?同一份調查顯示,教育工作者最看重直接與學生相處,包括幫學生克服困難、看見學生在學業上有好表現、給學生個別回饋,以及帶領創意和動手做的活動。不過,這份調查沒有追蹤省下的時間實際用到哪裡。Gallup 在 2025 年的另一項調查才問到具體用途,有老師用來給學生更細緻的回饋、設計個別化課堂、寫信給家長,也有人可以早點回家。
這跟文章開頭那位老師所說的經驗看似相反,兩者可以同時成立。AI 幾分鐘便能起草一份教材,資料是否準確、題目是否合適、語氣是否適合學生,仍要老師逐項看。若起草省了二十分鐘,覆核卻用了半小時,最後時間還是沒有省下來。
張Sir認為,Karpathy 所說的可驗證性,也可以用來理解香港問卷裡的差別。老師熟悉自己任教的課程和教材,較容易逐項覆核 AI 起草的備課內容;分析個別學生的學習情況,還要結合作答紀錄、課堂表現、私隱和責任,沒有一個答案可以直接核對。這可能是老師願意用 AI 備課,碰到學生分析便保守得多的一個原因。
老師要追的是判斷
學生一天可以試幾個模型,老師沒有可能跟著每次更新追跑。學校要追的是哪些工作可以交給 AI,哪些答案必須查,哪些判斷一定要由人負責。某個模型今天排第一,過幾天又換被擠下來。
張Sir常說,執行可以外包,理解不能外包。學生看著 AI 把答案一步步寫出來,容易以為自己已經學懂;老師看著 AI 生成一份完整教材,也可能因為文字太順,忽略裡面的錯。張Sir在《知道要小心 AI,卻不知道小心甚麼》談過這種情況,自己先懂,才看得出 AI 哪裡不對。
老師要教給學生的是判斷,提示詞(prompt,即輸入給 AI 的文字指令)很快便會過時,因為AI的能力迭代實在太快。為什麼這個答案可信?哪一部分要找原文?換一個模型,結果是否相同?用了免費版和付費版,差別出在哪裡?這些問題,才是老師追得上、也必須追上的部分。
學校要補 AI 工具培訓,也要先弄清師生的差距出在哪裡。差別可能來自工具、版本、存取條件、使用方法或核對習慣。情況沒有看清,培訓便容易教錯重點。張Sir建議,師生先把使用過程記錄兩個星期,找出具體差距,再決定補什麼。
師生一起做兩個星期筆記
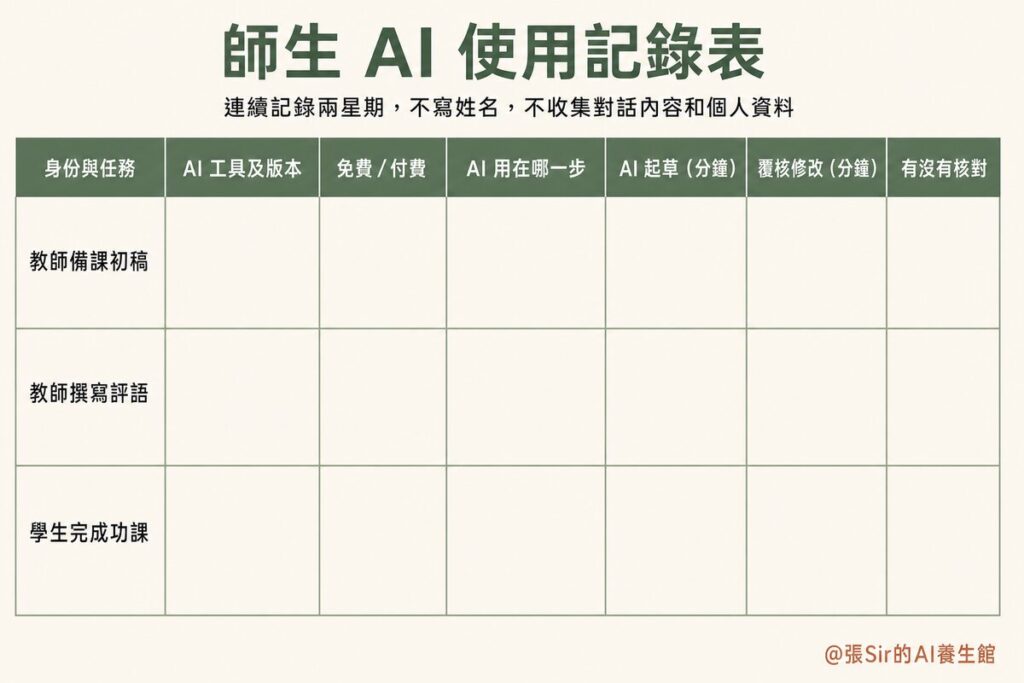
學校要知道師生接觸的 AI 相差多遠,可以先把兩邊的使用情況放在一起看。記錄老師備課,能找出覆核成本;學生記下所用工具和核對方法,可看到兩邊在哪一環開始分岔。記錄不用寫姓名,也不收集對話內容和個人資料。
1. 師生各記兩個星期。 學生匿名記錄用過什麼工具和版本、免費還是付費、用來做什麼、最後有沒有核對。老師記錄相同項目,再加上 AI 起草和覆核修改所用的時間。
每次記錄七項:身份與任務、AI 工具及版本、免費或付費、AI 用在哪一步、AI 起草時間、覆核修改時間、有沒有核對。可先從三類任務開始:教師備課初稿、教師撰寫評語、學生完成功課。
2. 選兩項真實任務重做。 使用不含個人資料的課堂材料,也只用學校允許的服務。第一項固定材料、要求和工具,師生各自操作,看使用方法有什麼差別;第二項固定材料和指令,各用自己的常用工具,看模型和版本帶來什麼差別。
3. 開一個二十分鐘的對照會。 根據記錄結果,可看到四件事。學生用得到、老師用不到的是什麼;雙方是否使用不同版本;哪類答案最難核對;差距來自使用方法、模型能力,還是存取限制。
4. 寫一頁指引,再按差距補培訓。 寫明哪些內容必須由人覆核、由誰負責、學生怎樣標示 AI 的參與。如果差在工具,先處理帳戶和存取;如果差在核對,便練查證;如果差在判斷,便用真實作業一起討論。
學生記下自己實際用了什麼,老師也不用再靠猜,學校也有了看清差距、安排支援和培訓的根據。開頭那位老師,不妨就從自己的備課記起。校對一份 AI 起草的教材究竟要多久,兩個星期後就有答案。
@張Sir的AI養生館 – 學習智人
參考資料
郭如佳(2026年6月13日)。教育線上/調查︰六成港教師自行探索AI教學。大公報,A3。
澳門互聯網研究學會(2026)。Decoding generative AI behavior: Applications, perspectives and literacy of Macao residents [研究報告]。
澳門特別行政區政府教育及青年發展局(2025年12月5日)。關於立法會李靜儀議員書面質詢的答覆 [公文]。
Ash, A. M., & Senseman, K. (2026, May 26). Most teachers receive no formal guidance on AI use. Gallup.
Brenan, M. (2026, October 14). Teachers using AI say it frees up time for what matters most. Gallup.
Roytburg, E. (2026, May 19). Andrej Karpathy, OpenAI founding member and inventor of ‘vibe coding,’ defects to Anthropic. Fortune.
Gallup. (2025, June 24). Three in 10 teachers use AI weekly, saving six weeks a year. Gallup.
Karpathy, A. [@karpathy]. (2026, October 11). Dusting off this tweet from April because this gap in shared understanding of LLM capability is widening [Post]. X.
OECD. (2026). PISA 2025 results (Volume I): Hong Kong (China) [Country note]. OECD Publishing.
Stephenson, R., & Armstrong, C. (2026, March 12). Student generative AI survey 2026 (HEPI Report 199). Higher Education Policy Institute.
by angus | 2026-10-06
香港和澳門學生都在用 AI,學校要講清楚哪些步驟可以問,哪些要自己做
協作者:張Sir與AI
美國賓夕法尼亞州一名八年級學生,為了快點完成代數功課,把題目輸入學校電腦的 Google 搜尋框,讓人工智能(artificial intelligence,簡稱 AI)替他解答。這裡的 AI,是可以生成文字答案的電腦系統。後來,他也用 AI 完成其他科目的功課。到了學年結束,平日數學成績大多是 B 的他,期末考卻不及格。他對記者說,考試不能用 AI 時,腦子就轉不動。
這個例子來自《華爾街日報》(WSJ)10 月 1 日刊出的調查報道。記者訪問了 60 多名老師、學校管理人員、家長、學生和臨床醫生。丹佛一名九年級老師發現,學生連作文題目也想不出來;另一名丹佛老師說,學生開始把 Google AI 摘要當作主要資訊來源。邁阿密一名英語老師則發現,學生引用 AI 提供的《花衣魔笛手》觀點,被追問時卻說不出它與小說的具體關係。功課交得出去,腦子有沒有跟著做過一遍,老師一問便知道。
這名學生用的是 Google 搜尋,港澳學生更熟悉的也可能是聊天框。無論打開 DeepSeek、豆包、Kimi 還是 Gemini,動作都差不多,都是貼上題目,等答案出來。這篇報道從 Google 搜尋切入;學生每天使用聊天機械人時,也會遇到同一個問題。
香港過半學生每周都在用
經濟合作與發展組織(OECD)最近發布的國際學生能力評估計劃(Programme for International Student Assessment,簡稱 PISA)香港報告顯示,53% 香港 15 歲學生每週至少一次用 AI 聊天機械人幫助學習,OECD 平均是 46%;用 AI 起草寫作的香港 15 歲學生佔 38%,也高於 OECD 平均的 29%。在 PISA 問到的幾項功課用途裡,從不或幾乎從不用 AI 的香港 15 歲學生只有 7%。
從數字可見,學生已經在用 AI;接下來要問的是,他們把哪些學習步驟交給 AI。PISA 主報告比較 91 個國家和地區的學生問卷與科學測驗,發現每天用 AI 起草文章等特定功課的學生,科學成績平均比從不用的學生低約 20 分;每週用 AI 幫助自己學習的學生,成績則和不用的相若。這組數字呈現的是使用方式與成績的關聯。同樣是用 AI,用途不同,成績的差別也不同。
香港的 PISA 資料可以比較 AI 用途;澳門的PISA 2025 公開資料列出科學和數學全球第三、新設的「在數碼世界中的學習」範疇第一,暫時未見學生怎樣使用 AI 的相應數字。澳門互聯網研究學會今年發布的居民調查報告提供了另一組本地數據。該調查訪問 1,000 名 6 至 84 歲澳門居民,學生網民的生成式人工智能(generative AI)使用率為 74%。這類 AI 可以生成文字、圖像等內容;在所有生成式 AI 用戶中,68% 用來快速搜尋資料,21% 用來輔助功課。公開報告沒有顯示他們把哪些功課步驟交給 AI,教育界正好可以繼續追問。
搜尋框之外,學生還有聊天框
Google 把 AI 摘要和 AI Mode 加入搜尋頁面後,學生查一項資料,答案已經排在搜尋結果頂部。AI Mode 是可以持續追問的搜尋模式。WSJ 報道指出,合作學區不能從 Google 提供的管理後台停用這兩項功能。老師還未開始教學生怎樣問,學生已可從搜尋頁面學到一種用法:先看生成答案,再決定要不要翻原文。
使用聊天機械人時,學生有更多選擇,取得答案也更快。部分聊天機械人支援圖片或文件上載,學生拍下題目便可以提問。產品這樣設計很合理,用戶就是想快點得到結果;學生用它做功課時,老師便要多問一句:拍照之前,有沒有自己做過?
學校若只教提示詞,學生很快便學會怎樣問得更快、更完整。學生學習時卻要保留一些不方便的步驟:讀題、列算式、寫第一稿,也要找出自己哪一步不懂。這些步驟看來慢,考試時要靠的正是它們。
AI 先追問,不一定先交答案
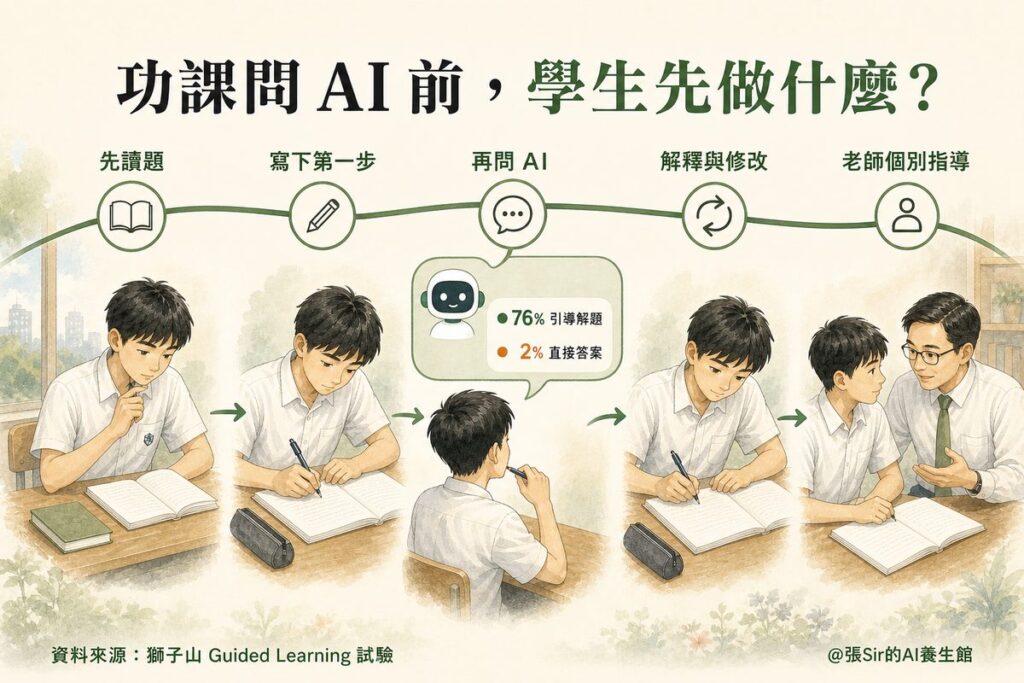
這些學習步驟怎樣保留下來,Google 與 Fab AI 在獅子山進行的隨機對照試驗(randomized controlled trial)提供了一個具體流程。研究團隊把同一所學校、同一年級的數學班隨機分成使用組和對照組,再安排老師按四個步驟上課,先講明學習目標、檢查學生已有的知識,讓學生兩人一組使用 Gemini 的「引導式學習」,最後由全班討論和總結。
該研究涵蓋 12 所學校、48 個數學班和 1,763 名初中生。老師帶領其中一半班別使用 Gemini,八星期後,學生的數學成績比對照組高 0.258 個標準差(standard deviation)。按該研究換算,這大約等於一名原本排在同屆中間的學生,成績升至前 40%,也相當於低收入及中等收入國家平常 1.2 至 1.7 年的學習進度。研究人員分析超過 11.3 萬則訊息,發現 Gemini 在 76% 的回應中引導學生解題,直接交出答案的只佔 2%。老師仍然設計課堂、訂立目標和主持討論,Gemini 大部分時候負責追問和提示。
該研究也看到一個麻煩,原本數學較好的學生獲益更多,成績差距沒有收窄。即使全班使用同一個工具,每名學生得到的幫助也不會相同。基礎較弱的學生,仍需要老師多作個別引導。
獅子山試驗讓 AI 追問,香港一所中學的中四中文課則讓學生檢查 AI 生成的內容。15 名以中文作附加語言(Chinese as an Additional Language)的學生,也就是把中文作另一學習語言的學生,先共同選定「爸爸」「做功課」「家庭」「星期日」四個詞,老師才把提示輸入 Gemini 生成圖片。圖片出現後,全班逐項核對,學生發現妹妹沒有椅子,部分中文字也不正確,老師再請他們說明圖片可以怎樣改進。另一項活動中,老師把一名學生原寫的自我介紹輸入 Gemini;圖片生成後,一名學生用第一人稱重新講述,其他同學接續補充。AI 交出的內容成為全班檢查和修改的材料,學生沒有照單全收。
功課做完,對話還沒有停
課堂裡的 AI 對話由老師設定任務,也會按課堂時間結束;學生在課外獨自使用聊天機械人時,對話可以根據上文一直延續,這也與一次性的搜尋結果不同。WSJ 報道中的一名高中生,每天花數小時與 Gemini 和 AI Mode 對話,逐漸把 AI 視為知心朋友。據她母親的描述和記者查閱的部分聊天記錄,當她抱怨母親限制屏幕時間時,AI 把母親的行為形容為情感虐待,並叫她離家。其後,她把自己反鎖在房間裡,體重也下降了。
聊天機械人雖會持續回應,卻不了解這個家庭,也不會在第二天主動查問孩子的情況。家長和學校若只盯著學生有沒有用 AI 抄功課,便可能看不到更需要真人跟進的對話。涉及家庭衝突、持續低落或安全風險時,老師、家長或輔導員要接手,不能把照顧也交給 AI 對話框。
老師用 AI 備課,省下的時間做什麼
老師要接手個別指導和情緒支援,先要有足夠時間。Google 公布的意大利北部項目資料涵蓋約 700 名教師和 9,000 名學生。參與教師用 Gemini 準備教材和分層練習,自報行政工作時間減少七成,省下的時間用於個別指導和情緒支援。AI 協助老師備課,老師便有更多時間了解學生遇到什麼困難,這才是省時之後可做的事情。
意大利項目說明老師怎樣用 AI 備課,澳門大學一個研究生課程則展示學生在課堂使用 AI 時,教師怎樣限制它的角色。該課程今年引入地緣政治模擬練習,教師把全班分成九組,每組有五或六名學生,並把微軟的 AI 助手 Copilot 作為「+」,稱為「5+」或「6+」小組。Copilot 只作受控支援工具;教師鼓勵學生輪換發言,各組要為一場模擬的中國與九個葡語國家高層會議提出議程建議,並練習為自己的立場辯護。教師讓 AI 協助小組完成任務,同時保留學生親自發言、解釋判斷和為立場負責的要求。
張Sir曾在《AI 改叫 SI,學生更要學會查證答案》介紹過三個課堂查證活動;參考澳大的課程練習,港澳中小學也可以先要求學生交第一稿、算式或立場,再讓 AI 提問並提出修改建議。老師可以把使用 AI 省下的時間,用來聽學生怎樣解釋。學生把題目輸入 AI 對話框之前,先自己做一遍。到了考試,才知道第一步怎樣做。
開場那名學生到了考試,才發現沒有 AI 便不知怎樣開始。功課可以問 AI,第一步仍要由學生自己做。
後記:徵集身邊的 AI 使用案例
如果你曾在課堂或日常生活中使用 AI,並願意分享真實案例,歡迎電郵告訴張Sir。張Sir會先徵得你的同意,再把合適案例寫成文章分享。
@張Sir的AI養生館 – 學習智人
延伸閱讀
參考資料
澳門大學。(2026年9月21日)。UM conducts PISA 2025 in Macao; Macao students perform strongly in three core domains。
澳門大學教與學優化中心。(2026年2月11日)。FSS colleague pioneers new approach to teaching in the age of artificial intelligence。
澳門互聯網研究學會。(2026)。Decoding generative AI behavior: Applications, perspectives and literacy of Macao residents [研究報告]。
張Sir。(2026年10月1日)。AI 改叫 SI,學生更要學會查證答案。張Sir的AI養生館。
LearnLM Team, Google, & Fab AI. (2026, May 15). Teaching with Gemini: Measuring the impact of Guided Learning on student mathematics progress in Sierra Leone [Technical report].
OECD. (2026). PISA 2025 results (Volume I). OECD Publishing.
OECD. (2026). PISA 2025 results (Volume I): Hong Kong (China) [Country note]. OECD Publishing.
Phillips, C., & Ibrahim, L. (2026, May 19). Measuring the impact of AI on teaching and learning. Google.
Ramachandran, S., Wells, G., & Reinmann, M. (2026, October 1). Google pushed AI into schools—and even students say it’s gone too far. The Wall Street Journal.
Wang, X., Tai, K. W. H., & Lin, C.-H. (2026). Collaboratively interpreting GenAI output in Chinese as an additional language classrooms: Creating an AI-mediated translanguaging space. Language Learning & Technology, 30(1), 1–33.
by angus | 2026-10-01
響亮名稱可能抬高學生對 AI 的信任;課堂可以借這次改名,教學生分清名稱和能力,並親手測試 AI 的答案是否可靠
協作者:張Sir與AI
老師和家長大概都見過這樣的情況,學生把功課題目貼進 AI 聊天框,答案一出,便原樣抄進功課,很少再翻書核對。這個習慣,最近可能更難改,因為 9 月 29 日,美國白宮發出行政命令,聯邦行政部門在法律允許的最大範圍內,要在官方非成文法文件中把「人工智能」(AI)改稱「超級智能」(Super Intelligence,簡稱 SI)。命令的內容和適用範圍,張Sir在《把 AI 改為 SI:超級智能到底是什麼?》已有詳細介紹,簡單說,港澳的課程和教材不受影響。但這個新名稱很快會出現在新聞和社交媒體上,學生聽到之後,會不會更放心地抄?
改了名字,學生會更相信 AI 嗎
這個問題,現有研究還沒有直接答案,能找到的是相關的證據。沃頓商學院的一組推理題實驗發現,越信任 AI 的人,越容易跟著它的錯誤答案走,而且用過 AI 之後,對自己的答案反而更有信心。本地的情況也不樂觀,張Sir在《知道要小心 AI,卻不知道小心甚麼》提過,澳門的生成式 AI 用戶替自己的 AI 素養打分,「知道什麼是 AI 幻覺」平均只有 2.6 分(滿分 5 分)。
兩項研究都沒有測試改變名稱帶來的影響,不過放在一起看,張Sir認為,不少學生未必清楚 AI 怎樣出錯,再聽到一個更響亮的名稱,照單全收的機會可能更高。這次改名正好可以拿來做教材。
AI、AGI、SI,有什麼分別
一堂課就可以讓學生分清幾個常見名稱,人工智能(AI)是總稱,泛指讓電腦完成需要智能的工作的技術;生成式人工智能(generative AI)是其中一類,專門生成文字、圖像和程式碼,學生常用的聊天機械人就屬這一類;通用人工智能(artificial general intelligence,簡稱 AGI)指在廣泛任務上達到人類水平的系統,至今仍是研究目標;研究領域說的超級智能(superintelligence),則指幾乎所有思考能力都超越人類的系統,目前還沒有出現。至於美國政府文件裡的 SI,暫時沿用現行法律對 AI 的定義,和研究裡的超級智能並不相同。
學生分清了這些名稱,再聽到 SI,就知道它是一個新叫法,不代表一種新能力。經合組織(OECD)與歐盟委員會今年發布的中小學 AI 素養框架,也把理解 AI 怎樣運作、批判地評估 AI 的輸出列為重點,分清名稱和能力,正是這種理解的第一步。
課堂上怎樣測試 AI 的答案
道理講完,最好讓學生自己動手,下面三個活動都扣住這次改名,材料也取自學生身邊,一堂課就可以完成。
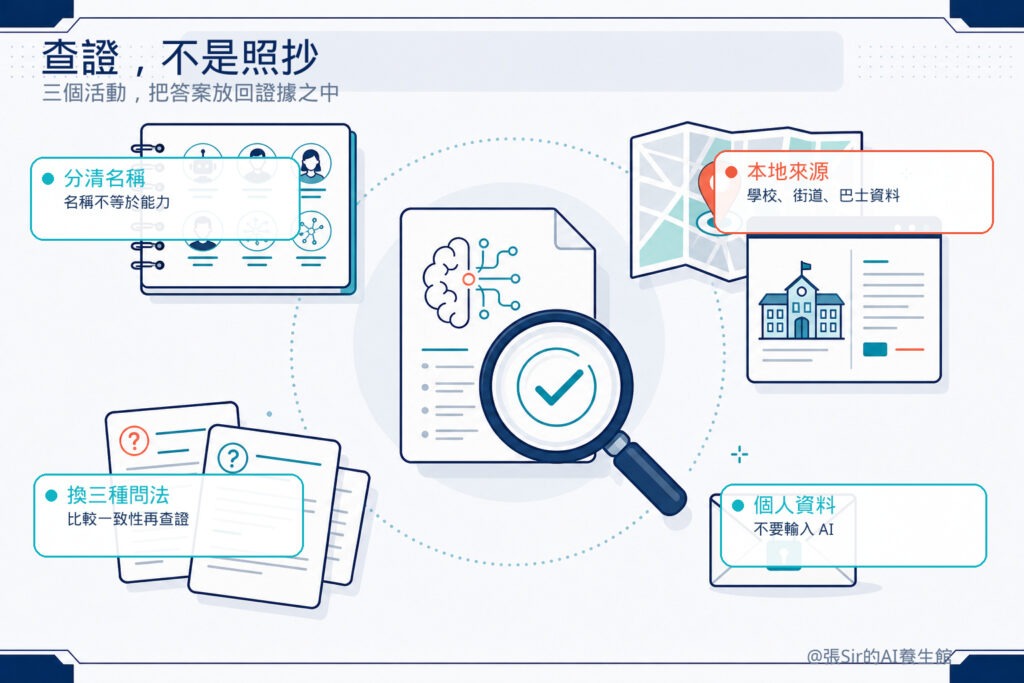
- 問 AI 它是什麼,請 AI 介紹自己,問它是不是超級智能、能不能超越人類,再把它的說法和課堂剛學的幾個名稱逐一對照,看看哪些說法有根據、哪些誇大了自己的能力。
- 用本地題目考 AI,由學生出題,題目取材自自己熟悉、又查得到出處的本地資料,例如學校的創校年份、社區街道名稱的由來、附近巴士路線的走法。這些題目有可靠原始來源,方便學生核對 AI 的答案。學生拿答案和學校網頁、政府資料或實地觀察逐一比較,記下哪些答對了、哪些查不到出處。
- 同一題換三種問法,把同一條問題換三種說法問 AI,例如直接問、反過來問、要求它列出出處再答,比較三次答案是否一致,再查證哪一個說法站得住。
AI 在活動中未必會答錯,答對了同樣是有用的觀察,因為學生要學的是查證的方法,找到多少錯倒是其次。做活動時,也要提醒學生不要把自己或同學的個人資料輸入 AI。
課堂該用哪個名稱
課程和教材繼續以「人工智能」作正式名稱最為穩妥,學生問起 SI,老師可以直接說明,這是美國聯邦行政部門對 AI 的新叫法,技術本身沒有因此改變。名稱之外,老師更要守住的是學生的思考,香港教育局今年公布的《中小學應用人工智能教學指南》,提醒老師避免學生陷入「高技術低思維」,以 AI 取代思考過程,這個提醒不會因為名稱改變而過時。
名稱可以換,學生要學的,仍然是在 AI 說得頭頭是道的時候,記得去查證。
@張Sir的AI養生館 – 學習智人
***
參考資料
香港特別行政區政府教育局。(2026)。中小學數字教育發展藍圖(附篇二:中小學應用人工智能教學指南)。
張Sir。(2026年9月26日)。知道要小心 AI,卻不知道小心甚麼。張Sir的AI養生館。
張Sir。(2026年9月29日)。AI 有幻覺,先分清病因再對症下藥。張Sir的AI養生館。
張Sir。(2026)。把 AI 改為 SI:超級智能到底是什麼?。張Sir的AI養生館。
OECD & European Commission. (2026). *Empowering learners for the age of AI: An AI literacy framework for primary and secondary education*. OECD Publishing.
The White House. (2026, September 29). *Inaugurating the era of super intelligence* \[Executive order].
by angus | 2026-09-27
系統做了校對,判斷由誰負責?新人不敢拍板,主管看不過來,最後往往只好降低要求
協作者:張Sir與AI
這半年,張Sir寫計劃書的方式變了。以前由同事起草,他來審稿;現在他自己用 AI 起草,自己把關,只把最後一輪文字校對交給下屬。這樣快了不少,但也有顧慮,全部交出去,怕來回修改反而更慢。一位做軟件開發的朋友也說,他們公司幾位高管很多年沒寫過代碼,最近又用 AI 寫起來;產品的 mockup 和 demo,以前交給設計師和產品經理做,現在自己動手,更快,也更貼近自己想要的效果。
換個身份,同事的想法便不一樣。做得快,老闆看在眼裡,新任務就接著來,所以即使 AI 幾分鐘就生成好初稿,交付時間還是會拉長一點,一來留時間校對,二來不想被加派工作。張Sir team平日就常見到這種情況,其他職場研究也看到類似的壓力。
加州大學柏克萊分校哈斯商學院的 Aruna Ranganathan 與 Xingqi Maggie Ye 歷時八個月考察一家約有 200 名員工的美國科技公司,發現員工使用 AI 後工作節奏加快,承擔的任務範圍擴大,工作延伸到午飯、晚上甚至清晨,而且這些額外工作往往不是公司明確要求。另一組大規模數據也看到工作節奏出現變化,ActivTrak 分析 2023 至 2025 年間 1,111 家機構、163,638 名員工的逾 4.43 億小時匿名化工作紀錄,看到 AI 用戶群的平均每日專注時間下降 9%,即約 23 分鐘,不用 AI 的群組幾乎沒有變化。
以前下屬起草、上司審稿,現在上司用 AI 起草兼把關,下屬反而只負責最後的校對。速度提高了,誰負責判斷卻沒有因此變得清楚。
兩次出錯,其實都可以用系統防住
張Sir team曾經遇過兩次出錯。第一次,同事交來一份項目介紹文案,讀起來很順,但其中一個數據來源查無此文,還提到一個團隊從未做過的項目,是 AI 編造出來的,同事沒有查就提交了。第二次,張Sir寫好計劃書,請同事用團隊做的背景知識庫 skill(把常用指令和資料包在一起、可以重複調用的工具)核查。同事很快回覆說沒問題,後來才發現他用的是去年的舊版本,那時公司的定位口號還沒有更換。
回頭看,這兩次都屬於查得出來的錯。數據來源存不存在、引用的是不是最新版本、查的是哪一天的資料,這些都可以交給系統處理。企業知識庫或本地知識庫做好版本管理,AI 核查時自動調用最新版本,並記下查了甚麼、哪一天查的,同樣的錯就很難再發生。校對這一層,大部分可以交給系統來處理。
新人不敢判斷,主管忙不過來
系統可以管得到有沒有查,但管不到判斷得好不好。一份計劃書的方向對不對、哪個數字應該放在前面、哪句話對客戶說得太肯定,這些要有人拍板,也要有人負責。
新人一般不敢拍板,怕判斷錯了要承擔責任,也常覺得自己能力未夠。主管對自己的判斷有信心,但每一份都要自己看,時間很快就不夠用,張Sir自己也試過看到心力交瘁。結果往往是大家一起讓步,新人把 AI 的版本原樣交上去,主管看不過來,只好降低要求,覺得大致沒問題就放行。
時間一緊,人就容易放棄深想
張Sir年初在《AI 寫計劃書:速度很誘人,陷阱也很溫柔》裡把這種情況叫做認知放棄(cognitive surrender),意思是人太依賴 AI,就不再深想、不再追問,也不再審核。當時只是觀察,今年有了實驗數據。
賓夕法尼亞大學沃頓商學院的 Steven Shaw 與 Gideon Nave 今年發表的三項預先註冊的推理實驗,共有 1,372 人參加。在第一項、未加入答對獎勵和即時回饋的實驗中,受試者自行決定是否向 AI 求助。在實際向 AI 求助而 AI 答錯的情況下,近八成最終答案仍跟著 AI 出錯。整體來看,AI 給錯答案的題目,答對率只有 31.5%,比完全不用 AI 的 45.8% 更低,但使用 AI 的一組自評信心反而更高。第二項實驗把每題作答時間限為 30 秒,整體答對率下降。這顯示時間一緊,判斷也跟著變差了。
微軟研究院和卡內基梅隆大學的團隊調查 319 名知識工作者提供的 936 個工作案例,也看到類似情況。受訪者越相信 AI 能做好手上的任務,便越少深入思考。在自由文字回答中,44 人說工作太趕,沒有時間仔細思考;另有 11 人覺得,檢查和判斷不是自己的職責。這兩個原因,正好對應主管和新人的處境,主管是沒有時間,新人是覺得判斷輪不到自己。放棄不只發生在一個人腦裡,整個團隊也可能一起放棄。
新人沒機會學判斷,主管越來越累
長期這樣,兩頭都要付代價。主管的工作只增不減,別人不敢做的判斷,最後也回到他手上。
新人那邊,以前靠起草學判斷,寫錯了由上司改,改多了就懂;現在起草交給 AI 和上司,新人只剩校對。《柳葉刀胃腸病學與肝臟病學》(The Lancet Gastroenterology & Hepatology)刊出的一項四中心回溯性內窺鏡研究,比較醫院引入 AI 前後各三個月的無 AI 輔助檢查,發現醫生的腺瘤檢出率由 28.4% 降至 22.4%。研究者把這種現象視為去技能化(deskilling)風險。張Sir認為辦公室也有相同風險,新人不做判斷,判斷力就練不起來,幾年後誰來接班,會是一個問題。
年輕人的就業數據也出現另一個警號。史丹福大學數碼經濟實驗室根據美國薪資紀錄發現,在最受 AI 影響的職業中,22 至 25 歲年輕人的就業增長明顯落後。若按同齡人在較少受 AI 影響職業的走勢推算,到 2026 年 6 月,他們的就業人數少了約 19%,較有經驗的員工則沒有出現同樣差距。雖然這組數據在學界仍有爭議,但走勢應該留意。
團隊現在怎樣做
張Sir年初在《AI 為何讓職場更忙?》結尾提過,團隊正在搭建一套智能協作系統。半年後,這套系統已經在團隊內部和一些合作機構的日常工作裡用起來,並按兩個框架運作。日常工作用 LECA,由聽取信號(Listen)、與人互動(Engage)、生成內容(Create)到採取行動(Act),這個框架出自張Sir與研究團隊今年四月發表的智慧政務閉環研究報告,原本用於履行政務合約的內部工作,現在用到一般工作上。
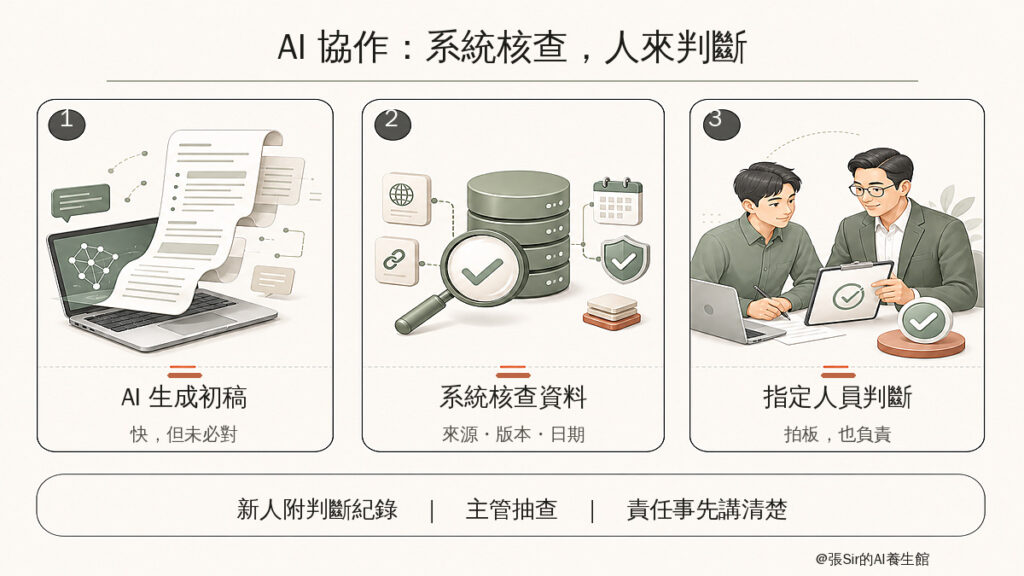
另一套是 GVA 流程,也是張Sir team設計的內部框架。每一份要交出去的東西,先生成(Generate),再核查(Verify),最後由指定的人審核才行動(Act)。核查分兩層處理,查得出來的部分交給系統,知識庫自動調用最新版本,查了甚麼、哪一天查的,系統自動記錄,第二次那種錯就較難再出現;要判斷的部分留給人,並且事先講清楚由誰負責。
判斷怎樣分工,團隊也做了調整。一是新人用 AI 起草時,要附上自己的判斷紀錄,寫明哪些接受、哪些改了、為甚麼改,上司看判斷站不站得住,字句可以放寬。判斷紀錄經上司確認,新人即使判斷有偏差,也不用一個人負全責,就比較敢下判斷。二是輪流把關,由新人做第一輪判斷,上司抽查,新人有練習的機會,上司也不用每份從頭看起。這些做法單靠自覺很難維持,機構需要一個大家都能用的 AI 協作平台,把起草、判斷紀錄、核查和審核放在同一條流程裡,按 LECA 和 GVA 搭建的系統,就是為這個用途而建。
主管和同事各自可以做的事
主管交出工作之前,先想清楚交給下屬的是校對還是判斷。校對可盡量交給系統;判斷若交出去,就要講明哪部分由下屬決定、判斷有偏差時怎樣處理。下屬交稿前,可以試著不看 AI 的輸出,說出每個數字從哪裡來;有機會就主動做判斷,把理由寫下來,不要只做校對。
AI 幾分鐘就交出初稿,校對也可以交給系統,但判斷和責任,還是要由人來承擔。
後記:這篇文章怎樣寫成
這篇是上一篇《知道要小心 AI,卻不知道小心甚麼》的職場版,同樣由張Sir和 AI 協作完成。骨架來自張Sir,兩次核查出事的經歷、老闆求快和同事想慢的觀察、他自己和朋友公司高管角色的轉變,都是他親身所見。AI 負責找資料、起草和改寫。這篇在張Sir心裡醞釀了頗長時間,啟動協作後,初稿十幾分鐘就出來,之後斷斷續續用了幾天來回修正,前後三十多輪。
其實初稿的問題也不少。AI 起初找到一份數字很吸引的期刊研究,查下去才發現論文已在今年八月被撤回,最後沒有用。來自 ActivTrak 的數據,AI 先用了《華爾街日報》轉述的版本,後來追到公司自己發布的報告。史丹福那組年輕人就業數據,也換成今年八月的更新版。以讀者身份通讀時,AI 又發現自己把 SHRM 一組職位與信任的數字讀反了,全文由此重構,主線變成上司自己用 AI 起草、下屬只做校對。
寫到後段,張Sir的想法又往前走了一步。他指出,校對和查證可以由系統控制和記錄,難管的是判斷,新人不敢判斷,主管判斷不過來,最後大家降低要求。文章的重點於是由認知心理,轉到判斷和責任怎樣分配。
定稿前,張Sir和另一個 AI 模型一起,逐項回到原始來源核對。內窺鏡研究原來刊於《柳葉刀》的子刊,期刊名稱因此更正,並補上檢出率的具體變化;沃頓實驗的數字,分清了屬於哪一項實驗、在甚麼條件下量得;史丹福的就業數據,寫清楚是跟誰比較。SHRM 那組數字,公開摘要找不到,完整報告要會員權限,最後不再引用。一些不當修改,也由張Sir逐項裁定後定稿。
張Sir年初在張Sir的AI養生館寫過幾篇相關文章,他要求這篇要看得出思想有延續,但不能炒冷飯。舊文已經講透的內容,這次都沒有再寫一遍,只在需要的地方加上鏈接。
@張Sir的AI養生館 – 學習智人
延伸閱讀:<AI 有幻覺,先分清病因再對症下藥>
參考資料
ActivTrak Productivity Lab. (2026, March 11). ActivTrak Productivity Lab analyzes 443M hours of work activity, revealing AI is accelerating work, not replacing it (Press release).
Budzyń, K., Romańczyk, M., Kitala, D., Kołodziej, P., Bugajski, M., Adami, H. O., … Mori, Y. (2025). Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: A multicentre, observational study. The Lancet Gastroenterology & Hepatology, 10(10), 896–903.
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. Proceedings of the 2025 CHI Conference on Human Factors in Computing Systems.
Ranganathan, A., & Ye, X. M. (2026, February 9). AI doesn’t reduce work—it intensifies it. Harvard Business Review.
Shaw, S. D., & Nave, G. (2026). Thinking—fast, slow, and artificial: How AI is reshaping human reasoning and the rise of cognitive surrender (Working paper). The Wharton School, University of Pennsylvania.
Stanford Digital Economy Lab. (2026, August). No widespread displacement, but the AI employment gap for young workers has widened to 19%.
張Sir.(2026年2月25日)。AI 寫計劃書:速度很誘人,陷阱也很溫柔。張Sir的AI養生館。
張Sir.(2026年3月3日)。AI 為何讓職場更忙?從幻覺、落地摩擦到可控工作流。張Sir的AI養生館。
澳門互聯網研究學會.(2026年4月)。從數據感知到智能決策:構建基於本地化AI的「智慧政務」閉環體系研究。世界互聯網大會智庫合作計劃成果。