從本地部署到全棧數據治理,政府及企業選擇 AI 方案時還要看甚麼
最近內地接連出現兩宗 AI 數據安全事件。第一宗,用戶原以為請求由正在使用的 AI 產品直接處理,卻未必知道數據可能在背後被轉交至另一家公司的模型。第二宗,使用者在本機安裝 AI 編程工具,工具卻在背景建立整個工作區的快照,並嘗試送上雲端。
在這兩宗事件中,用戶都未曾主動將敏感數據提供給任何第三方,數據卻沿着產品預設的路徑流了出去。
兩宗事件,揭示同一條數據鏈
2026 年 9 月,Anthropic 指部分內地 AI 服務把用戶請求轉交 Claude 處理,再將結果返回原有產品。據《香港01》引述報告,部分請求涉及企業代碼、登錄憑證及政府相關數據;有關指控仍須更多獨立證據核實。
同月,內地多家媒體報導,智譜旗下 AI 編程助手 ZCode 被發現會在背景建立本地工作區快照,並嘗試上傳至外部雲端。事件曝光後,智譜移除相關功能、發佈修正版並開源 ZCode,表示相關數據從未用於模型訓練。
兩宗事件指向同一個採購盲點:界面上的品牌名稱,交代不了完整的數據路徑。供應商可能調用第三方模型、雲服務或分包商,客戶端的預設功能也可能擴大數據流向。機構採購的其實是一整條數據處理鏈,模型或界面只是其中一環。
管好內部使用,還要看供應商
政府部門和企業近來都在訂立 AI 使用守則:哪些文件不能上傳、哪些數據要先刪去身份信息、哪些工作要由主管批准,規定愈來愈仔細。內部人員管住了,下一個問題便是:供應商在後台怎樣處理數據,機構看得見嗎?
當前,不少 AI 使用守則首先規範員工,這一步必須做。供應商一端也要有另一張清單:
- 產品實際調用哪一個模型?
- 數據會經過哪些服務器及地區?
- 系統會否連接第三方接口或分包服務?
- 供應商的技術人員能否遠程接觸客戶數據?
- 輸入、輸出及系統日誌會保存多久?
- 數據會否用於模型訓練或產品改進?
- 發生事故後,機構能否取得完整紀錄?
這些問題有些要寫進合約,有些要從系統架構、權限設定及日誌中核實。單靠一句「我們重視數據安全」,回答不了。
本地部署也不會自動安全
把 AI 部署在本地,有助收窄數據流動範圍,但不會自動切斷所有外部連接。服務器即使設於自己的機房,系統仍可能連接外網,應用仍可能取得過大的文件權限,模型也可能透過接口調用外部服務。
本地部署主要回答核心系統和數據存在哪裡,其餘環節仍要逐一管控。一套可管理的 AI 環境,至少要控制外部連接,按職責設定數據權限,限定每個應用可調用的知識範圍,為敏感操作加入審批及人工覆核,並保留模型調用、文件存取及輸出日誌。供應商的運維權限也要有範圍、有時限、有紀錄。
採購前,先要一張數據流向圖
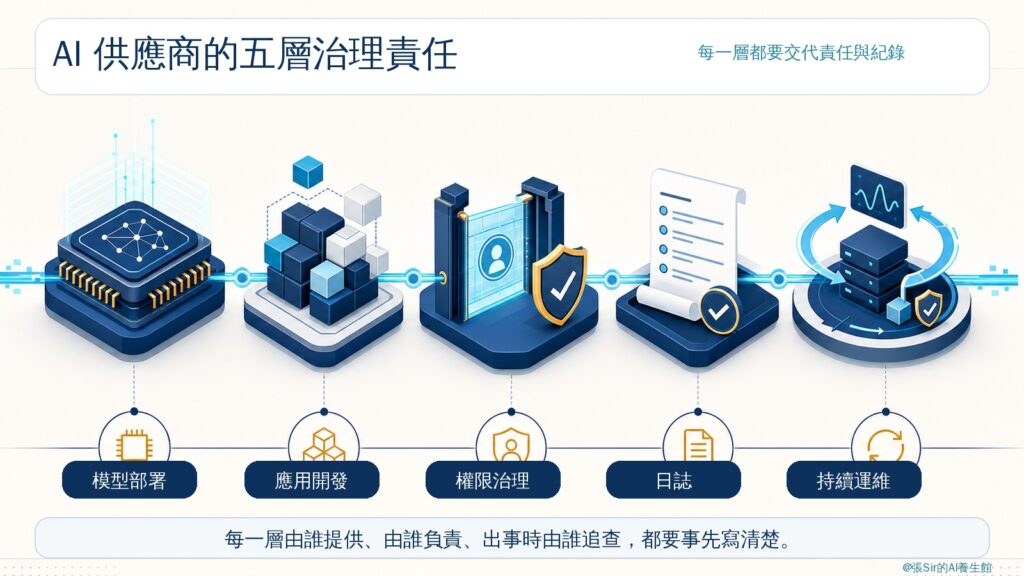
機構評估 AI 供應商,不能只比較模型能力或硬件規格,還要同時檢視模型部署、應用開發、權限治理、日誌及持續運維。每一層由誰提供、由誰負責、出事時由誰追查,都要事先寫清楚。層與層之間一旦留白,發生數據事故時便難以釐清責任。
機構可以在採購前要求供應商畫出一張完整的數據流向圖:數據從哪裡進入、經過哪些模型和服務器、誰能接觸、保存多久,以及每一步留下甚麼紀錄。能把這張圖交代清楚,機構才有足夠依據判斷供應商是否可信。
協作者:張Sir與AI
參考資料
香港01。(2026年9月12日)。〈Anthropic指中國AI公司蒸餾攻擊 敏感資料也送交 北京反駁報告〉。
財新網。(2026年9月21日)。〈智譜被指未經用戶允許上傳數據 隨後致歉並開源ZCode〉。
第一財經。(2026年9月21日)。〈智譜完成ZCode開源並整改,承諾相關代碼數據未用於模型訓練〉。
36氪。(2026年9月20日)。〈智譜ZCode傳包風波,那些沒回答的事〉。