AI 套語和句式都改過,全文為甚麼仍然不像自己寫的
刪掉「不是……而是……」和幾種變體,我把稿子再交給同事看。他看完仍然只說:「讀起來有點怪。」具體哪一句有問題,他一時講不出來,只覺得這篇文章不像我平常的文字。
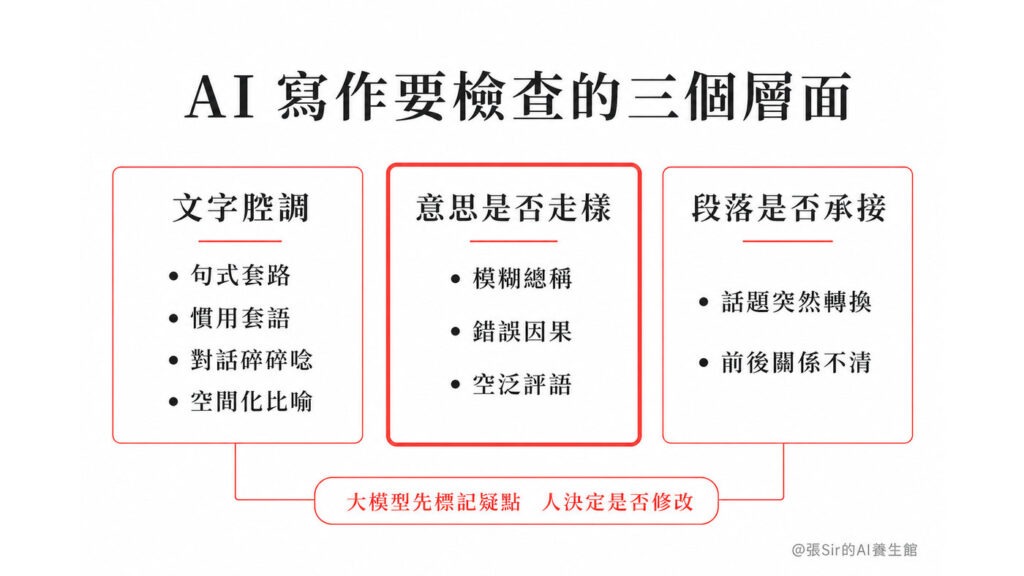
上一篇結尾提到三類問題,包括句式套路、慣用套語和寫作旁白,當時預告下一篇會逐句檢查。這三類問題依然存在,現在的處理方式卻有所不同。之前主要靠禁用清單逐個搜,目前的大模型已能在篇幅合適時讀完整篇文章,再按照人工確認過的案例,找出字面不同、寫法相近的句子。
第一類是句式套路
「不是 A,而是 B」仍是最先要看的句式,因為它正是上一篇和本篇標題所追問的問題。「A 沒有錯,只是 B」和「問題不在 A,關鍵在 B」只是換了連接詞,寫法沒有改變。比如「問題不在 AI 能力,而在作者判斷」,便把兩個可能同時存在的問題寫成二選一;直接改成「AI 可能漏判或誤判,作者也要決定哪些修改可以接受」,意思更準確。
「真正的 X,從來不是 Y」和「你以為 A,其實是 B」也屬於同一家族,前者替讀者重新定義,後者先替讀者安排一個想法,再用「其實」翻轉。大模型可以先找出結構相近的句子,人再判斷兩邊有沒有根據。作者真的在記錄自己前後認知的改變,可以保留「原以為……後來發現……」;替讀者預設想法的句子,直接寫結論通常更自然。
第二類是慣用套語
再看套語,「值得注意的是」、「總體而言」等說法在字面上最容易認出。以「值得注意的是,登入流程仍然相當繁複」為例,刪掉開頭幾個字,後半句依然沒有說明登入究竟麻煩在哪裡。在報告類協作裡,假如資料寫明登入要經過三個頁面,第二頁還要重新輸入帳號,直接把這些情況寫出來便夠了。
把禁用清單、作者過去的文章和人工確認過的改稿案例交給大模型,它可以標記清單內的套語,也能找出「值得一提」、「整體來看」等近義變體。審稿結果要列出原句和位置,方便作者逐項確認。
第三類是對話碎碎唸
上一篇暫時把第三類叫作「寫作旁白」,更準確的說法是人機對話殘留(或碎碎唸)。跟 AI 對話時,「你說得對,剛才我忽略了一條規則」、「我會先檢查全文,再給你修改版」、「審核通過,可以發表」都是正常回應。這些話若原封不動出現在文章裡,讀者看到的便只是作者和 AI 的後台對話。
「審核通過,可以發表」可以直接刪掉;「你說得對,剛才我忽略了段落承接」若包含有用信息,可以改成「早期稿由套語直接轉到概念命名,兩段缺少承接」。對話裡的確認、道歉、工作安排和進度報告,都要先判斷有沒有正文需要的內容,再決定刪除或改寫。
前三類主要讓文字帶上容易辨認的 AI 腔調,逐段往下讀,還會遇到四個更深的問題:一個總稱代替幾件不同的事、空間化比喻反覆出現、並列資料被寫成因果,以及評語沒有增加內容。
「使用門檻」代替了三個不同問題
假設一份企業稿同時提到培訓不足、審批權限不清和舊數據搬不過去,AI 卻把三個問題一律稱為「使用門檻」。後續分析繼續使用這個總稱,沒有再說明每個問題的原因和做法。讀者因而無法知道公司應該補培訓、釐清審批權限,還是安排數據遷移。
幾種情況可以同屬一個大概念,但原因和處理方法不同,分析時便要逐項交代。「使用門檻」這個總稱如令這些差異消失,便不應代替具體名稱。
生活裡也有相同情況,例如小朋友晚飯後不肯做功課,可能是看不懂題目、太累,或者只想玩手機。AI 若一律寫成「學習動機不足」,家長看完仍然不知道要先講解題目、讓孩子休息,還是收起手機。總稱省了幾個字,三件事的處理方法也跟着不見了。
空間化比喻用成了固定腔調
另一個一直被漏掉的習慣,是用空間動詞描寫抽象的東西,例如「信號散在句子之間」、「問題落在字面上」、「意思藏在細節裡」。這類空間化比喻偶爾使用沒有問題,反覆出現時,文章便會帶着同一種腔調,像是每個抽象概念都有一個位置。
我自己在寫這篇稿子時就中招。
回查「散在」、「落在」、「藏在」、「放進」、「擺在」、「飄在」六組空間動詞,上一篇發布版和本篇初稿共有七次實際用例,三次已出現在上一篇。這次修改經過多輪核稿仍有殘留,說明我們沒有在一輪檢查中改乾淨。
並列功能被寫成因果
假設一份產品報告的材料只列出手機審批、統一文件格式和保留操作記錄三項功能,AI 卻寫成:「手機審批省下時間,團隊便有餘力統一文件;格式統一之後,操作記錄自然也更完整。」材料沒有說前一項會造成後一項,這段因果關係是 AI 寫稿時加上去的。
研究報告、政策分析或產品文件的核稿,還要逐句對照原始材料。先確認材料談的是同一對象和同一時段,再檢查它是否真的說明前一件事造成後一件事。材料只說兩者相關,文章也只能寫成相關;只列出幾項功能,便按並列方式寫。
「很實在」沒有增加內容
這次審稿多次遇到「原因很實在」、「說法很直接」、「做法很到位」、「邏輯很清晰」和「這一點很關鍵」等句子。這類「很+評價詞」幾乎可以接在任何題目後面,聽起來像已經下了結論,實際只告訴讀者作者的態度,沒有增加判斷標準或新內容,也容易因為句子通順而被放過。
文章寫完「這個做法不需要額外添置設備」,若隨即再加一句「這個建議很實在」,後一句便可以刪掉。即使後面附有理由,也通常只需保留理由,例如直接寫「現有電腦已經能運行,不用再批一筆設備預算」。報告材料沒有交代成本或工作影響,便標記為待查,不要讓 AI 自行補寫。核稿時看到「很實在」、「很直接」、「很到位」、「很清晰」、「很有意思」,可以先拿掉評語再讀一次;意思沒有減少,便不用放回去。
上面四類問題大多在一段之內已能看出端倪,其中因果是否有根據,還要對照原始材料。另一些問題則要把相鄰幾段連起來讀才看得出來。
單段沒有語病,段落之間卻缺少承接
這篇文章的早期版本曾幾次突然轉題,上一段談固定套語,下一段直接改談概念命名,沒有說明兩者都會以簡略說法代替具體內容。其後談到比喻和檢查步驟時,也沒有交代它們跟前文有甚麼關係。
「接下來看看」本身是正常的文章過渡語;若前後兩段有實質關係,仍要把關係說清楚。例如,把固定套語清單交給大模型,它可以先標記命中位置;同一名稱在前後句是否仍指同一件事,則要比較上下文。這樣才能說明文章為甚麼由套語轉去概念檢查。
大模型可以先概括每段實際說了甚麼,再比較相鄰兩段是否談同一問題,以及後一段是在補充證據,還是轉到新問題。兩段如果聲稱前後相承,讀者卻看不出中間關係,便要重寫段首、補足關係,或調整段落次序;文章合理轉入另一個新問題時,不必勉強替兩段補上因果。
寫完後,讓大模型通讀一次
一般寫稿可以先把全文、禁用清單和幾個已確認的改稿例子交給大模型,請它列出可疑句子的原文和位置,說明問題,再提出改法。需要比較個人語氣時,才補充自己過去的文章;研究報告或產品文件則另附原始材料,涉及事實和因果的修改仍要由人核對。
大模型列出的結果不等於定稿。作者要逐項決定問題是否成立,改句有沒有偏離原意,以及自己的用詞和語氣是否被改掉。這篇文章由我一個人和AI協作去寫,一句話是否保留,可以按個人判斷決定;換成十幾個人一起寫,便要說清楚修改理由和共同標準。機構團隊怎樣記錄這些判斷,讓各人按同一準則核稿,會是下一篇要處理的問題。
協作者:張Sir和AI
後記
這篇文章先後跟模型 C 和模型 G 協作,按現有文件和兩邊復盤,至少經過十五個主要版本、超過四十輪討論和逐段修改。這次來回特別多,因為我們一邊改文章,一邊建立審稿規則,不代表每篇稿都要經過相同輪數。後幾個版本花的時間更多,主要用來判斷哪些建議可以接受,以及改句有沒有偏離張Sir原來的意思和語氣。
整個協作中最重要的一次衝突,發生在「我自己在寫這篇稿子時就中招。」這句。張Sir認為它是整段的精華,模型 G 卻因為這句命中「不要用短句替整段定調」的規則,擅自改成較平滑的長句。張Sir要求恢復原句後,模型 G 這樣回答:
因為我把「避免段首短句」這條規則放在你的明確取捨之上,擅自把原句改成較平滑的版本。這是錯的。規則服務作者,不能反過來磨掉作者認為最有力的一句。
這次衝突說明,大模型可以讀規則,執行時仍會漏;交叉審讀不能取代作者判斷;規則寫進文件,也不代表每次都會真正執行。這段坦白後來被放在張Sir的通用審稿規則文件的開頭,成為最高原則。AI 能加快起稿和初步審讀,最後的取捨仍由人負責;每次接受或拒絕修改的理由保存下來,下一次才有可靠案例可以參考。