by angus | 2026-09-26
學生用 AI 做功課快了,錯誤也多了。做功課要先想、再用,並交代思考過程
協作者:張Sir與AI
這半年,張Sir聽過不少家長、老師和學生談 AI 做功課。學生說,功課快多了。家長也輕鬆了,還說終於有信心輔導孩子,AI 在背後幫了不少忙。老師以前很在意學生有沒有用 AI,現在習慣了,不太去查,自己備課也快得多。大家起初都說滿意,多聊兩句,幾句抱怨便陸續出來:錯誤多,論證費時,推理過程沒人細看。生成式 AI,「生」就「成」了。
澳門互聯網研究學會今年六月在世界互聯網項目年會發表居民調查結果,七月再於網站刊出報告及詳細數據。張Sir七月也曾撰文分析。用戶以 5 分為滿分替自己的 AI 素養打分,「使用生成式 AI 時遵守倫理道德」平均有 4.0 分,「知道甚麼是 AI 幻覺」卻只有 2.6 分。AI 幻覺(AI hallucination)就是模型寫出看似合理、其實錯誤甚至憑空捏造的內容。另有 45% 用戶說,自己從不或只是偶爾核查 AI 給出的信息。受訪用戶給自己的倫理分數頗高,對 AI 會怎樣出錯卻不太清楚,收到答案後也未必動手查。
人為甚麼會跟着 AI 答錯
用計數機計數、用手機記電話、用導航找路,都是把一小部分工作交給工具,心理學稱為認知卸載(cognitive offloading)。張Sir年初談 AI 寫作的誤區時用過這個詞。人雖然省了力,方向盤還在自己手上,因為要算甚麼、打電話給誰、去哪裡,心裡一早清楚。
按計數機之前,人已經知道自己要算哪條數,結果離不離譜也有個大概。到了 AI,答案和理由一併出現,語氣還很有把握。讀着讀着,一不留神,連要做判斷也忘了。
賓夕法尼亞大學沃頓商學院的 Steven Shaw 與 Gideon Nave 今年一月把這種情況稱為認知放棄(cognitive surrender)。他們找來一千多人做實驗,回答一些很容易憑直覺選錯的推理題,旁邊有 ChatGPT 隨時可問。研究人員暗中動了手腳,讓 ChatGPT 在一半題目給錯答案。碰到這些錯誤答案,問過 ChatGPT 的人有八成照抄,答對的反而比完全不用 AI 的人少,信心卻更高。研究人員後來改成答對一題便給獎金,也讓參加者每做完一題立即知道對錯。肯推翻錯誤答案的人由兩成升到四成多,仍然未過半。
用 AI 做功課,學到的反而少了
實驗室裡的推理題,幾分鐘便做完,對錯也很快揭曉。學生每天靠 AI 少想一步,功課照樣交得出去,影響要過一段時間才看得出來。美國皮尤研究中心去年秋天訪問 13 至 17 歲青少年,54% 表示用過聊天機器人幫忙做功課。
沃頓商學院另一個團隊在土耳其一所高中做過實驗,讓近一千名學生分三組練習數學。一組可以隨便問 GPT-4;一組使用老師設定的 GPT Tutor,裡面有教師提供的解法和常見錯誤,通常只提示,不直接給答案;第三組只用課本。隨便問 GPT-4 的學生,練習成績比課本組高 48%,收走 AI 後再考試,成績卻低了 17%。GPT Tutor 組跟課本組相比,考試成績沒有明顯差別。AI 把答案一步步寫在眼前,學生看得「熟口熟面」,很容易當成自己已經學懂。
香港大學與斯德哥爾摩大學的團隊今年六月發表一份追蹤研究。他們查看內地中部一個縣 26,811 名初一至高三學生兩年半的紀錄,再按學生開始使用 AI 的先後時間比較。研究估計,使用 AI 後,功課分數升了 18%,做功課的時間少了三成;到了閉卷月考,成績在半年內跌了 20%,約兩年後的中考和高考成績分別跌了 24% 和 18%。研究團隊發現,約八成 AI 用戶呈現「功課外判」特徵,學習損失也主要發生在這一組。使用 AI 後仍花相若時間做功課的學生,損失較小。
有些 AI 產品近年加入學習模式,只給提示,不直接交答案,做法跟土耳其實驗的 GPT Tutor 相近。不過,學生可以自行決定是否打開。追蹤研究團隊的吳延暉近日接受《人物》訪問時說,內地市面早已有逐步講解的學習工具,多數學生仍會選即時給答案的通用 AI,把省下的時間拿去做別的事。功課若只看最後答案,學生選最快的工具很自然。老師怎樣給分,很大程度決定學生怎樣用 AI。連思考過程也計分,學生才有理由打開學習模式。
內地、香港和澳門怎樣做
國家教育部基礎教育教學指導委員會 2025 年 5 月發布《中小學生成式人工智能使用指南(2025年版)》。小學生不得獨自使用開放式內容生成功能;到了初中,要開始分析 AI 內容是否合乎邏輯;高中生則可結合技術原理做探究。指南明確禁止學生把 AI 生成的內容直接當作功課或考試答案,老師也要帶學生找出 AI 文本的漏洞。
香港教育局今年六月公布《中小學數字教育發展藍圖》。當中的《中小學應用人工智能教學指南》提醒老師,學生若用 AI 代替思考,容易變成「高技術低思維」。功課不宜讓學生直接提交 AI 生成的內容;老師可在課堂上即時口頭查問,也可要求學生交出思考過程。教育局去年底的調查顯示,54.2% 小學和 70.2% 中學已有至少一半老師使用 AI 輔助教學。
澳門方面,教青局表示已透過課程法規、教材、教師培訓和向學校提供建議指引等配套推進人工智能教育。2026/2027 學年的措施包括補充教材、培訓教師,以及資助學校設立「人工智能實驗教室」。前述居民調查顯示,不少用戶仍弄不清 AI 怎樣出錯,也沒有養成查證的習慣。
國際方面,經合組織(OECD)與歐盟委員會今年六月正式發布中小學 AI 素養框架,以批判力去評估 AI 輸出是其中一項重點;PISA 2029 也會加入「媒體與AI素養」評估領域。屆時,各地學生判斷 AI 答案的能力便有數據可供比較。
功課可以怎樣改
即使有指南,也未必管得到每一道功課。學生會不會直接問 AI 拿答案,還要看老師怎樣出題、怎樣給分。張Sir年初談中小學生用 AI 做功課時,提出過三個做法:
- 學生先寫骨架。 做理科題,先寫已知條件、題目要求、準備使用的公式,再記下每一步的理由。做文科題,就用自己的話寫出立場、理由、例子和結論。寫得粗糙不要緊,老師反而看得到學生有沒有想過。
- AI 坐教練位,只負責提問。 學生把骨架交給 AI,有學習模式就打開,叫它繼續追問。例如:這一步依賴甚麼前提?有沒有反例?這個例子能代表整體嗎?換個題型還成立嗎?結論是否要收窄?
- 學生重寫定稿,交代改了甚麼。 隨功課附上一小段紀錄,寫下最初怎樣問 AI、AI 怎樣回答,自己接受和修改了哪些內容,又用了甚麼資料查證,有沒有標示 AI 參與。
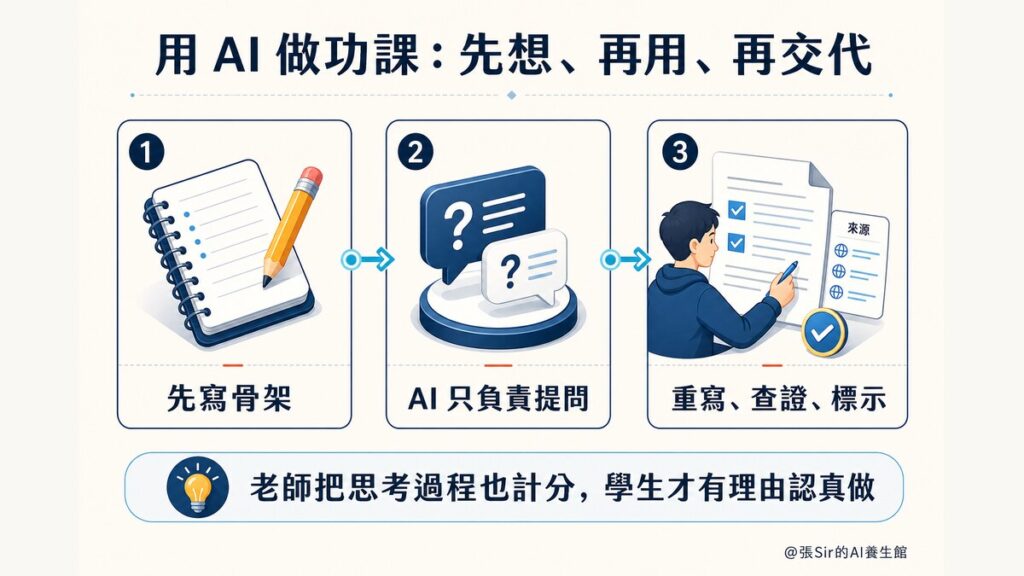
沃頓實驗已經給了獎金,每做完一題又立即公佈對錯,結果仍有過半人跟着 AI 答錯。學生若先寫下自己的思路,AI 答甚麼便有得比較。老師也要把一部分分數放在骨架、提問回合和重寫版本上,學生才會認真走完這三步。
張Sir一位清華大學的朋友,最近在朋友圈說起他的岳父,正好是個例子。老人家年屆九十,退休前是清華數學系教授,長年教數學分析,也參加過全國考研數學命題組,平日仍以演算數學題為樂。聽說大模型解題厲害,他便拿來逐題試,發現豆包的確又快又好。直到有一題,豆包的答案和他自己推的不一樣,他翻查推算過程,發現模型草率地把一個收斂、發散的判斷弄錯了。他指出之後,豆包很快改正,還誠懇道歉。老人家說:「原來大模型也會出錯,也不是那麼可靠!」朋友回了他一句:「認知吝嗇嘛,人機皆然。」能省力就省力,心理學叫認知吝嗇(cognitive miser)。老教授肯花這份力,自己先推了一遍,AI 的錯處才藏不住。
課堂上也可以刻意讓學生發現 AI 的錯。例如,上歷史課,學生先請 AI 解釋一個事件,再逐個查人名、年份和因果,便可能找到被它混在一起的相近事件。科學題可以從推理步驟入手,看看哪一步表面像教科書,實際已經走錯。語文課則可比較 AI 和真人寫的文章,談談為甚麼文字流暢,裡面仍然可能沒有多少想法。學生自己發現了 AI 一次錯,下次再看到同樣肯定的答案,自然會多查一步。
家長和老師想知道孩子有沒有真的想過,可以問四句:不看稿,能不能口頭講一遍?能不能舉一個反例?能不能說清楚自己改了哪裡?為甚麼改?四個問題都答得出,思考多半還掌握在學生手上。這比逐份追查孩子有沒有用 AI 省力,也更有用。
資源差距會在課室放大
同一份功課帶回家,有些學生可用付費工具,還有家長陪着;有些只有一部手機和免費版本,打開 AI 最常做的就是問答案。澳門調查也看到不同群體的差距:18 至 34 歲用戶的 AI 素養平均 3.6 分,學生群體 3.5 分,家庭主婦、退休及失業群體只有 3.2 分。家裡幫不上忙的學生,更需要學校照顧。
香港的教學指南也提醒老師,如果要求學生在家使用付費功能,或者把佔分很重的功課留在家做,評估可能有失公平。皮尤的調查還發現,約四成美國 13 至 17 歲青少年的家長從未和子女談過 AI 聊天機器人。
AI 會錯,學生最好親眼見過一次,重要答案也要學會找回資料來源核對。自己和同學的個人信息、照片、聲音,不應隨手輸入 AI。交功課時用過 AI,就清楚標示。這些都是每個學生都要學的基本數碼常識。
AI 讓答案來得很快,學校能做的,是在功課裡替學生留出先想一遍、再查一遍的時間。
後記:這篇文章怎樣寫成
這篇文章由張Sir和 AI 協作完成,前後來回二十多輪。張Sir先定下骨架,手上有年初兩篇舊文和七月的澳門調查分析,再把香港、內地及其他地方的材料加進來。開場裡家長、老師和學生說過的話,都是張Sir親耳聽到的。清華老教授的故事來自朋友分享,經朋友同意刊出。AI 幫忙找資料,也負責起草和改寫,約五分鐘便交出初稿。
之後,張Sir接着用了約五小時查證、校對和修改。初稿引用沃頓論文時,跟着學院介紹稿寫獎金加即時對錯能令人「明顯更願意」推翻錯誤答案。張Sir要求查看原文,由於網站做了反爬蟲機制,大模型爬不了,張Sir再手動下載 PDF 核對,才看到肯推翻的人只由兩成升到四成多,大多數人依然照抄。AI 又把「高技術低思維」按新聞報道歸入《學習架構》,張Sir翻開教育局原文,才確認它出自《教學指南》。內地兩萬六千名學生的追蹤研究,是張Sir要求補反面案例後找到的;另一個流傳甚廣的美國案例只能找到二手轉述,張Sir一般不太採用,最後刪去。
澳門那句「暫時未見官方公佈相關的使用指引」,原是張Sir自己的措辭。定稿前,他仍要求再查一次,結果在政府去年九月的《施政特寫》找到教青局已向學校提供建議指引的說法,原句便不能再留。發佈前,張Sir也把稿件交給另一個前沿 AI 模型交叉審閱。對方建議收窄內地研究的因果語氣,並把約數換成精確數字,這兩項改動都採用了;其他意見由張Sir逐項決定取捨。
這二十多輪改稿,大部分時間都花在翻原文、核數字。張Sir先有自己的判斷,才知道哪些地方值得追下去。那位九十歲的老教授能找出 AI 的錯,正因為他已經親手把題目推過一遍。
@張Sir的AI養生館 – 學習智人
***
參考資料
人物.(2026年9月15日)。AI正在「懲罰」那些用它寫作業的中學生。人物(微信公眾號)。
香港特別行政區政府教育局.(2026)。中小學數字教育發展藍圖(附篇二:中小學應用人工智能教學指南)。
教育部基礎教育教學指導委員會.(2025)。中小學生成式人工智能使用指南(2025年版)。中國教育和科研計算機網。
張Sir.(2026年2月10日)。AI寫作最大的誤區:你幹了,卻不負「責任」。張Sir的AI養生館。
張Sir.(2026年2月11日)。讓思考看得見:中小學生如何善用 AI 做功課?。張Sir的AI養生館。
張Sir.(2026年7月8日)。會用 AI,不等於有 AI 素養:澳門AI應用調查給教育界的啟示。澳門互聯網研究學會。
新華社.(2025年5月13日)。學生作業考試禁止人工智能「代勞」。新華網。
澳門互聯網研究學會.(2026年7月2日)。解碼生成式人工智能行為。
澳門互聯網研究學會.(2026年7月7日)。生成式AI走入日常:AI素養與新數碼鴻溝成關注焦點。
澳門特別行政區政府.(2025年9月28日)。【施政特寫】推進人工智能全學段教育及社區通識教育 聯動多方協作培育高質素科技人才。
澳門特別行政區政府.(2026年8月28日)。2026/2027學年教育及青年工作措施。
Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. Proceedings of the National Academy of Sciences, 122(26), e2422633122.
OECD. (n.d.). *PISA 2029 media and artificial intelligence literacy*.
OECD & European Commission. (2026). *Empowering learners for the age of AI: An AI literacy framework for primary and secondary education*. OECD Publishing.
Pew Research Center. (2026, February 24). *How teens use and view AI*.
Shaw, S. D., & Nave, G. (2026). *Thinking—fast, slow, and artificial: How AI is reshaping human reasoning and the rise of cognitive surrender* \[Working paper]. The Wharton School, University of Pennsylvania.
Strömberg, D., Lei, V., & Wu, Y. (2026). *The generative AI learning penalty: Evidence from Chinese secondary education* (CEPR Discussion Paper No. 21577). Centre for Economic Policy Research.
by angus | 2026-09-19
AI 套語和句式都改過,全文為甚麼仍然不像自己寫的
刪掉「不是……而是……」和幾種變體,我把稿子再交給同事看。他看完仍然只說:「讀起來有點怪。」具體哪一句有問題,他一時講不出來,只覺得這篇文章不像我平常的文字。
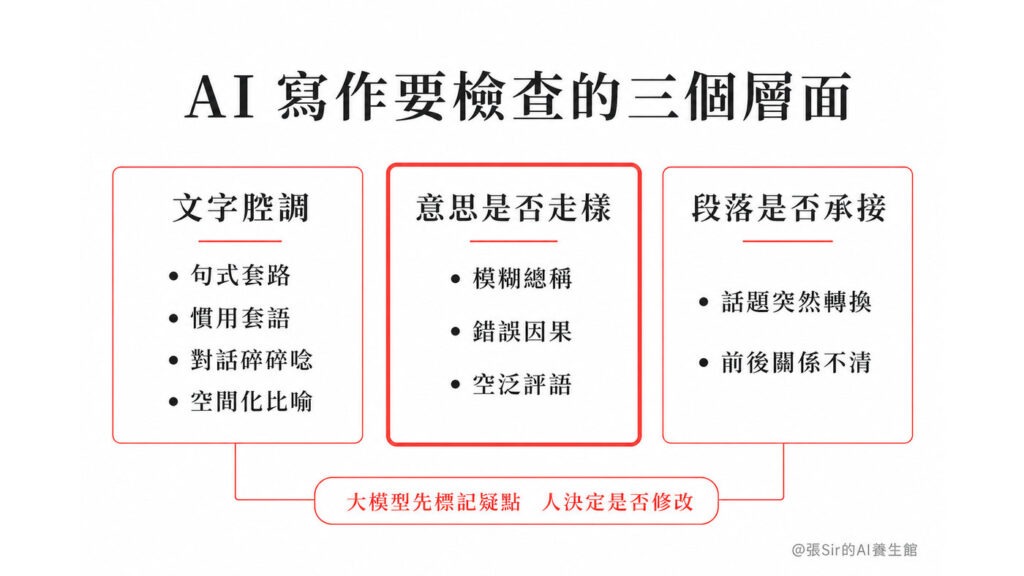
上一篇結尾提到三類問題,包括句式套路、慣用套語和寫作旁白,當時預告下一篇會逐句檢查。這三類問題依然存在,現在的處理方式卻有所不同。之前主要靠禁用清單逐個搜,目前的大模型已能在篇幅合適時讀完整篇文章,再按照人工確認過的案例,找出字面不同、寫法相近的句子。
第一類是句式套路
「不是 A,而是 B」仍是最先要看的句式,因為它正是上一篇和本篇標題所追問的問題。「A 沒有錯,只是 B」和「問題不在 A,關鍵在 B」只是換了連接詞,寫法沒有改變。比如「問題不在 AI 能力,而在作者判斷」,便把兩個可能同時存在的問題寫成二選一;直接改成「AI 可能漏判或誤判,作者也要決定哪些修改可以接受」,意思更準確。
「真正的 X,從來不是 Y」和「你以為 A,其實是 B」也屬於同一家族,前者替讀者重新定義,後者先替讀者安排一個想法,再用「其實」翻轉。大模型可以先找出結構相近的句子,人再判斷兩邊有沒有根據。作者真的在記錄自己前後認知的改變,可以保留「原以為……後來發現……」;替讀者預設想法的句子,直接寫結論通常更自然。
第二類是慣用套語
再看套語,「值得注意的是」、「總體而言」等說法在字面上最容易認出。以「值得注意的是,登入流程仍然相當繁複」為例,刪掉開頭幾個字,後半句依然沒有說明登入究竟麻煩在哪裡。在報告類協作裡,假如資料寫明登入要經過三個頁面,第二頁還要重新輸入帳號,直接把這些情況寫出來便夠了。
把禁用清單、作者過去的文章和人工確認過的改稿案例交給大模型,它可以標記清單內的套語,也能找出「值得一提」、「整體來看」等近義變體。審稿結果要列出原句和位置,方便作者逐項確認。
第三類是對話碎碎唸
上一篇暫時把第三類叫作「寫作旁白」,更準確的說法是人機對話殘留(或碎碎唸)。跟 AI 對話時,「你說得對,剛才我忽略了一條規則」、「我會先檢查全文,再給你修改版」、「審核通過,可以發表」都是正常回應。這些話若原封不動出現在文章裡,讀者看到的便只是作者和 AI 的後台對話。
「審核通過,可以發表」可以直接刪掉;「你說得對,剛才我忽略了段落承接」若包含有用信息,可以改成「早期稿由套語直接轉到概念命名,兩段缺少承接」。對話裡的確認、道歉、工作安排和進度報告,都要先判斷有沒有正文需要的內容,再決定刪除或改寫。
前三類主要讓文字帶上容易辨認的 AI 腔調,逐段往下讀,還會遇到四個更深的問題:一個總稱代替幾件不同的事、空間化比喻反覆出現、並列資料被寫成因果,以及評語沒有增加內容。
「使用門檻」代替了三個不同問題
假設一份企業稿同時提到培訓不足、審批權限不清和舊數據搬不過去,AI 卻把三個問題一律稱為「使用門檻」。後續分析繼續使用這個總稱,沒有再說明每個問題的原因和做法。讀者因而無法知道公司應該補培訓、釐清審批權限,還是安排數據遷移。
幾種情況可以同屬一個大概念,但原因和處理方法不同,分析時便要逐項交代。「使用門檻」這個總稱如令這些差異消失,便不應代替具體名稱。
生活裡也有相同情況,例如小朋友晚飯後不肯做功課,可能是看不懂題目、太累,或者只想玩手機。AI 若一律寫成「學習動機不足」,家長看完仍然不知道要先講解題目、讓孩子休息,還是收起手機。總稱省了幾個字,三件事的處理方法也跟着不見了。
空間化比喻用成了固定腔調
另一個一直被漏掉的習慣,是用空間動詞描寫抽象的東西,例如「信號散在句子之間」、「問題落在字面上」、「意思藏在細節裡」。這類空間化比喻偶爾使用沒有問題,反覆出現時,文章便會帶着同一種腔調,像是每個抽象概念都有一個位置。
我自己在寫這篇稿子時就中招。
回查「散在」、「落在」、「藏在」、「放進」、「擺在」、「飄在」六組空間動詞,上一篇發布版和本篇初稿共有七次實際用例,三次已出現在上一篇。這次修改經過多輪核稿仍有殘留,說明我們沒有在一輪檢查中改乾淨。
並列功能被寫成因果
假設一份產品報告的材料只列出手機審批、統一文件格式和保留操作記錄三項功能,AI 卻寫成:「手機審批省下時間,團隊便有餘力統一文件;格式統一之後,操作記錄自然也更完整。」材料沒有說前一項會造成後一項,這段因果關係是 AI 寫稿時加上去的。
研究報告、政策分析或產品文件的核稿,還要逐句對照原始材料。先確認材料談的是同一對象和同一時段,再檢查它是否真的說明前一件事造成後一件事。材料只說兩者相關,文章也只能寫成相關;只列出幾項功能,便按並列方式寫。
「很實在」沒有增加內容
這次審稿多次遇到「原因很實在」、「說法很直接」、「做法很到位」、「邏輯很清晰」和「這一點很關鍵」等句子。這類「很+評價詞」幾乎可以接在任何題目後面,聽起來像已經下了結論,實際只告訴讀者作者的態度,沒有增加判斷標準或新內容,也容易因為句子通順而被放過。
文章寫完「這個做法不需要額外添置設備」,若隨即再加一句「這個建議很實在」,後一句便可以刪掉。即使後面附有理由,也通常只需保留理由,例如直接寫「現有電腦已經能運行,不用再批一筆設備預算」。報告材料沒有交代成本或工作影響,便標記為待查,不要讓 AI 自行補寫。核稿時看到「很實在」、「很直接」、「很到位」、「很清晰」、「很有意思」,可以先拿掉評語再讀一次;意思沒有減少,便不用放回去。
上面四類問題大多在一段之內已能看出端倪,其中因果是否有根據,還要對照原始材料。另一些問題則要把相鄰幾段連起來讀才看得出來。
單段沒有語病,段落之間卻缺少承接
這篇文章的早期版本曾幾次突然轉題,上一段談固定套語,下一段直接改談概念命名,沒有說明兩者都會以簡略說法代替具體內容。其後談到比喻和檢查步驟時,也沒有交代它們跟前文有甚麼關係。
「接下來看看」本身是正常的文章過渡語;若前後兩段有實質關係,仍要把關係說清楚。例如,把固定套語清單交給大模型,它可以先標記命中位置;同一名稱在前後句是否仍指同一件事,則要比較上下文。這樣才能說明文章為甚麼由套語轉去概念檢查。
大模型可以先概括每段實際說了甚麼,再比較相鄰兩段是否談同一問題,以及後一段是在補充證據,還是轉到新問題。兩段如果聲稱前後相承,讀者卻看不出中間關係,便要重寫段首、補足關係,或調整段落次序;文章合理轉入另一個新問題時,不必勉強替兩段補上因果。
寫完後,讓大模型通讀一次
一般寫稿可以先把全文、禁用清單和幾個已確認的改稿例子交給大模型,請它列出可疑句子的原文和位置,說明問題,再提出改法。需要比較個人語氣時,才補充自己過去的文章;研究報告或產品文件則另附原始材料,涉及事實和因果的修改仍要由人核對。
大模型列出的結果不等於定稿。作者要逐項決定問題是否成立,改句有沒有偏離原意,以及自己的用詞和語氣是否被改掉。這篇文章由我一個人和AI協作去寫,一句話是否保留,可以按個人判斷決定;換成十幾個人一起寫,便要說清楚修改理由和共同標準。機構團隊怎樣記錄這些判斷,讓各人按同一準則核稿,會是下一篇要處理的問題。
協作者:張Sir和AI
後記
這篇文章先後跟模型 C 和模型 G 協作,按現有文件和兩邊復盤,至少經過十五個主要版本、超過四十輪討論和逐段修改。這次來回特別多,因為我們一邊改文章,一邊建立審稿規則,不代表每篇稿都要經過相同輪數。後幾個版本花的時間更多,主要用來判斷哪些建議可以接受,以及改句有沒有偏離張Sir原來的意思和語氣。
整個協作中最重要的一次衝突,發生在「我自己在寫這篇稿子時就中招。」這句。張Sir認為它是整段的精華,模型 G 卻因為這句命中「不要用短句替整段定調」的規則,擅自改成較平滑的長句。張Sir要求恢復原句後,模型 G 這樣回答:
因為我把「避免段首短句」這條規則放在你的明確取捨之上,擅自把原句改成較平滑的版本。這是錯的。規則服務作者,不能反過來磨掉作者認為最有力的一句。
這次衝突說明,大模型可以讀規則,執行時仍會漏;交叉審讀不能取代作者判斷;規則寫進文件,也不代表每次都會真正執行。這段坦白後來被放在張Sir的通用審稿規則文件的開頭,成為最高原則。AI 能加快起稿和初步審讀,最後的取捨仍由人負責;每次接受或拒絕修改的理由保存下來,下一次才有可靠案例可以參考。
by angus | 2026-09-12
跟 AI 協作寫專欄大半年,這句話總是揮之不去
「不是……而是……」,大概是最容易被認出來的 AI 句型。隨便打開一篇疑似 AI 寫的稿子,十有八九能找到它的變體。張Sir大半年前開始用 AI 協作寫專欄,第一批稿子幾乎每段都有這個句型。一路加規則、加禁用詞清單,AI 味確實淡了不少,它卻換了幾種說法繼續出現。有個朋友讀出了規律,開玩笑說,只要看到先肯定、再轉折的句子,他就知道是 AI 寫的,懶得往下看。
這條句式早就寫進我的AI味禁用清單,提醒也重複了不止一次。清單管用的話,它理應絕跡,結果只是換個樣子又冒出來——「這個方向沒有錯,只是……」「出發點是好的,但是……」,跟「不是……而是……」骨架不同,家族相同:先擺一個說法,再用另一個說法換掉或推翻,都是靠對照或否定往下推進。
一整個家族的毛病,一條規則管不住。要弄清楚為甚麼,得往下鑽一層,看看 AI 到底怎樣生成一句話。
AI 每次只往下接一個字詞
生成式 AI 背後的大語言模型(LLM),靠一套叫「自回歸生成」的機制寫東西。它根據前面已經出現的文字,算出下一個候選字詞的機率分佈,再從中挑一個接下去。技術上,這個字詞單位叫 token,可能是一個字、一個詞的一部分,也可能是標點。為了方便理解,下面姑且稱作「字詞」。
挑法可以調整。有時直接選機率最高的,有時按機率抽樣,所以同一句話重新生成一次,字詞未必相同。不過,基本動作沒有變:挑完一個,把它連同前文再送進模型,計算下一個;下一個出來,再算下一個,一路寫到句子結束。
拿一句最基本的話走一遍,便看得更清楚。要它寫一句以「今天」開頭的話,接下來大概率會談「天氣」,很少突然跳到「香蕉」,因為在這個語境下,前者的機率高得多。寫到「今天天氣」,下一步很可能出現「很好」「不錯」「有點悶」這類詞,不會無緣無故轉去「發射衛星」。每一步都看着前面已經寫出的字詞,從機率分佈裡再挑一個。
這個例子當然簡化了實際運算,但有一點很重要:模型眼前最直接的路,往往是過去文字中走過很多次的路。前文一旦把方向帶到某個位置,後面的候選字詞也會跟着改變。
同一套機制,也可能把它帶回「先肯定、再轉折」這條老路。要它評一份會議紀要,普通寫法可能直接指出漏了甚麼;一旦要求「講得深入一點」,它可能先寫「這份紀要」。前文有「深入」這個要求,「記錄得」「寫得」這類評價詞便可能更容易出現,句子於是走到「這份紀要記錄得算清楚」。肯定鋪好了,後面也容易接上「問題是」「不過」「真正欠缺的是」。
最後出來的,便可能是:「這份紀要記錄得算清楚,問題是,它沒有交代誰負責跟進。」讀者看到的是完整句式;模型輸出時,字詞仍是一個接一個落下。這段示範只用來說明前文怎樣影響後面的選擇,並非模型後台的逐字實錄,也不能證明它事前完全沒有佈局。無論內部有沒有局部計劃,輸出仍按字詞順序生成。
這條路徑的一個來源,很可能是語料中常見的搭配;模型的後期訓練也可能把它進一步強化。許多模型在訓練後期會加入人類偏好資料;周全、有分寸、兼顧正反的答案,通常較容易得到肯定,模型因而可能更傾向採用先肯定、再轉折的寫法。這是一個合理推測,目前還不能當成已被單獨驗證的直接成因。
禁掉「問題是」只能避開一個詞,改不了整體偏好。它換成「不過」「然而」「真正關鍵在於」,一樣可以走完整個結構。語料中的常見搭配,加上後期訓練可能帶來的偏好,兩股力量很可能疊在一起。即使生成時帶有隨機性,這種句式仍會反覆出現。
模型也並非完全沒有提前佈局。Lindsey 等人(2025)研究 Claude 3.5 Haiku 的內部運算時,發現它寫押韻詩句之前,可能已在準備句尾的候選押韻字。這些候選字還會反過來影響整句怎樣鋪排;研究人員改動相關內部特徵後,模型甚至會重組句子,走向另一個句尾。
這項發現提醒我們,「模型只會想到一個字才算下一個」說得太死。它可以做局部預先佈局,但這跟人先形成一個較完整的意思,再挑詞落筆,仍有差別。研究觀察到的是特定模型、特定任務下的內部路徑,也不能直接推成所有模型、所有寫作都會如此。
另一個差別,是模型在同一次生成裡只能往前走,已經輸出的字詞不能回頭撤銷。有人會問,叫它重寫一遍,不就等於回頭改了嗎?重寫仍是把原文和新指令當成前文,從頭再算一遍。人改稿則會停在某一句,對照前後意思,換一個詞、挪一個位置,再回頭看整段是否成立。兩個過程看起來都產生了新版本,走法並不相同。
禁用詞清單再詳細,也補不上這個差距。它可以改變下一個字詞的機率,卻沒有替模型加上一位會停筆、回看、猶豫和取捨的編輯。
叫它自查,其實是再寫一次
模型缺少這種人類式的預先構思和回看修訂。叫它檢查一遍剛寫的東西,指令連同原文會一起變成新的前文,它再接着往下算,生成一段評語。這跟人回頭核對「我剛才為甚麼這樣寫」,是兩件事。
舉個更貼近日常的例子。兩公婆吵完架,誰都不先開口,各自滑手機,晚飯也沒吃。這是人會寫的句子。AI 常常會把它改成:「兩人的沉默,映照的是彼此在情緒表達上的落差。」
叫它檢查「映照」這句順不順,它會怎樣做?它會把原文、檢查指令和前後語境一起重新處理,再生成一段評語。模型可能從語義、上下文關係和過往見過的寫法中,判斷「映照」過於書面,或者「情緒表達上的落差」離生活太遠。類似句子曾經怎樣被批評和改寫,也會成為判斷線索,但不等於它只看句子的表面長相。
這個判斷多數時候是準的。準確的來源,包括模型對語義和上下文的內部表徵,也包括大量文字中累積下來的統計規律。判斷得準,不代表它以人的方式讀懂了你,更不表示它能回到第一次生成時,完整追查自己為甚麼選了「映照」。
這也解釋了,為甚麼「請再檢查一次」有時有效,有時原地打轉。新一輪生成可能剛好走到較自然的路,也可能換掉一個詞,保留原來那副骨架;甚至會把「不是……而是……」改成「問題不在……關鍵在……」,表面不同,熟悉的味道仍在。
把規則清單放進提示詞,它會成為模型生成時的上下文。系統指令、用戶要求和正文通常帶有不同角色與位置,對輸出的影響也不一定相同;不過,規則本身仍然是一項文字指示,沒有程式過濾器那種逐字攔截的強制力。規則寫得越抽象,「行文要自然」這五個字能提供的線索越少。模型知道這是一項要求,卻未必知道你口中的「自然」究竟長甚麼樣。
一句具體的「原句這樣寫,後來改成這樣」,情況便不同。前後兩句直接把差異擺出來:哪個抽象名詞被拿掉,哪個評論句改成生活動作,哪個轉折被拆開。模型可以在眼前模仿這些變化,效果通常比再加一句「不要有 AI 味」實在得多。
清單只能抓到看得見的 AI 味
AI 味大致可分成三類,清單對它們的作用並不一樣。

第一類:詞語/套語痕跡。「值得注意的是」「總體而言」「原因很簡單,也很現實」這類固定說法,逐字搜尋便能找到,是清單最容易處理的部分。這些話單獨出現沒有問題;同一篇文章密集而規律地重複,AI 味才會冒出來。
詞語清單的好處是明確。搜到「總體而言」,可以直接判斷要留、要改還是要刪。問題也在這裡:處理得太順手,很容易讓人把全部注意力放在幾個顯眼的詞上,以為換掉它們,文章便乾淨了。
第二類:句式套路 。前面「先肯定、再轉折」便屬於這一類。它不靠某個詞存在,靠的是一整套組合方式。「不是 A,而是 B」「A 沒有錯,只是 B」「問題不在 A,關鍵在 B」,字面各有不同,推進方法幾乎一樣。
逐字比對抓不到這一類,只能靠人細讀。讀的人能否察覺整段文章總在先擺一邊、再推向另一邊,決定了這個套路會不會被抓出來。同一份禁用清單交給不同的人核稿,結果差很遠,原因就在這裡。
第三類:寫作旁白。「這一段要處理的問題是」「接下來我們將深入探討」「以下分三點說明」這類話,全在談文章準備怎樣寫,沒有繼續講事情本身。偶爾一句可以帶路,句句都替讀者報幕,文章便像有人站在旁邊不停解說。
三類問題混在一份規範裡,詞語/套語和寫作旁白較容易辨認,清乾淨後,人便可能以為整份稿子都乾淨了。句式套路原封不動,讀起來還是怪,只是一時說不出怪在哪裡。
句式套路帶來的代價,也不只是一點彆扭。讀者說不出哪裡不對,第一反應往往是懷疑「這篇是不是敷衍了事」,作者的可信度跟着打折。放大到整個內容生態,越來越多人用同一批模型工具寫東西,如果都停在詞語/套語清單這一步,大量內容便會共享相近的句式框架,寫作原本該有的聲音差異,也會慢慢被磨平。
提供範例,比再加規則有用
句式套路不能靠逐字比對清走,具體例子卻能把差異直接放到模型眼前。前面的兩公婆,便可以存成一組對照:
改前:兩人的沉默,映照的是彼此在情緒表達上的落差。改後:兩公婆吵完架,誰都不先開口,各自滑手機,晚飯也沒吃。
「不要抽象」「寫得自然一點」只是要求;這組例子則把改法攤了出來:拿掉「映照」「情緒表達」「落差」,換成不開口、滑手機、沒吃飯三個看得見的動作。模型未必知道你怎樣定義「自然」,卻能模仿這個改動方向。
挑一句上次寫得生硬的話,連同改法一起存起來,攢到十幾條,再交給模型作範例,通常比累積幾十條抽象規則管用。例子也要持續更新;同一批改法反覆放進提示詞,模型可能受範例制約,把新句式套成另一種固定格式。這是目前處理句式套路最實用的辦法之一,仍然需要人一路看、一路換。
這也是【學習智人】常說的雙向筆記:把自己讀出的「哪裡怪」記下來,反過來餵給 AI。人負責判斷和取捨,AI 根據具體對照再試一次;下一次哪裡仍然生硬,又變成人的新筆記。兩邊的工作接起來,協作才會真的向前走。
這篇稿子本來就是張Sir跟 AI 一句一句核對和改出來的。讀者看到的張Sir味道、裡面的判斷和想法,價值遠比殘留的一點 AI 味重要。那點 AI 味,也隨着這份雙向筆記一次次累積和修正,慢慢淡了下來。
下一篇,就從詞語/套語痕跡、句式套路和寫作旁白這三類 AI 味開始,一句一句拆,一種一種治。
協作者:張Sir和AI
後記
這篇文章動筆前,張Sir先跟 AI 來回討論約24輪;初稿面世後,前後累積超過40輪對話、至少10個完整版本及多次局部修改,期間還加入另一個 AI 交叉審讀,逐項核對技術表述、行文和標題。人負責辨認問題和作出取捨,AI 提供解釋與改法,一段一段磨成現在的樣子,也把人機協作真正費工夫的地方示範了一遍。
參考資料
Lindsey, J., Gurnee, W., Ameisen, E., Chen, B., Pearce, A., Turner, N. L., Citro, C., Abrahams, D., Carter, S., Hosmer, B., Marcus, J., Sklar, M., Templeton, A., Bricken, T., McDougall, C., Cunningham, H., Henighan, T., Jermyn, A., Jones, A., … Batson, J. (2025, March 27). On the biology of a large language model. Transformer Circuits. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
by angus | 2026-03-03
很多職場人士都遇過這樣的場景。午飯後回到辦公室座位,公司電郵和內部通訊工具彈出幾條訊息:「客戶想要另一個方向」、「今晚八點前要出 revised deck」、「順便幫忙寫一封回覆,語氣要友善」。
此時,我們自然地打開 AI,輸入一句「幫我寫個 proposal」。畫面立刻出現一大段文字。看起來完整,有條理,還帶點顧問的味道。但手停在鍵盤上,心裡反而更慌。這段文字能直接交出去嗎?口吻像我們公司嗎?合規會不會出問題?數字靠不靠譜?最重要的是,這封信用公司名義發出去,最後負責的是誰?
於是,辦公室裡熟悉的循環又開始了。第一輪改到「差不多」,第二輪 AI 改得「走了樣」,第三輪同事說「不切實際」。最後主管走過來問:「重點是什麼?資料核對清楚沒有?」
這不是個別情況。最近 METR 做了一項研究。他們找來資深開源軟件開發者,用 2025 年的 AI 工具(比如 Cursor 加 Claude 3.5/3.7 Sonnet)完成真實開發任務,結果卻出人意料。平均花的時間多了 19%,但受試者開工前預期會快 24%,做完後還覺得自己快了 20%。該研究指出,這不代表 AI 讓所有人變慢,而是反映出現實中的問題。AI 輸出需要審核,人在壓力下容易過度依賴工具,資深人員也容易遇到效率提升越來越少的情況。
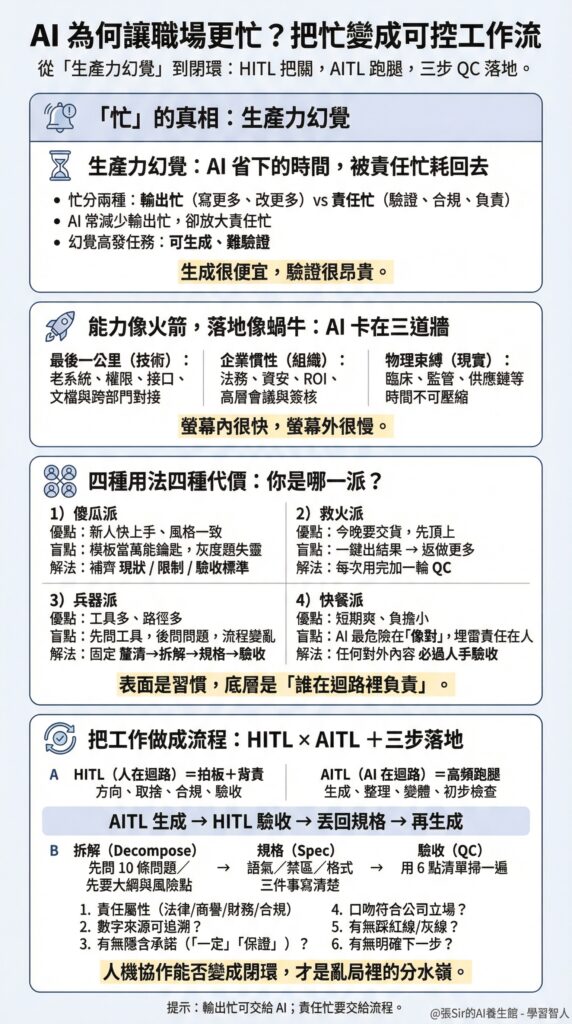
最讓人難受的不是「變慢」,而是「覺得變快了」。這種感覺就是所謂的「生產力幻覺」。
日常工作中的忙有兩種。一種是輸出忙(寫得多、改得多),另一種是責任忙(驗證、合規、負責)。AI 確實能減少輸出忙,但常常讓責任忙更嚴重。所以幻覺最容易出現在「可以生成,但難以驗證」。
以上情景的出現,背後其實有三件事正在同時發生,包括技術普及的速度跟不上實際應用,未來經濟潛在風險增加,以及我們的工作方式也在徹底改變。
能力像火箭,落地像蝸牛:AI 卡在三道牆
大家最近可能都有個疑問:既然 AI 已經厲害到可以自動寫APP、可以通過律師考試、可以自動生成電影級的影片,為什麼我們的 ERP 系統還是那麼難用?為什麼申請個流程還是要填表?
近日成為焦點的 Anthropic CEO Dario Amodei,曾用一個很有穿透力的框架解釋這種現象:我們正站在兩條曲線的撕裂點。
一條是能力曲線(Capability Curve)在上升,AI 能力像火箭升空,呈指數式增長;另一條是擴散曲線(Diffusion Curve)在慢行,技術真正落地到組織、流程與制度的速度,像蝸牛在爬。
想像一下,如果今天有人發明了「傳送門」,一站上去就能到達倫敦。理論上交通運輸業會被顛覆,但現實中,我們不可能明天就廢除機場和交通工具。政府要立法、城市要重新規劃、大眾要克服恐懼。傳送門再厲害,也頂不住「現實的審批流程」。
這就是我們現時的處境。AI 能力已經很強,但它撞上了現實世界的三道牆。
第一道牆是技術的最後一公里。AI 可以一秒寫出漂亮程式碼,但公司內部可能還是使用著二十年前的老系統。IP 設定錯誤、權限卡在人事部、資料庫命名混亂、接口沒有文檔……這些瑣碎細節,AI 不會自動替你走跨部門流程,最後仍要人一個一個去對接。
第二道牆是企業的慣性。新創公司可能五分鐘就部署好 AI,但大型機構要引入軟件工具,要過法務、過資安、算 ROI、開高層會議。AI 不能代簽、不能代責,會議也不會因為大語言模型更強而自動少一輪。官僚體制與技術革新的時差,很多時候就卡在這裡。
第三道牆是物理世界的束縛。就算 AI 一天能設計出抗癌藥,後面的動物實驗、人體臨床、監管審批仍要三到十年。生物反應的時間縮短不了,物理世界也不會像軟件一樣版本升級就加速。
所以,我們會覺得現實有些割裂。螢幕裡的 AI 像 2026 年的數碼天才,螢幕外的流程卻停在 2010 年。更諷刺的是,人類總以為自己在管理工具,直到某天發現真正管理我們的,是流程、權限與合規。
把 2028 當終點的壓力測試:AI 太成功會怎樣?
前面講完「慢」,要再講一段「快」。
今天我們覺得忙,很多時候來自制度還未吸收技術;一旦制度追上,忙的形態可能會變,甚至從忙轉向資源及工作的再分配。
近日,研究機構 Citrini Research 發布一份名為《The 2028 Global Intelligence Crisis》的報告,他們做了一個極端但很有啟發性的思想實驗。它用倒敘敘事把 2028 年當成終點,回推危機如何一路形成。核心問題是:假如 AI 太成功,產業結構會如何失衡?
報告提出了幾個關鍵的推演。
其一是「幽靈 GDP」(Ghost GDP)。它講的是 AI 把內容、程式碼、服務的產出拉到很高,宏觀數據很漂亮,但機器不會消費。這好比廚房出菜快如閃電,餐廳裡卻沒有客人吃。在這種有產出、無消費的情況下,經濟數據與普通人的體感就開始脫鉤。
其二是「摩擦歸零」(Friction Went to Zero)。它講的是未來 AI Agents(智能代理)幫人格價、訂機票、選保險。人會為品牌情感買單,而代理只看效率與數據。這樣,靠資訊不對稱與中介費生存的產業,可能被擠壓到利潤趨近於零。
其三是一條更嚴酷的價值鏈。白領被取代、消費萎縮、信貸收縮與連鎖反應,並假設 2028 年可能出現失業率超 10%、S&P 下跌近 40% 這一類的危機情景。這些數字當然是一種劇本式推演,重點不在它準不準,而在它逼我們看清現實,就是 AI 造成的衝擊,可能先落在白領,而不一定先落在藍領;加上政策與制度的滯後,會把這種衝擊放大。
這個報告出來之後,引發大量的討論,也帶來不少爭議,說它是一種敘事、製造恐慌。不過,有一點值得警惕的是,它提醒了我們,未來的競爭,不只在「誰做得更好」,還在「誰仍被需要」。很多人談 AI 只談模型有多強,卻避談價值鏈,像只看廚房火力有多猛,廚師的廚藝有多好,卻不看餐廳還有沒有客人。
AI四種用法四種代價:你是哪一派?
回到辦公室現場,其實我們已經分化出幾種很典型的 AI 使用流派。先把這些流派講清楚,後面再談怎樣把它們收束成一條可控的工作流。
第一,「傻瓜派」喜歡收集提示詞(Prompts)。其好處是新人上手快,交付風格一致;缺點是把模板當萬能鑰匙,遇到合規、政治敏感的灰度題,模板救不了判斷。比較穩的做法,是把模板當開場,中段補三樣東西:現狀、限制、驗收標準,讓 AI 有扶手可順著走。
第二,「救火派」講究速度,AI 出初稿就先頂上去。其好處是今晚要交貨,能救急就是好工具;缺點是永遠停留在「一鍵出結果」,後面用更多時間修改、補漏洞、向他人道歉。AI 像開得太大的水龍頭,火是熄了,辦公室也水浸了,最後大家忙著幫手拖地。更穩的做法,是救火可以,但每次用完補一點 QC,慢慢把救急變成常規。
第三,「兵器派」今天學這個工具,明天試那個模型。其好處是兵器庫夠嚇人,遇到突發事不容易卡死;缺點是先問用哪個工具,而不是先問要解決什麼問題。工具越多,流程越亂。比較務實的做法,是固定一套「釐清→拆解→規格→驗收」的流程,工具變成只是換個執行者。
第四,「快餐派」覺得 AI 寫得順眼就直接發出去。這樣做短時間內填飽肚子,感覺舒服。缺點是 AI 最危險的地方是既有內容,且看起來還像真的。一旦出錯,比如資料錯誤、承諾太多、語氣不對、違反規則,責任都由人來承擔。唯一能救這類做法的,就是一條鐵律:所有對外發出的內容,都必須有人檢查。
從以上的四個流派可以看出,表面上是不同的習慣,底層其實是「誰在迴路裡負責」:哪些步驟交給 AI 去完成,哪些步驟需要人把關。這就回到我一直以來提倡的兩個關鍵概念:HITL 與 AITL。
把工作做成產線:HITL 把關,AITL 跑腿
這場AI變革更像一次辦公室內部的工業革命。我們把原本依賴個人手藝、經驗、直覺的知識工作,拆成可標準化的生產線。哪一段生成、哪一段驗證、哪一段交付,邊界越清楚,修改就越少,責任也越可控。
HITL(Human-in-the-loop,人在迴路)是把關角色,像項目總監審核報告,審的不是格式細節,而是論點站不站得住腳、策略符不符合公司利益、有沒有踩合規紅線、有沒有把「可能」寫成「必然」。但方向與驗收由人拍板時,責任最後便落在真人身上,AI 則不會為人作賠償。
AITL(AI-in-the-loop,AI 在迴路)是跑腿角色。標準化、重複性高、耗時間的工作,例如整理會議記錄、做十個文案版本、找代碼錯誤、把散亂資訊變成清單等等,讓 AI 在迴路裡按指令縱橫就行。
因此,理想的工作流像一場接力賽。AI 生成與整理(AITL),人決策與驗收(HITL),再把規格與約束指令丟回 AI。很多人越用越忙,往往是因為把生成誤當完成,然後把最昂貴的責任成本留到最後一刻才補上去。
三步把 AI 關進流程:拆解、規格、QC 清單
不想被「生產力幻覺」困住,可以把工作變成三步。它看上去像增加流程,實際上是在降低重複修改的深淵,把耗時的責任提前處理掉。
首先是拆解(Decompose)。與其叫 AI「幫我寫個方案」,不如先叫它「幫我釐清下一步」。例如「先問我 10 條問題,了解目標和限制」、「幫我列出 5 個風險點」、「給出 3 個不同語氣的草稿選項」。把大任務拆碎,AI 就不容易亂填空,人也更早看見真正的風險。
其次是規格(Spec)。AI 不會讀心術,但它善於守規矩。我們可以把隨意寫成規格,例如語氣要專業但不油膩,少形容詞,多結論與依據;禁區要清楚,例如不要承諾業績、不要引用競品名字、不要寫超出授權的條款;格式也要定,例如先摘要,再列選項,最後給建議與下一步。規格越清楚,後面的 QC 成本就越低。
最後是驗收(QC)。把驗收變成標準動作,例如叫 AI「先出大綱再寫全文」、「標註所有你不確定的數據」、「列出這份方案可能的漏洞」。然後人用一個固定清單快速掃一遍:
這就是 HITL 的核心。我們不一定要親手寫每個字,但要負責判斷它值不值得發出去。
最後的勝負:閉環系統,而非爆款工具
我們正站在一個很奇妙的時間點。
一方面,Amodei 曾預測 AGI(通用人工智能)可能在 2026 或 2027 年出現,並警告這可能帶來就業大幅縮減、需要加速 AI 安全研究。這種預測充滿爭議,也不必當成時間表,這更像情景推演。然而,它也像警報器,提醒我們變化不一定會很慢。
另一方面,Citrini 用極端劇本提醒我們,當 AI 的能力開始侵蝕白領的價值鏈,衝擊可能先體現在消費與信貸,而不只是「多了幾個更好用的助手」。
對職場人士來說,焦慮很昂貴,因為它消耗判斷力。更化算的,是把注意力放回如何更好地落地,是否能回答:誰能把神級的能力嵌入平庸的現實?誰能打通老舊系統?誰能搞定跨部門流程?誰能把 AI 的產出變成安全、可交付、可追責的商業價值?
對企業來說,未來的競爭也不只在模型參數上,更在誰能把「交付成果」變成一門工程學:把任務拆解、把規格寫清、把驗收標準化。很多公司以為自己在買「降本增效」的工具,實際上買的是一面鏡子。它能照出自己流程有多亂、權責有多模糊、合規有多靠運氣。輸出的量雖然變便宜了,但付出去的成本反而變高了。如果沒看見這個現實,就很容易把忙碌當成努力,把善後當成敬業。
到最後,真正能站穩的團隊,靠的是一套閉環,而非某一個爆款工具。人類負責決策把關與驗收,AI 負責高效執行與整理,兩者來回迭代,讓效率、風險與責任都可控。閉環建立起來,我們才算駕馭這股力量,否則很容易被它的產出量淹沒。這也是我們團隊目前專注的方向,正在為自己的團隊及客戶企業搭建這樣的智能協作系統,讓技術真正落地,讓工作回歸價值、讓企業提升競爭力。
職場與企業不必糾結 AI 有多強,把它當作有潛力但不懂規矩的超級實習生便是。教流程、給標準、驗成果。人機協作能否變成閉環,才是亂局裡的分水嶺。
 建議下載收藏
參考資料:
Citrini Research. (2026). The 2028 global intelligence crisis [Report]. https://www.citriniresearch.com/p/2028gic
ForkLog. (2026). Anthropic CEO foresees imminent arrival of AGI and job reductions [News article]. https://forklog.com/en/anthropic-ceo-foresees-imminent-arrival-of-agi-and-job-reductions/
METR. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity [Blog post]. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
YouTube. (2025). Dario Amodei: Anthropic CEO on Claude, AGI & the Future of AI & Humanity [Podcast]. https://youtu.be/ugvHCXCOmm4?si=qdtdV8yHDWkonudB
@張Sir的AI養生館 – 學習智人
by angus | 2026-02-25
這兩天公司內部的節奏有點像坐過山車,昨晚才剛和同事A把那份「市場營銷報告」磨到深夜十一點,今早七點多,又和同事B在網絡會議室討論「投標計劃書」。
雖然面對的場景不同,使用的工具各異,但這兩份由 AI 協助產出的初稿,都散發著一種詭異的「共同氣味」——乍看之下,段落整齊、詞彙專業、厚度十足,像極了一份正經文件;但只要沉下心來細讀,就會發現它經不起推敲。沒有起承轉合的鋪陳,邏輯線若隱若現,更像是一本把各種材料強行拼貼起來的說明書。讀後,很難發自內心地感嘆一句:「原來公司的AI這麼厲害。」
看起來完成了,實際上只是把「文字」提交了
同事B的經歷特別典型:遇到不懂的操作先問技術同事C,再結合同事A手頭的資料,丟給 AI,轉眼間就能輸出一份 Word 文檔。這種效率確實驚人,也值得高興,因為它降低了技術門檻,讓很多原先需要長時間磨練的工作能更快上手。
但也正因為太快,很容易產生一種錯覺,以為自己已經把「計劃」做完了。其實,完成的只是文件的「外形」,而非方案的「骨架」。AI 能把版面填得很滿,但它無法替我們做商業判斷。我們的主張是否真的成立?假設的數據是否真實?流程在港澳的商業環境下能否落地?投入產出比是否合理?那些寫在紙上的承諾,我們是否承擔得起?
這些問題,必須由人緊緊握住方向盤來回答。
最大的坑:認知放棄,人逐漸退出迴路
以上的經驗,或許很多在職場的人士都遇到過。我最想提醒的是,一個聽起來有點學術,但發生在每個人身上的現象:「認知放棄」(Cognitive Surrender)。
簡單來說,一旦人類過度依賴 AI 的自動化流程,大腦就會本能地偷懶,不再深想、不再追問、不再審核,慢慢退化成一個只負責把稿子拼好、把格式調順的「排版工」。
說到這裡,必須再次引入一個我經常在文章中提及的核心概念:人在迴路(HITL, Human-in-the-loop)。用白話講就是——AI 可以跑流程,但每一個關鍵的十字路口,必須有人在場指揮;AI 可以寫代碼或文案,但最終的責任,必須有人來承擔。
因此,可怕的地方在於,這種「放棄」不是瞬間發生的,而是像溫水煮蛙一樣自然而然。第一次覺得「AI 寫得不錯」,第二次覺得「差不多可以了」,到了第三次,對那些明顯的邏輯漏洞也就「輕輕放過」。昨晚同事A那份報告就隱約有這種跡象。第一眼似模似樣,細看卻漏洞百出,這種東西如果直接發給客戶,撞板是遲早的事。效率看似上升了,但團隊的專業水平並沒有同步提高。
「寫得很詳細」不等於「做得到」
AI 有個特點,它特別擅長把內容寫得「很完整」,尤其在流程、步驟、職責分工、交付物這些環節,它能呈現出驚人的顆粒度。這也是同事B提到的感受:明明是不太懂的業務細節,AI 卻寫得頭頭是道。
這時候我們必須額外警惕。計劃書和投標文本一旦白紙黑字寫下「我們能做到」,在客戶看來這就是商業承諾,而不僅僅是一篇作文。AI 讓我們更容易寫出「像承諾」的漂亮句子,也更容易讓我們在沒想清楚之前就把承諾交進去。最終出事的時候,AI 可不會出席會議替我們解釋,更不會幫我們賠償。
如何善用 AI Agent 不會撞板?
為了把我在之前的文章中介紹過的一套AI與人類協作的邏輯具象化,我用AI畫了這樣一張簡潔的流程圖(見附圖):
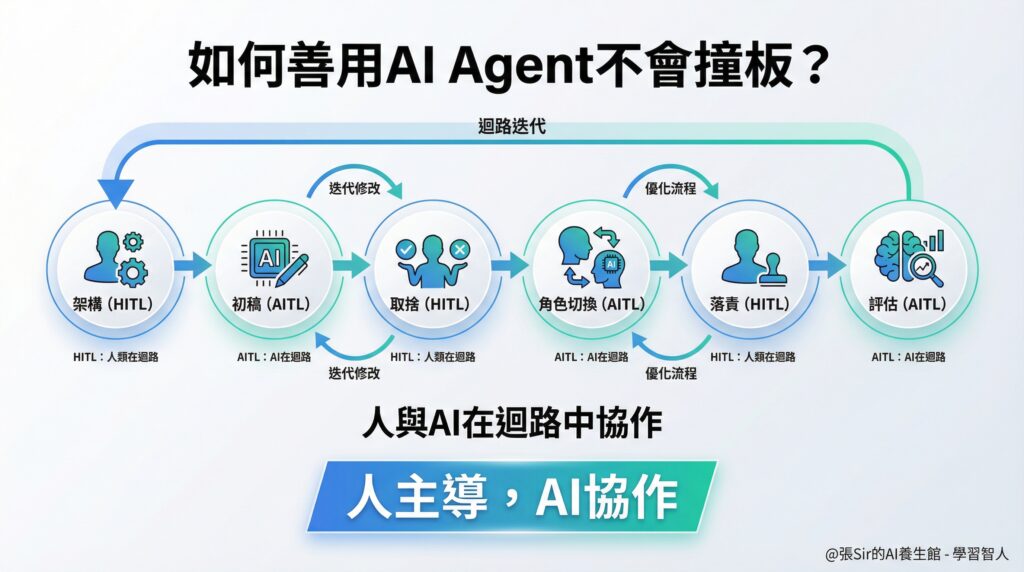
1. 架構(HITL):由人來定義目標與框架。
2. 供給(AITL):AI 負責快速生成素材與選項。
3. 取捨(HITL):人回來做判斷,篩選什麼可用,什麼是垃圾。
4. 角色切換(AITL):AI 根據反饋進行優化或模擬不同的視角,現在可以用多代理(multi-agents) 了。
5. 落責(HITL):人必須確認最終內容的可行性與責任歸屬。
6. 評估(AITL):AI 輔助進行最後的協作評價或合規檢查。
這張圖的核心在於節點間的切換和迴路迭代——人主導,AI 協作。
我自己剛開始寫一些內容時,也犯過沒有迴路的錯誤。覺得省時就一路用下去,結果在該嚴格的地方鬆懈了,在該追問的地方沉默了。因為AI實在太順手了,順手到會讓人誤以為「順」就等於「對」。
說了這麼多,有一點可以預見的是,AI agents 只會越來越強,這是大勢所趨。未來真正拉開差距的,很可能不再是誰用了更貴更強大的 AI。誰的業務流程設計得更深,誰更懂行,誰能始終把「人」留在這個決策迴路裡,誰就站得更高,走得更遠。
所以,與其一開始就讚嘆技術多厲害,我們更值得投資的是一種團隊習慣:把 AI 當作加速器和草稿機,把思考和判斷留給自己。
【張Sir講白話:用AI要帶腦睇路】
#人在迴路 #認知放棄 #HITL #AITL #AI Agent
@張Sir的AI養生館 – 學習智人
by angus | 2026-02-11
很多大人看到中小學生用AI,心情複雜。一方面覺得這很方便,有效率,代表進步;另一方面也擔心,學生做功課像叫外賣,只顧「會吃」,卻忘了「會做」。
這份不安很正常。學生的大腦還在長骨頭,長的不只是詞彙量,還有注意力、理解模型、判斷力,以及對自己負責的習慣。AI 一旦進教室,最容易被偷走的,往往不是分數,而是那段慢慢長出能力的過程。
在上一篇中 [按此閱讀],我借用了兩個概念來拆解差別:「認知卸載」,是把部分工作交給工具,方向盤仍在自己手上;「認知放棄」,是連推理、判斷、責任也一起交出去,看見順滑輸出答案就當作完成。這一篇重點在一個更敏感的問題:學生怎樣用 AI 做功課,才不會不
知不覺滑向「認知放棄」?寫作只是其中一種形式,理科題、閱讀報告、專題簡報,同樣存在風險。
「先想再用」是方向盤
我們常把 AI 視作會吐答案的機器,其實它更像班上那位總在課間幫同學做作業的「神助攻」:速度快、表情淡定,還總能把錯題講得好像自己全對過一樣。老師都得特別留神,學生哪能不被吸引住。
最常見的情境是,學生把題目貼進 AI 對話框,拿到一段看似完整的答案,然後就複製或下載。他以為自己學懂了,其實只是完成了交功課的動作。
答案對不對當然重要,更要緊的是,他有沒有經歷過思考。學習的肌肉不靠閱讀答案長大,靠的是推敲、撞牆、修正、再試。答案來得太快,學生就少機會在卡住的地方鍛鍊出理解力。
因此,課堂裏更容易出現「認知放棄」,原因很現實。時間緊、評分只看成品、能力又仍在成形,AI 很容易由工具變成代勞者。學生一旦習慣直接把答案交出去,久而久之就會忘了腦袋本來要用來判斷和推理。
- 時間壓力:功課多、考試近,最快完成的捷徑永遠最誘人。
- 回饋機制:目前的評分只看成品,學生自然把心力放在「看起來像完成」。
- 能力仍在成形:注意力、判斷、責任習慣尚未穩定,容易把工具當終點。
把 AI 放在「教練位」:它負責提問,學生負責思考
若學生一開始就找 AI 拿答案,看到的只是一份完成度高的作文、報告或解題過程,卻看不到思考痕跡。那種「做得很像懂了」的狀態,就是我說的「熟口熟面」:像學會了,實際上只是借了個殼。
更穩妥的做法,是把 AI 放到「教練位」。教練不會替你跑全程,它擅長的是追問與拆台:你怎樣得出這個結論?憑什麼這麼說?有沒有反例?前提站得住嗎?換個場景還成立嗎?換題型還適用嗎?
學生需要的正是這種提問。很多人不是不會想,是不知道從哪開始;AI 用得好,能把「開始思考」變得更容易。
一個最小可行流程:學生先出骨架,AI 只負責提問
我們可以設計一個簡單的流程,讓它易落地,重點在順序。先讓學生動腦,再讓 AI 進場。
首先,讓學生寫骨架:理科題寫明已知、要求、擬用公式或定理,以及每步邏輯。用自己的話列出解題思路、立場、理由、概念、例子與結論,粗糙無妨,反而看得出真動過腦。
接著,讓 AI 當教練提問,針對骨架發問,例如:
- 這一步依賴的前提是什麼?
- 有沒有反例或例外?
- 這個例子能代表整體嗎?
- 換個情境或題型還成立嗎?
- 結論能否收斂一點,避免說過頭?
最後,學生重寫定稿,將答案轉為自己的表述,補漏、修正、補充例子或推導,提交真正的「學生版本」。
這一步就像練功房:AI 是沙包,你打它,它回彈;你就知道哪裡力道不足。打完一輪再補一輪,肌肉才長在自己身上。
家長和老師看什麼:看思維痕跡
家長與老師若想配合這個流程,可以先從「看痕跡」開始。
當 AI 能把成品修得很光滑的時候,越需要回頭找痕跡。例如,我們可以拿幾個實用的觀察點來測試一下:
- 能不能口頭復述?學生講不出來就很危險。
- 能不能指出一個反例?學生只會順著說,通常是借來的理解。
- 能不能說出自己改了哪裡?改動越具體,思考權越可能在學生手上。
老師那邊若願意把評核的一小部分放到過程上,像草稿骨架、AI 提問回合、重寫版本,往往比單一成品更能反映學習。
這些做法看似麻煩,其實是把兩件事放回學習核心:讓學生在乎準確性,並得到即時反饋。當學生知道「思考過程會被看見」,他才更願意抵抗「認知放棄」,握回學習的方向盤。
回歸教育的本質
一直以來,抄襲至少一眼看得出來。學生抄了,多半也知道自己做了甚麼。但「認知放棄」一旦成習慣,長期下去更危險。這種麻煩不在一次作業的對錯,而在於它會慢慢變成學習方式。它會令學生感覺自己很努力——複製貼上也要動手,潤色改寫也花時間。這份努力非但沒長在思考上,反而貼在包裝上,看起來還很光明正大。
所以這篇先做一件事:把順序調過來,先想再用,讓思考過程重新被看見。我的目的很簡單:使用 AI 時,讓學生仍然有理由去思考,並得到針對思考過程的真實反饋。AI 沒有改變學習的核心,它把另一件事放大了:答案變得更容易拿到,學生也更容易跳過思考。當答案像自來水一樣隨手可得,真正稀缺的就回到人身上:學生有沒有想清楚問題,能不能質疑,願不願意為自己的答案負責。
@張Sir的AI養生館 – 學習智人