前沿模型的分數一代勝一代,用戶卻覺得它變笨了
協作者:張Sir與AI
設想一位同事請 AI 修改給客戶的電郵,原本只想用幾句話說明項目要延遲兩天。AI 卻寫成六段,列出背景、風險、跟進步驟和免責聲明,語氣像正式公函。客戶最想知道的新交付日期,反而藏在最後一段。
同一位同事換一項任務,請 AI 修一段程式碼,它的表現卻完全不同。AI 會讀完整個項目說明,找出問題,修改幾個檔案,跑一遍測試,發現改錯了又回頭修正。整個過程像一位不用休息的初級工程師,默默地把工作做完。
同一個模型,兩種體驗,評價卻可以相差很遠。要理解這種差別,得先看行業現在最想要什麼。
行業在優化什麼
過去幾年,前沿大模型公司除了改進寫文章、翻譯和解釋概念,更用力發展代理式能力(agentic capability),即 AI 能自己規劃步驟、調用工具、執行動作,並根據結果修正。以修正程式錯誤為例,它會先讀架構設計,找出相關檔案,改程式,再跑測試。測試失敗,它就看錯誤訊息,回頭調整。
對開發者來說,一個能自動完成多個檔案修改的 AI,確實可能省下大量時間。但對一般用戶,常見的感受卻是另一回事,輸出的中文變得生硬,回答像產品說明書,簡單的問題也要先列步驟、分類、注意事項。
兩種感受來自同一套選擇:公司在哪種能力上投入資源,就很可能得到哪一種能力。
為什麼編程成了主戰場
編程(coding)之所以成為主戰場,是因為它的對錯很清楚。程式能不能運行,測試會不會通過,錯誤有沒有修好,全部可以自動檢查。這讓 AI 公司能快速知道自己有沒有進步,也讓企業客戶容易算出價值。相反,「這段中文讀起來自不自然」「這個解釋能不能讓非技術的主管聽懂」,很難變成一個數字。
業界用來比較模型的標準化測驗,叫基準測試(benchmark)。SWE-bench 是其中最有名的一套,它從真實的開源軟件問題中挑出題目,要求 AI 修改程式並通過測試。一段時間內,它幾乎成了編程模型的成績單。
某種能力愈容易量度,公司就愈容易比較成績,也愈容易把進步做成產品。編程任務可以拆成明確問題,由測試自動驗收,節省多少工時也較容易計算。在前沿模型競賽中,它既能展示能力,也較快轉化成企業願意付費的服務。中文行文是否自然、解釋能否讓人聽懂,較難用單一分數衡量,對成本和收入的影響也不容易立即看見,所以即使沒有人刻意忽視,優先次序仍可能排在後面。
分數高,不等於真會做事
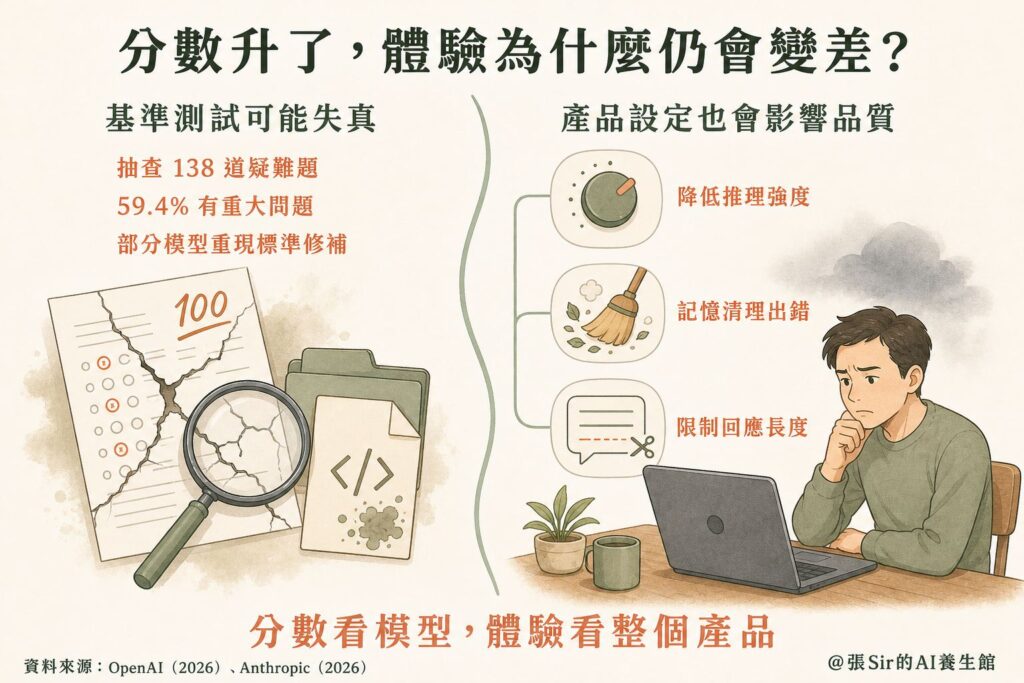
2026 年 2 月,OpenAI 停止公布 SWE-bench Verified 的成績。SWE-bench Verified 是 SWE-bench 的篩選版本。OpenAI 抽查了 138 題,都是它自家 o3 模型反覆解不出的題目,佔題庫約 27.6%。結果發現,其中 59.4% 的測試或題目描述有重大問題。有些測試會拒絕功能上正確的解法,例如要求模型使用題目根本沒有提過的函式名稱,答對的人反而被判錯。
另一個問題更根本,就是污染。SWE-bench 的題目取自公開的開源項目,受測的前沿模型都能在部分題目上重現原本的標準修正,甚至說出題目的原文細節。這表示它們在訓練時,很可能已經見過部分題目和解答。
這正是古德哈特定律(Goodhart's law)所說的情況:當一個指標變成了目標,它就不再是好指標。模型學會應付測驗,分數很漂亮,未必能在陌生的項目裡把事情做好。
能力確實在進步,獨立研究提供了數據的支持。METR以 HCAST、RE-Bench 等任務,測量 AI 有一半機率完成的任務,人類專家通常要花多長時間。2025 年的研究估計,2019 至 2025 年間,這個長度約每七個月翻一倍。研究同時提醒,這衡量的是有一半機率完成的情況,不代表 AI 能穩定完成同樣長度的任務。
分數說明得了模型會做什麼,卻無法告知用起來是什麼感覺。這種差別,在產品上更明顯。
感覺變差,可能來自產品的取捨
2026 年 4 月,Anthropic 發表了一份關於 Claude Code 質量下降的事後報告,解釋用戶為什麼覺得它變差了。Claude Code 是 Anthropic 的編程工具。報告指出,問題來自三項產品層的改動。
第一項改動為了降低延遲,Anthropic 在 3 月把 Claude Code 的預設推理強度(reasoning effort,指模型回答前投入思考的程度)由高調為中,目的是減少介面長時間思考時看起來卡住的情況。用戶很快察覺回答變淺了,Anthropic 在 4 月 7 日撤回了這項改動。
第二項改動出在記憶上,3 月 26 日上線的一項優化,本來是為了加快閒置對話的恢復速度,卻因為程式錯誤,令模型每一輪對話都清走先前的推理紀錄,而原本的設計只應清除一次。於是 Claude 還能繼續工作,卻漸漸忘了自己剛才為什麼這樣做,出現健忘、重複,甚至奇怪的工具選擇。
第三項改動為了減少冗長,Anthropic 在 4 月 16 日於系統提示中加入限制,要求每次調用工具之間的文字不超過 25 個英文單詞,最終回應通常不超過 100 個單詞。報告承認三項改動都造成了質量下降,同時表示底層模型不受影響,也沒有刻意降低模型質量。
該報告談的是編程工具,沒有談到中文寫作,但它清楚說明了一個道理,為了速度、成本或簡潔而做的產品層調整,會先被用戶感覺到,而且感覺是整體變差。用戶口中的「降智感」,有時變的是整個產品的運作方式,模型本身未必有變。
這也解釋了為什麼感受常與基準測試分數脫節,因為分數只看任務有沒有完成,產品調整卻會改變過程中的每一步。
用戶的感受也應該量度
既然感受會受產品調整影響,評測就不能只看模型能不能完成任務。用戶的評價本身,也應該被納入。
一套政務公文系統的經歷,可以說明這一點。據某地方政府導入公文系統的報道,熟手處理一份公文的時間,由最快二十分鐘縮短到兩分鐘。張Sir在《政府公文 AI 的第 90 天》分析過這類系統上線後的變化。頭一兩個月,時間縮短這麼多,用戶自然覺得好用;熟悉之後,省下的時間不再顯眼,偶爾出現的錯誤卻格外刺眼。這些變化,大致對應三種現象。
第一是新奇效應(novelty effect),新工具因為新鮮,初期的評價和使用率通常較高,熟悉之後這份好感便會淡去。第二是期望不確認,用戶滿不滿意,取決於實際表現與事前期望的差距,兩分鐘一旦成為日常,期望就跟著升高。第三是算法厭惡(algorithm aversion)。一項經典研究發現,看到算法犯錯後,人對它的信心下降得比看到人犯錯後更厲害,即使算法的整體表現更好。
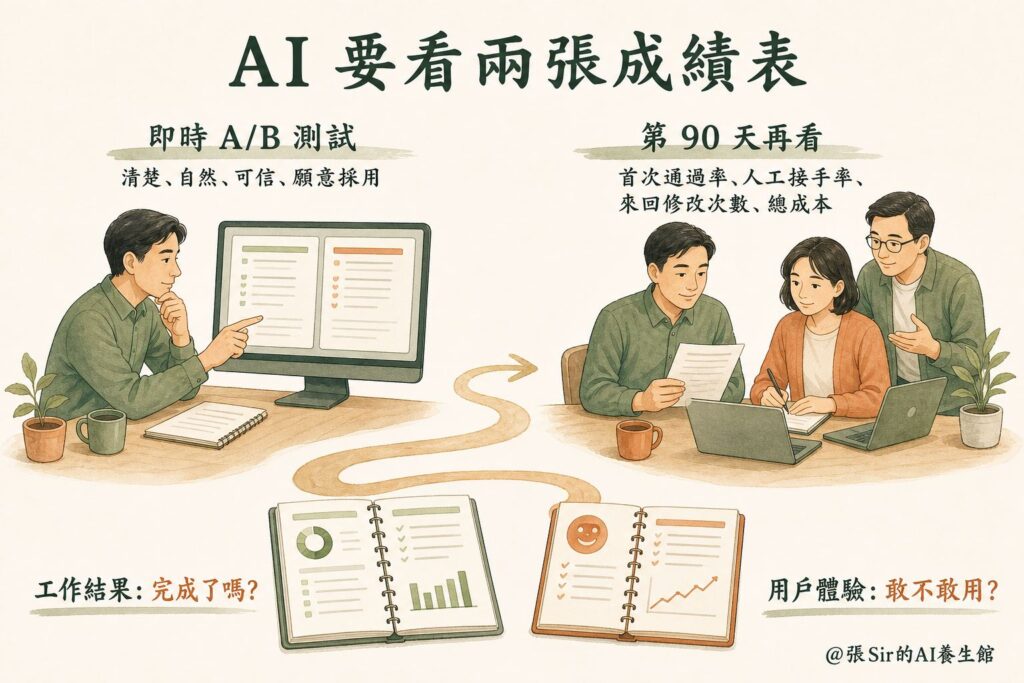
這些變化可以在測試中捕捉到,張Sir團隊在一個政務 AI 項目中做過配對 A/B 測試,用同一組任務和附件,同屏並列兩個版本,讓實際用戶比較內容是否清楚、自然、可信,以及是否願意採用。用戶的判斷,就這樣變成了可以比較的數據。
用戶評價要看哪些指標,也要事先說清楚。以政務公文為例,任務完成率、首次通過率、人工接手率、平均來回修改次數,以及每項成功任務的總成本,都比帳號數或生成份數更能說明系統是否可用。張Sir團隊在項目中看到,人工核對、錯誤重跑、格式修補和跨部門溝通,經常比模型的調用單價更影響總成本,所以總成本要把這些開支一併算進去。
誰來覆核,誰來維護數據
業界稱這種安排為人在迴路(human-in-the-loop, HITL),即在關鍵環節保留人的判斷。這個迴路需要兩個崗位。用戶端的人是承辦人員和審批人,可以改稿,也能看見生成的依據,對系統保有參與感。平台端的人負責維護數據,哪一條仍然有效,哪一條已經撤銷,哪個部門改了名,都要按週期更新。前者決定用戶會不會繼續用,後者決定系統到了第二年還準不準。
這些安排聽起來很瑣碎,卻是很多 AI 產品最容易省掉的部分。演示時,AI 看起來能獨立完成整件事。到了第 90 天,用戶才會慢慢分辨,哪些任務可以放心交給它,哪些仍要自己把關。
會完成任務,不等於會當同事
一個具備代理式能力的 AI 可以寫出能通過測試的程式,卻不代表它理解這段程式為什麼存在。它可能知道要讓檢查通過,卻不知道檢查背後的目的;它可能完成了指令,卻沒有察覺指令會影響其他功能;它也可能產出大量技術細節,卻無法把重點講成產品經理、客服或主管聽得懂的話。開場那封電郵也是如此,六段內容看來完整,客戶最關心的新交付日期卻藏在最後。
一位好的同事,除了把交辦的事做完,還會問:這樣做會不會影響其他人?有沒有更簡單的做法?結果怎樣向不懂技術的人解釋?AI 若要從工具變成協作者,也需要這些能力。因此,衡量它的進步時,不能只看編程測驗,也要看它能否安全、可靠地完成任務,並把過程與結果說清楚。
說回開場,下次 AI 把一封簡單電郵寫成六段,同事不妨先問一句:客戶看完第一段,知道新的交付日期嗎?若答案仍藏在最後,這封信便未算完成。
@張Sir的AI養生館 – 創新智人
參考資料
Anthropic. (2026, April 23). An update on recent Claude Code quality reports. Anthropic Engineering.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
Kwa, T., West, B., et al. (2025). Measuring AI ability to complete long tasks. arXiv.
OpenAI. (2026, February 23). Why SWE-bench Verified no longer measures frontier coding capabilities. OpenAI.