企業場景裡,關係要連起來,更要有專人長期維護
協作者:張Sir與AI
上篇談過本體論、知識圖譜和 harness 的分工。這一篇接著看三者進入企業場景後怎樣運作,先從一家律師行說起,再談品牌、營銷和培訓三個場景,最後看這一切要靠什麼長期維持。
如何把關係帶進法律工作
抽象概念進入一門具體業務後會怎樣,可以看看 Kirkland & Ellis 與美國數據公司 Palantir 的合作。今年 6 月,這家美國大型律師行與 Palantir 宣布建立專有平台,用於私募基金集資業務。新聞稿提到,律師行看中 Palantir 在本體論方面的專長,希望把基金、義務和交易紀錄等數據連成一個運作系統,把資深律師的判斷帶進工作流程,供一千多名支援投資基金組業務的律師使用。工作範圍包括基金文件和附函(side letter,記錄投資者個別約定的文件)起草、義務追蹤和持續合規。
用一個簡化情境來看,假設某位投資者要求特別待遇,本體論先定義基金、投資者、承諾、法律義務和交易紀錄各是什麼,也規定它們可以怎樣連接;知識圖譜再把這位投資者的承諾連到相關基金、由此產生的義務、負責人和到期日。律師查問某隻基金有哪些承諾要跟進,系統便能沿著已建立的關係查找。Harness 則按律師的權限提供內容,並在需要批准或執行下一步時套用流程。受時效或跟進要求約束的記錄,要連著有效條件或版本、負責人和期限,這個做法同樣適用於品牌、營銷和培訓。
Kirkland 展示本體論怎樣進入法律工作,Lawminer 則讓張Sir團隊累積了建立知識圖譜和本體論的實戰經驗。團隊六年前在香港研發 Lawminer 平台,連接香港法律條文、約三十年的法院判案書,以及涉及的機構、人物和律師事務所;項目堅持了三年,疫情期間資源耗盡而進入休眠狀態。不過,這段經歷說明,把法律文件、機構和人物之間的關係連起來,系統更容易沿著業務脈絡查找線索和發現關聯。
三個企業場景怎樣起步
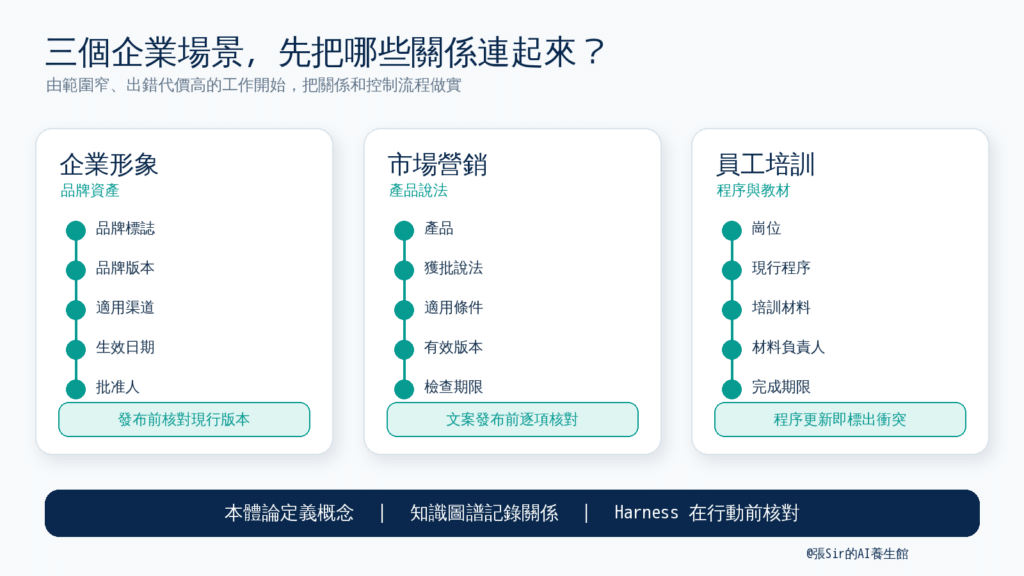
多數企業沒有 Kirkland 這樣的團隊和預算,起點往往零散得多,常見的是影子AI,即個人未經公司批准,私下使用 AI 處理公司工作。這種做法已相當普遍,張Sir曾在《影子 AI 的暴走潮》談過。企業若想把零散的個人使用變成可控制的工作流程,可以先挑一個範圍窄、出錯代價高的場景,不必一開始便覆蓋全公司,由業務部門指定負責人,資訊科技部門從旁協助,先定下要管哪些概念、什麼條件才有效、由誰負責。
企業形象可以由品牌標誌開始,每個檔案連到品牌版本、適用渠道、生效日期、批准人和現行狀態,口號和對外說法也照同一原則處理。Harness 發布前按渠道和日期核對,沒有有效版本便停止或交人處理。若對外內容提及政府部門或官員,知識圖譜也要涵蓋相應名稱和職銜,否則品牌標誌用對了,職銜仍可能寫錯。
市場營銷要再加入說法和條件,一項產品可以宣稱什麼、要附什麼條件、哪些說法已撤回,往往散在法務意見、產品文件和舊稿。公司可以把產品連到獲批說法、適用條件、有效版本、批准人和檢查期限,讓 harness 在文案發布前逐項核對。
員工培訓則要處理程序與教材的同步,新同事問 AI 某件事怎樣做,答案可能來自已修訂的舊程序;程序一改,教材、測驗和崗位指引也要檢查。公司可以把崗位和流程連到現行程序、適用人員、培訓材料、材料負責人和完成期限。Harness 發現程序已有新版而教材尚未更新時,可以標出衝突、暫停引用或交給負責人處理,回答也應顯示所用文件及版本。
長期數據治理,把企業知識變成數字資產
上述結構不會因為買了一套系統便自行出現,業務概念的定義、數據清理、版本狀態和責任人都要逐步建立,核對頻率也要按變化速度和出錯代價決定。部門改名後若沒有人更新,本體論即使定義完整,Agent 讀到的仍是舊數據。
這份維護工夫,張Sir和團隊二十多年前已開始,當時整理和分析的是大量新聞及公眾意見,後來加入機器學習(machine learning,讓系統從數據找規律的方法)和自然語言處理(natural language processing,NLP,讓電腦分析人類語言的方法),今天再用大型語言模型輔助初步整理。
早年做內容分析(content analysis,按預先分類整理和比較內容的方法),團隊先定義分類並寫成手冊,讓兩位分析員獨立處理同一批樣本,再計算一致程度;遇到分歧,便討論或交由第三人裁決。張Sir在《Jev 爆紅,張Sir覺得很眼熟》有較詳細介紹。
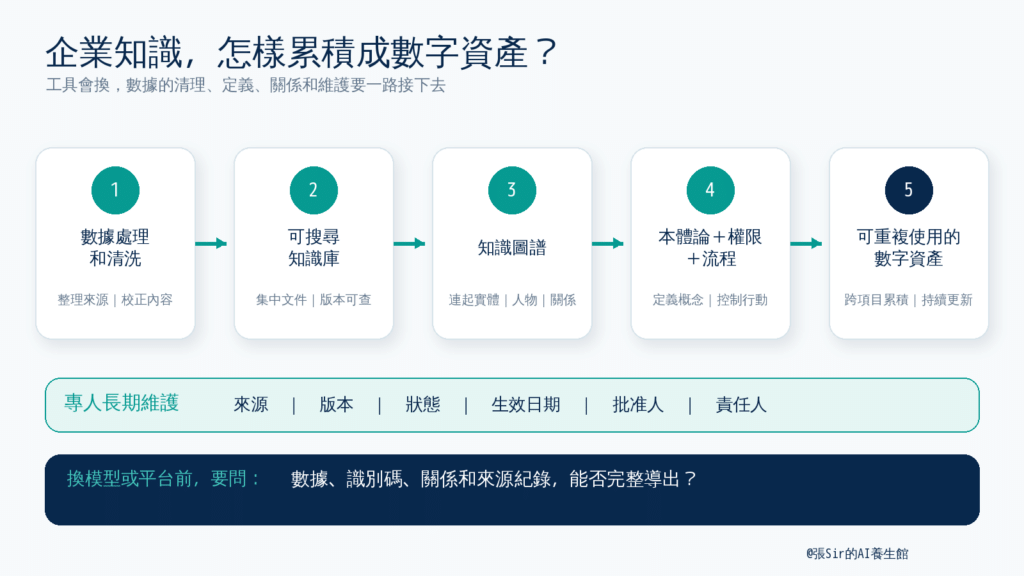
團隊先處理和清洗數據,逐步建成可搜尋的知識庫,再把實體與關係連成知識圖譜,今天進一步接上本體論、權限和控制流程。這是團隊在自身項目和技術條件下走過的歷史經驗,企業可按自己的起點和需要決定次序。二十多年來累積的港澳本地數據和知識,經過清理、定義和維護,逐漸成為可重複使用的知識底座與數字資產。
多年累積的知識,換平台後還帶得走嗎?
長期投入也帶來一個重要的採購問題,企業累積的知識能否搬走。據 Bloomberg Law 6 月 15 日的報道,Kirkland 確認其平台架構不綁定單一模型,可以替換底層基礎模型(foundation model,可支援多種 AI 任務的通用模型)而毋須從頭重建,也避免被包括 Palantir 在內的單一 AI 服務供應商鎖定。這項安排處理的是模型層的鎖定;企業知識能否完整導出,仍要另外確認。
企業採購前可以問三件事,其一是公司建立的本體論、具體數據、識別碼、版本和來源紀錄能否完整導出,其二是規則改動後何時生效、怎樣測試,舊答案怎樣處理,其三是 Agent 回答或執行動作後,系統能否追溯所用的數據來源、版本、關係和批准規則。這些問題可以作為第一輪檢查,幫助企業判斷能否掌握多年累積的知識。
回到企業形象一節的品牌標誌場景,品牌部記下的版本、渠道、生效日期和批准人,要再加上新版取代哪一版的關係,harness 才查得到現行版本並放行。更換模型或平台時,這些記錄和關係也要能完整導出,多年累積的版本歷史才不會隨平台消失。規矩裡的「現行」至此才有可以執行和查證的定義,Agent 也才有條件聽話。
@張Sir的AI養生館 – 創新智人
參考資料
Killelea, E., & Strom, R. (2026, June 15). Kirkland's $500 million AI gambit requires a cast of hundreds. Bloomberg Law.
Kirkland & Ellis. (2026, June 4). Kirkland & Ellis and Palantir partner to transform private equity fundraising with exclusive AI-powered fund enterprise platform \[Press release].