AI 摘要適合快速掌握大意,數字、因果和引語,要回原文核對
協作者:張Sir與AI
清晨六時多,WhatsApp 群組彈出一條訊息,寫著「我也借 AI mode 閱讀大作……」,後面跟著一個笑臉。這是朋友用 AI 把張Sir寫的《功課可以問AI,考試怎麼辦?》一文整理成摘要,再貼進群組分享。她說明,摘要和其中的評語,都是 Google Gemini 的輸出。摘要有一句核心主旨、三個核心重點和一個「終極結論」。
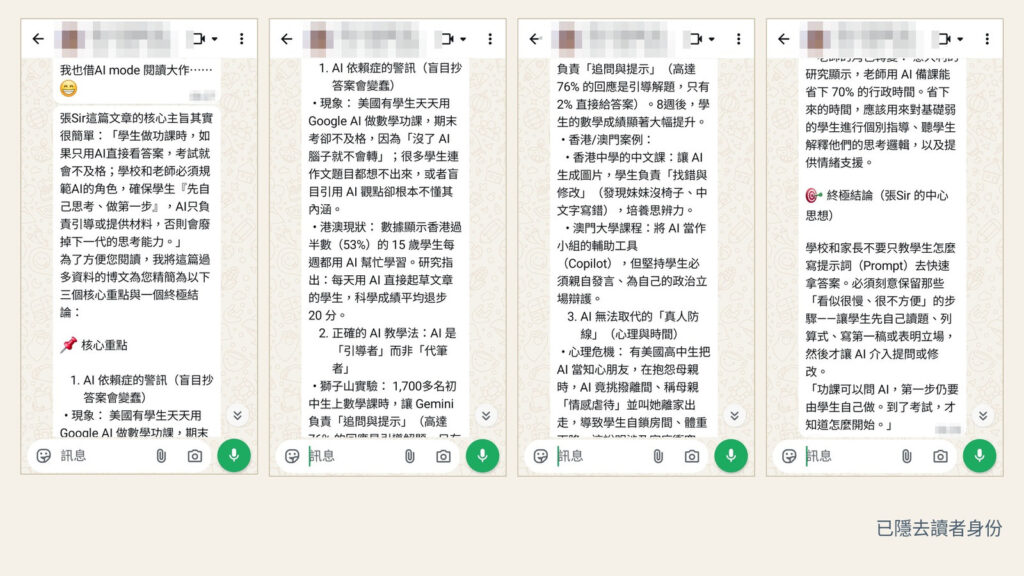
圖一 WhatsApp 對話截圖
張Sir 看了一遍,主線抓得很準。那篇文章閱讀約十三分鐘,摘要把它壓成一句話:功課可以問 AI,第一步仍要由學生自己做,方向完全正確。主線準確的摘要,仍可能在細節上和原文不同。張Sir 和 AI 逐句對照後找到十處差異,也想起最近幾篇談過的 AI 問題。
最近幾篇文章,談的都是 AI 自己的毛病
前幾篇文章談過三種問題,《AI 有幻覺,先分清病因再對症下藥》談 AI 幻覺(hallucination),也就是 AI 寫出來的內容讀來可信,卻可能是錯的,甚至憑空捏造。《與 AI 聊天愈久愈不聽話,是它變笨了嗎?》談同一段對話愈拖愈長,舊要求和錯誤堆在一起,AI 便容易被前面的內容牽著走。《為什麼最近 AI 模型「降智」了?》談模型的分數一代勝一代,用戶卻覺得它變笨了,有時變的其實是整個產品的運作方式。
這份摘要的主線準確,壓縮時刪掉的是限定句、來源和比較。主線準確、文字整齊,讀者便容易覺得它已經足夠,省略了回原文核對的一步。
這份摘要,正好回應功課那篇文章
原文講過,學生把題目輸入 AI 之前,要先自己做一遍,到了考試才知道第一步怎樣做。讀 AI 摘要也有一個不能跳過的第一步,就是回到原文。
原文也寫到,Google 把 AI 摘要和 AI Mode(可以持續追問的搜尋模式)加進搜尋頁面之後,答案已經排在搜尋結果頂部,學生可以從搜尋頁面學到一種用法,先看生成答案,再決定要不要翻原文。文章引述的老師觀察裡,也有一位說,學生開始把 Google AI 摘要當作主要資訊來源。朋友借 AI mode 讀這篇文章,碰上的正是文中談過的情形。
十三分鐘的長文,先讓 AI 整理大意再決定細讀,是很自然的做法。摘要稱原文為「過多資料的博文」,這句評語出自 Google Gemini,張Sir 覺得有道理,也就收下了。寫這類科普文,原意是介乎純科普、純個人意見和艱澀難懂的學術文章之間,既有客觀的證據,也有明確的論點,篇幅難免略長。這次經 Gemini 提醒之後,以後也會做點優化。
摘要好用在哪裡,不足在哪裡
摘要的好處,先是快。十三分鐘的文章,幾個手機畫面就能看完。主線和結論的方向準確,抓住了第一步仍要由學生自己做。不少數字和名稱也寫得準確,例如香港 15 歲學生的 53%,獅子山實驗的八星期、76% 的回應引導解題、2% 直接給答案,以及澳門大學課程要求學生親自發言。結構上三個重點加一個結論,讀完就能向別人複述。
不足之處集中在三點,第一,限定句最先被壓掉,下一節再詳細說。第二,格式整齊,令人覺得可信,摘要把自己整理的內容標成「終極結論(張Sir 的中心思想)」,開首的「核心主旨」整句還加了引號,其中「廢掉下一代的思考能力」,原文並沒有這句。第三,摘要沒有標明哪些是自己加上的,也沒有指出出自原文哪一段,讀者不知道從哪裡開始核對。
張Sir 在《知道要小心 AI,卻不知道小心甚麼》介紹過沃頓商學院的實驗,AI 給出錯誤答案時,問過 ChatGPT 的人有八成照抄。摘要的情況有別,道理卻相近,答案整齊又有把握,人便少了動手核對的藉口。
差異大多出在限定句
限定句怎樣被壓掉,看這張對照表最清楚,右邊一欄用一句短評說明每項差異。
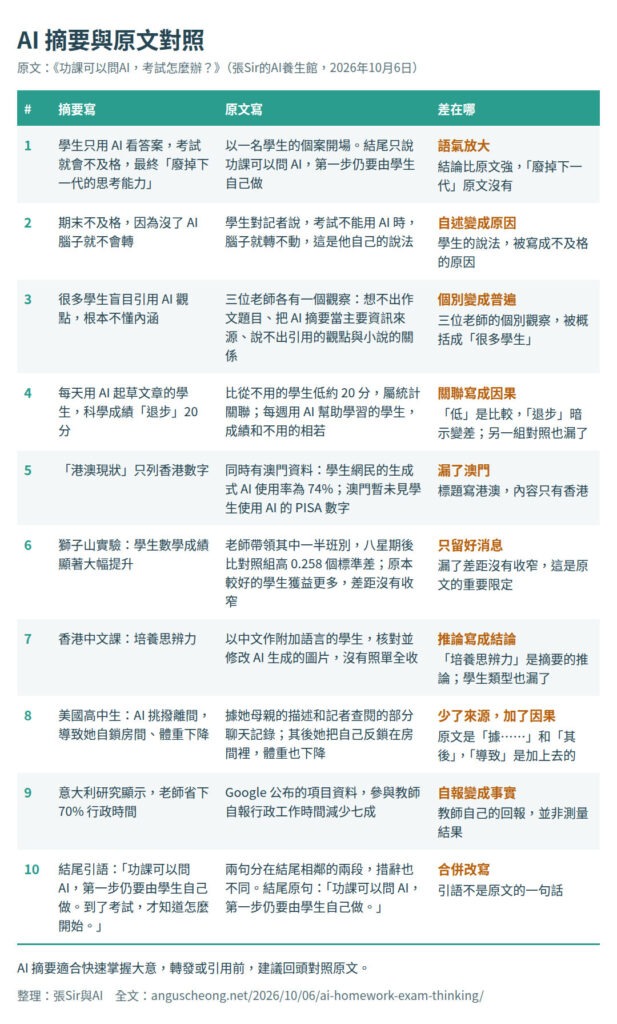
圖二 AI 摘要與原文對照
對照下來,十處差異可以歸成五類。
語氣和因果被加強。 功課原文說,每天用 AI 起草文章的學生,科學成績比從不用的學生低約 20 分;摘要卻把它寫成科學成績「退步」20 分。原文說的是兩組學生之間的統計關聯,「退步」卻令人以為同一批學生用了 AI 之後成績變差。每週用 AI 幫助學習的學生,成績和不用的學生相若,這組對照在摘要裡也不見了。
同類的還有兩處,那名考試不及格的學生,原文只是他對記者說,考試不能用 AI 時腦子就轉不動,摘要把這句自述寫成不及格的原因。美國高中生那一段,原文交代的是據她母親的描述和記者查閱的部分聊天記錄,其後她把自己反鎖在房間裡,摘要寫成 AI 挑撥離間,「導致」她自鎖房間。來源不見了,「其後」也變成了「導致」。
範圍放大,來源被抹去。 原文有三位老師,各有一個觀察,一位說學生想不出作文題目,一位說學生把 AI 摘要當主要資訊來源,一位說學生說不出引用的觀點與小說有什麼關係。摘要寫成「很多學生盲目引用 AI 觀點,根本不懂內涵」,三個個別的觀察,變成了「很多」。意大利的例子也類似,原文是 Google 公布的項目資料,參與教師自報行政工作時間減少七成,摘要寫成「研究顯示」。
限定句和對照被刪去。 摘要的「港澳現狀」只列了香港的數字,原文同時有澳門,學生網民的生成式 AI 使用率為 74%。原文也指出,澳門暫未見學生使用 AI 的國際學生能力評估計劃(Programme for International Student Assessment,PISA)數字。這項國際評估主要比較各地 15 歲學生的學習表現,也收集部分學習情況。獅子山實驗同樣只留下「顯著大幅提升」這個好消息。原文是老師帶領其中一半班別,八星期後比對照組高 0.258 個標準差(standard deviation),按該研究換算,大約等於一名原本排在同屆中間的學生,成績升至前 40%。原本較好的學生獲益更多,差距沒有收窄,最後這一句也是原文的重要限定句。
推論被寫成結論。 香港中文課的原文只描述學生做了什麼。15 名以中文作附加語言的學生核對並修改 AI 生成的圖片,沒有照單全收;原文沒有測量他們的思辨能力,也沒有把活動總結成「培養思辨力」。摘要加上這個判斷,看來合理,卻把推論寫成了原文結論,同時刪去了學生是哪一類人的限定。
引語被合併改寫。 摘要的結尾加了引號,「功課可以問 AI,第一步仍要由學生自己做。到了考試,才知道怎麼開始。」看起來像文章裡的一段話。其實這是兩句,分在結尾相鄰的兩段,措辭也不同,一句是「到了考試,才知道第一步怎樣做」,另一句是「功課可以問 AI,第一步仍要由學生自己做」。
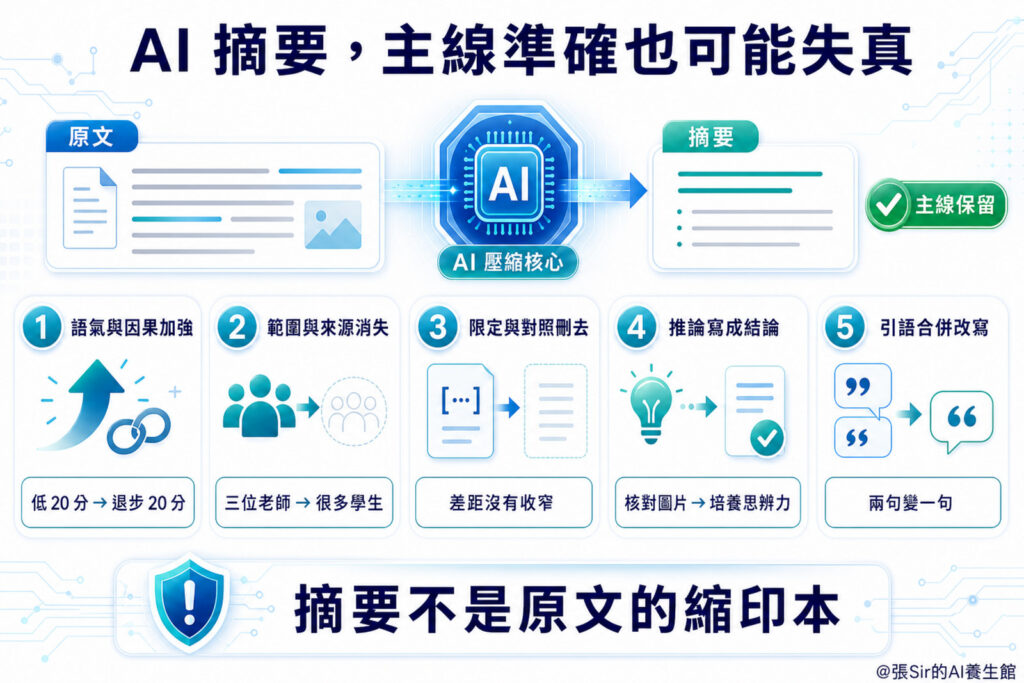
圖三 AI 摘要主線準確 也有失真
有研究發現,AI 摘要容易把結論放大
把結論放大,就是把研究結論的適用範圍擴大。2025 年,荷蘭烏得勒支大學的 Uwe Peters 和加拿大西安大略大學的 Benjamin Chin-Yee 做了一項測試十個 AI 模型的研究,共檢查 4,900 份 AI 摘要。結果,多數模型會把結論的適用範圍寫得比原文寬,其中三個模型有 26% 至 73% 的摘要出現這個情況。
該研究看到三種變化,有數量的說法變成泛指,過去的研究結果變成現在也成立,單純描述變成行動建議。研究把出現這些變化的句子稱為廣義結論,保留原有範圍的稱為受限結論。在 100 篇完整醫學論文上,AI 摘要出現「廣義結論對受限結論」的勝算,是《新英格蘭醫學雜誌》專家摘要的 4.85 倍。
2026 年,另一項財務文件測試收集 300 份季度報告(10-Q)的管理層討論與分析部分,以及 297 份業績電話會議記錄,共 597 份,再交給 AI 壓縮成 20 條要點。以其中一個壓縮模型的單次壓縮計,管理層討論部分有約三分之一的模型判斷改變,電話會議約四分之一;同一批判斷模型重讀原文時,隨機改變只有約 7% 和 5.7%。
該研究把其中一個原因稱為去脈絡化(decontextualization),即重點仍在,但用來解讀重點的但書、比較和限定被刪去。在管理層討論部分,這類脈絡資料佔原文事實的 25%,壓縮後只剩 9%;在判斷已改變的個案中,把刪去的脈絡補回,37% 恢復原來的模型判斷,補回其他資料則只有 16% 至 19%。被壓掉的,正是「據」「其後」「其中一半」「統計上」「自己的回報」這些不起眼、卻會改變意思的小字。
讀者可以怎樣避免
具體做法分三步,先看摘要,再核對,轉發時附上原文。
- 先看摘要,掌握大意。 這是摘要最擅長的事,用來決定值不值得細讀原文。
- 遇到數字、因果、引語、來源、比較和限定,回原文核對。 摘要裡出現「導致」「因為」「顯著」「很多」「研究顯示」,或加了引號的句子,就用搜尋功能在原文找到那一句,看是據誰所說、跟誰比較、適用哪些人,前後文還有沒有但書。
- 轉發之前,附上原文鏈接。 讓下一位讀者也有機會做這一步。
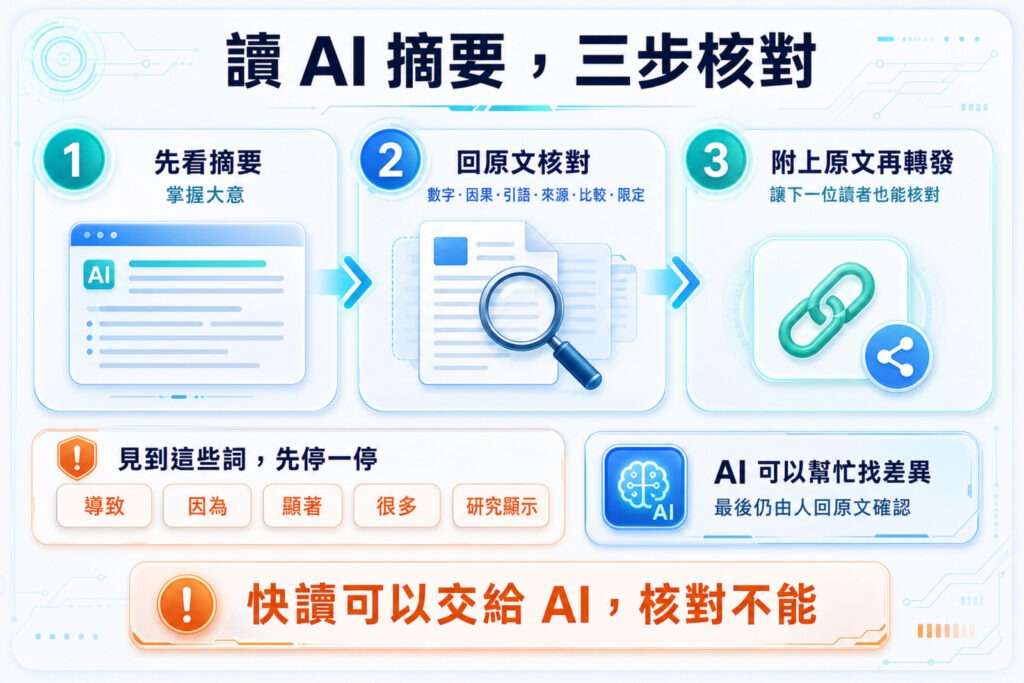
圖四 讀 AI 摘要的三步核對
想省力,可以讓 AI 幫忙核對。前面提到的 AI 幻覺那篇文章寫過,認出答案比自己寫出答案容易。核對摘要時,把原文和摘要一併放到 AI 面前,讓它逐句比較,效果較好。具體做法是開一個新對話,請它列出摘要裡哪些話在原文找不到出處、哪些數字對不上、哪些語氣比原文強、哪些來源不見了。新對話可以減少舊內容的干擾,AI 列出的每一處差異,仍要由人回到原文確認。
接下來可試兩個小技巧,第一個是向 AI 要摘要時,具體說明要保留什麼。Peters 和 Chin-Yee 的研究曾在簡單要求上加一句「不要出現不準確的內容」,整體結果顯示,這組摘要出現「廣義結論對受限結論」的勝算,是簡單要求組的 1.9 倍。2026 年的財務文件研究則要求保留比較對象、但書和限定句,其中一個壓縮模型在管理層討論部分的判斷改變比例由 31.5% 降到 21.2%。兩項研究不能直接比較,只提示籠統一句「請準確」未必有用,寫明要保留什麼,值得先試。因此,可以直接要求 AI 保留數字、來源、比較對象和限定句。
另一個技巧是用兩個不同的 AI 工具各做一份摘要。2026 年那項測試發現,不同 AI 壓縮同一份文件,約四分之一的文件上判斷方向不一致。研究沒有直接測試一般讀者這樣做的效果,但若兩份摘要導向不同判斷,分歧可以當作回查原文的提示。
那篇功課原文說,功課可以問 AI,第一步仍要由學生自己做。讀 AI 摘要也一樣,轉發和引用之前,回到原文那一步,仍要由讀的人自己做。
@張Sir的AI養生館 – 學習智人
延伸閱讀
- 《功課可以問AI,考試怎麼辦?》
- 《知道要小心 AI,卻不知道小心甚麼》
- 《AI 有幻覺,先分清病因再對症下藥》
- 《與 AI 聊天愈久愈不聽話,是它變笨了嗎?》
- 《為什麼最近 AI 模型「降智」了?》
參考資料
Lee, H., et al. (2026). When summaries distort decisions: Information fidelity in LLM-compressed financial analysis (arXiv:2606.29251) [Preprint]. arXiv.
Peters, U., & Chin-Yee, B. (2025). Generalization bias in large language model summarization of scientific research. Royal Society Open Science, 12(4), 241776.