從民調、大數據到AI應用,重新理解母體、代表性與判斷的責任
協作者:張Sir與AI
從「看不見的人」說起
張Sir的職業生涯,從民調、大數據挖掘一路走到今天的AI應用和研發。工具不斷改變,有一個問題始終沒有變:在問「我們想知道什麼」之前,先要弄清楚「我們想聽誰說話」。
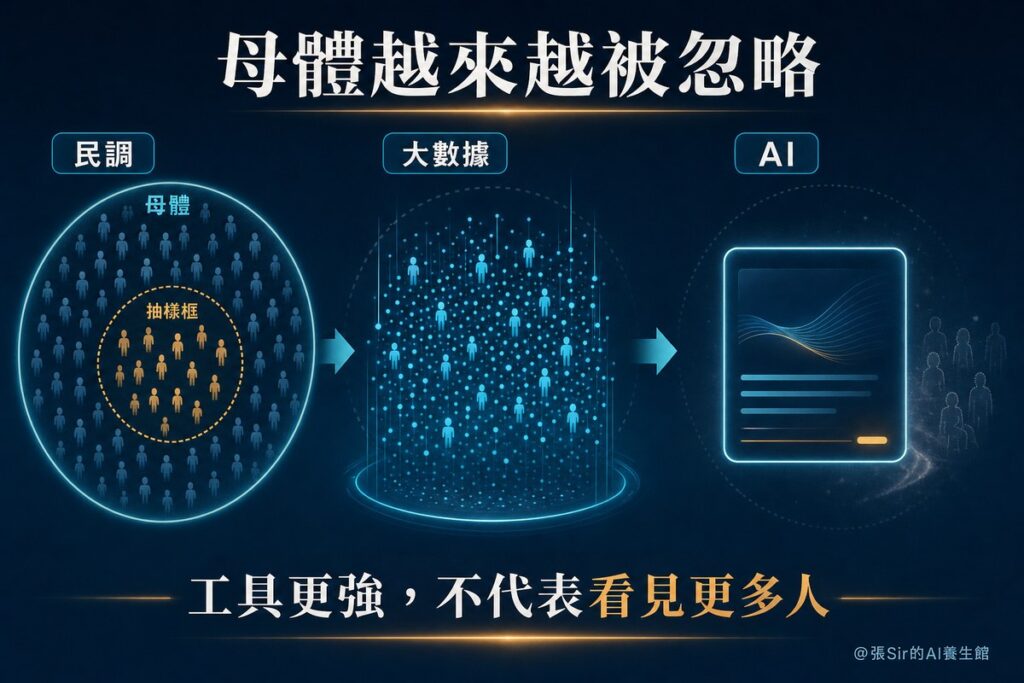
想了解全澳門居民對某項政策的態度,母體(population)就是全澳門符合資格的居民;想了解香港年輕人的就業焦慮,母體就是特定年齡、特定時間、特定地域內的年輕人。母體有明確的邊界,可以是一群人,也可以是一組事件、文本或行為。研究結論能否成立,首先取決於有沒有說清楚:我研究的究竟是誰?我沒有研究到的又是誰?
張Sir曾在一間機構內用電郵做員工滿意度調查,結果漏掉了沒有使用電郵的基層員工,後來改用紙本問卷,補做這部分員工的調查。調查想了解的是全體員工,當時使用的聯絡名單卻只包括有使用電郵的員工。那些看不見的人,很多時連問卷也收不到。
當母體太大、太分散,無法逐一訪問時,機率抽樣(probability sampling)讓抽樣框內每名成員都有機會被抽中,而且機會的大小可以計算。研究者再配合分層、加權及無回應處理,建立由樣本(sample)推論母體的依據。若要估計整體居民的看法,便不能只憑方便取得的某一群人作普遍推論。
但今天,更省力的資訊取得方式,很容易掩蓋這種對整體代表性的承諾。
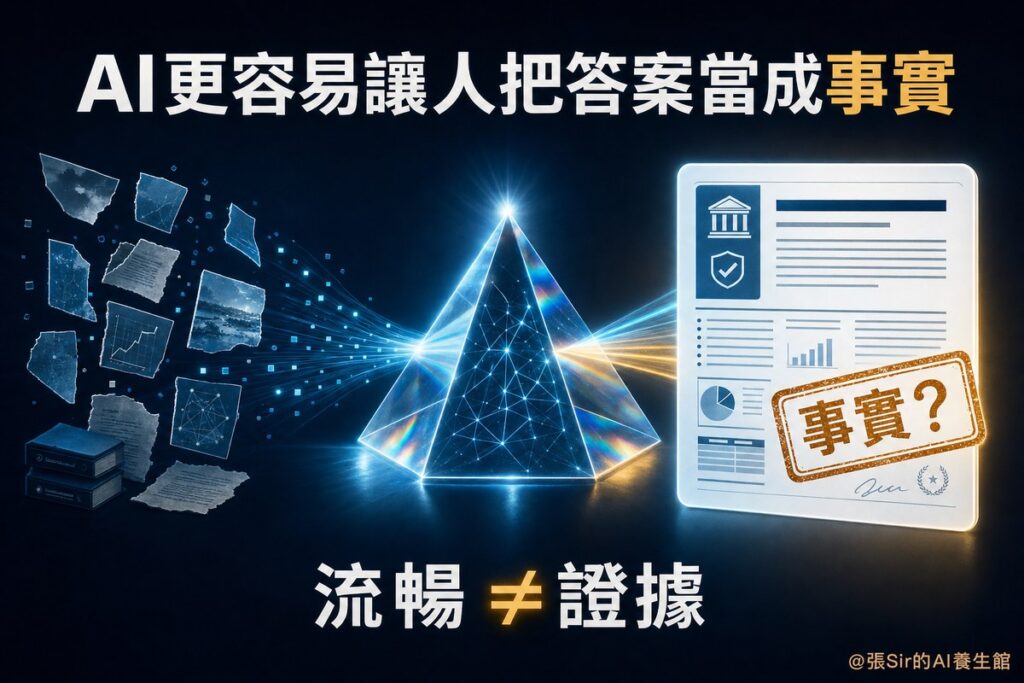
社交平台提供「熱門討論」,搜尋引擎列出「大家都在問」,生成式AI則給出一段看似完整、流暢、有條理的答案。然而,取得答案的便利,也可能讓人省略原本必要的追問。這是誰的聲音?誰被排除了?數據從哪裡來?樣本是否代表我們想推論的群體?所謂答案,會不會只是把最常見、最容易被索引、最符合模型訓練分布的觀點,重新包裝成「共識」?
本文關心的,是當AI讓答案更容易取得時,我們如何繼續判斷數據涵蓋了誰、證據是否可靠,以及結論能推論到哪裡。
母體被忽略,不代表它不重要
大數據常給人一種錯覺,既然能觀察幾百萬則貼文、幾千萬次搜尋、幾億次點擊,就不再需要抽樣。數據已經這麼大,難道還不算全部嗎?
數據規模大,仍要看它涵蓋了誰。抓取到的社交媒體數據,來自使用該平台、願意公開發言,而且內容可被取得的人。平台選擇、關鍵字、語言、公開設定及收集方法,都可能影響最後包括哪些紀錄。這些人留下的痕跡不能直接代表「公眾」,甚至未必是「網民」的完整樣本;發言者的自我選擇與抽樣框不完整,也會影響推論。
一項Twitter(X)抽樣回顧指出,按貼文抽樣可能偏重活躍用戶,因此要分清研究的是貼文、帳號還是人。
理解母體,首先要知道數據能夠取得,不等於母體已被完整涵蓋。
一個城市的交通卡數據很龐大,但不包含不使用交通卡的人;一個電商平台有很多評論,但不包含沒有購買、沒有留言,或被平台規則過濾的人;一個AI模型的訓練語料很多,但仍受資料來源、語言、數碼化程度、取得方式及篩選程序限制,不能涵蓋人類經驗的全貌。
用電訊商的手機訊號估算活動人流,便會遇到裝置數不等於人數的問題。數據只涵蓋該網絡能偵測的設備,還要處理一人多機、其他電訊商用戶及活動邊界等問題。不同偵測技術的條件也不同,不能把偵測到的手機數直接當成現場總人數。
手機訊號可用來觀察人流變化,經校準與驗證後也可協助估算人數。但應交代覆蓋範圍、去重、擴估方法與誤差,並分清同時在場人數、不重複出席人數及累計人次。從裝置推算到人,仍需要方法支持。
AI還可能形成「回音室中的回音室」。《Nature》一項研究顯示,若模型反覆使用未經區分的生成內容訓練,原始數據中較少見的資訊可能逐步流失。研究雖然沒有直接測量社會群體的能見度,卻帶來一項警示:如果某些群體的數據本來就少,生成內容再不斷回流,這些經驗可能更難被模型保留和呈現。
所以,AI時代需要恢復的能力,除了「找更多數據」,還包括追問這些數據的母體是什麼、誰不在裡面,以及誰被系統性地低估。
樣本能否代表母體,還要看誰被選進來
很多人把代表性理解為樣本數,認為樣本越大,結果越準。增加樣本通常有助降低隨機抽樣誤差,但系統性偏差未必隨之減少。
如果想知道一個社會對某項政策的支持度,卻只收集社交平台上最活躍、最有時間、最願意表達及參與公共討論者的意見,即使有一百萬則留言,得到的仍可能只是「活躍表達者」的看法,未必代表「全體居民」。沉默的人、不使用智能手機的人、不願公開表態的人、語言能力受限的人,以及被算法邊緣化的人,都不會因為數據量增加而自動出現。
評估樣本能否支持母體推論,首先要看誰有機會被選中、誰沒有回應,以及估計採用了什麼設計與假設。年齡、性別、地域、教育、收入、族群、語言、城鄉、政治傾向等重要變量的分布,可協助檢查與調整部分偏差,但人口比例相近仍不足以保證代表性。配額能控制部分結構,本身不等於機率抽樣;加權也不能保證修正所有未被觀察的差異。
例如,Pew Research 的調查以住址機率抽樣建立樣本,再透過加權,估計美國成年人口的情況。
此外,大數據應用常把「可觀察」誤當成「可推論」。看到網上的責罵,不代表知道整個社會有多憤怒;看到疾病搜尋,不代表知道誰真正患病;偵測到多少部手機,不等於知道現場有多少人;AI能生成看似權威的回答,也不代表它反映了真實世界的證據分布。
研究目標不同,所需的推論依據也不同。估計居民比例,要處理母體代表性;探索使用經驗或比較教學設計,可以研究特定樣本,但不能據此宣稱所有人都如此。
從民調到網絡挖掘,再到AI應用,張Sir信奉的方法論核心從未改變,先界定母體,再設計取得數據的方式,然後誠實說明推論邊界。 這種判斷不僅關乎如何取得數據,也關乎人是否仍願意親自思考。
AI帶來的,是新的「認知外包」
AI能幫助研究者整理文獻、清理數據、生成問卷初稿、辨識文本主題、輔助編碼、模擬情境,也可以加快原型開發。這些能力有巨大價值,讓研究者能更有效處理更多工作。
近期不少人談論的認知卸載(cognitive offloading),原指人們把記憶、計算、導航等任務交給外部工具,以減輕認知負擔。用日曆記約會、用計數機算帳,並不一定讓人變笨;關鍵是卸載了什麼,以及它與學習目標有何關係。若工具只是處理次要工作,人仍能理解核心內容,並自行重現推理過程,卸載便有機會幫助學習。若卸載的正是學習目標所要求的思考過程,則可能妨礙該次學習或技能練習。
生成式AI可以搜尋和綜合內容,也能協助寫作、形成論點,令這條界線變得模糊。人們甚至可能把該問什麼、看哪些證據、相信什麼結論的判斷,都交給它。
Wharton 商學院的Shaw與Nave在2026年的論文預印本中,報告了三項預先登記實驗。參與者回答推理題時可以向AI求助,研究人員則隨機控制AI提供正確或錯誤答案,觀察這些答案如何影響參與者的判斷與信心。作者把未經充分審視便採納AI答案的情況稱為「認知投降」(cognitive surrender)。在這些推理任務中,相較於沒有AI協助的情況,正確的AI答案提高了參與者的答題準確度,錯誤答案則降低了準確度。然而,即使AI提供錯誤答案,參與者使用AI後的信心仍有上升。要理解這種影響,還要回頭看AI答案建立在什麼數據與選取條件上。
AI答案背後,也有資料邊界與選擇機制
人們習慣把抽樣、代表性、偏差等概念用在人身上,卻很少用它們檢視AI輸出。
AI回答的形成,受到訓練數據、檢索結果、模型參數、提示詞、系統設定與安全過濾機制影響。把它比作一個「樣本」,有助追問它參照了怎樣的世界,但不能等同於從全體人類觀點中抽取的機率樣本。文字能被生成,也不代表它已經過事實核查。
要理解這些邊界,可以從以下五個方面檢查。
- 訓練資料的涵蓋範圍,要看哪些語言、地區、階層、歷史時期和知識傳統被充分收錄,哪些被忽略。
- 檢索的選取機制,要看AI若連接網絡,可以檢索哪些網站和資料,以及語言、排序、新近性與存取限制如何影響結果。
- 內容生產者的結構,要看網絡文本主要由哪些人產生,哪些群體較少公開表達、較難被索引或未被數碼化。
- 提問框架會影響AI怎樣回答,也會預設某些定義,排除另一些可能性。
- 核查能力與權限,要看誰能看到原始來源、資料及處理步驟,並有時間和能力驗證;也要看誰缺乏條件核查,只能依賴輸出。
即使附有來源,也要核實來源是否真實存在、內容是否過時,以及AI有沒有誤讀原文。
其中只有部分屬於統計意義上的母體問題,但它們共同決定AI答案能看見什麼、忽略什麼,以及使用者能否發現限制。AI回答是否涉及統計推論,要視問題而定。當答案聲稱某種情況「普遍」「多數」或代表某個群體,便須交代涵蓋範圍與推論依據。法規生效日期、歷史日期或機構數字,重點在於來源是否權威、可追溯而且最新。要理解某個群體的生活經驗,則要留意是否聽到了群體內不同成員的聲音,以及他們所處情境的差異。代表性與事實準確性相關,卻不是同一回事。
要理解使用者如何面對這些有邊界的答案,可以參照幾項研究。
Pew的2025年調查顯示,曾透過聊天機器人取得新聞的美國成年人中,三分之一自覺難辨真假。
澳門互聯網研究學會的2026年居民電話調查顯示,在6至84歲生成式AI使用者中,45%表示從不或只是偶爾核查AI生成資訊;調查亦顯示,該群體對「我知道什麼是AI幻覺」這項自陳敘述的平均同意分為2.6分,滿分5分。
歐洲廣播聯盟與BBC統籌的新聞AI研究,以多種語言測試ChatGPT、Copilot、Gemini及Perplexity的新聞回答;其發布資料指出,部分回答出現事實錯誤和來源標示不當等重大問題。
這些研究回答不同問題,分別提醒我們檢查答案品質、辨識困難與核查行為。對重要答案建立核查習慣,正是回應這些風險的基本做法。
科學的本質,在於答案能否檢驗
科學可貴,因為它建立了一套讓錯誤可以被發現的程序,讓科學家有機會檢查和修正自己的判斷。
研究者要界定概念,說明研究對象、數據取得和分析方法,讓別人能追查問題、定義、數據與結論之間的關係。不同研究設計各有要求,探索性分析未必預先提出完整假設,但應交代哪些分析事先設定、哪些在看過數據後才提出,也應保留適當紀錄,容許檢查、重做和反證。
當答案以自然語言呈現,語氣肯定、結構完整,引用也看似合理,人們很容易把它當成已完成的研究。但涉及實證研究或群體推論的回答,至少要說清楚母體與數據從哪裡來、變量和分析如何設定,以及結論可以推論到哪裡。重要結果還應接受不同樣本、時間點或模型的穩健性檢驗。
AI可以幫忙寫出這些說明,卻不能替人完成所有判斷。它能生成問卷初稿,題目是否測量了研究者想了解的概念,仍須研究者判斷。它能分析數據,數據是否乾淨、權重是否合理、因果方向是否成立,也要由人核查。即使AI列出文獻,使用者仍要閱讀原文、檢查脈絡和辨識方法缺陷。
有偏差的內容經AI大量生成,再被搜尋、引用和使用,影響可能超出原有數據集,進一步改變人們理解世界的資訊環境。涵蓋、抽樣與代表性的要求,也要延伸到內容生成與傳播的整個過程。
當AI回答涉及實證主張、群體概括,或試圖由數據推論現實情況時,可以從以下問題逐一檢查。
- 先問母體。 這個結論想推論到誰?數據實際來自誰?
- 再問涵蓋。 誰沒有手機、沒有帳號、不發言,或被過濾、被忽略?
- 再問選取。 數據如何被選入?採用了什麼抽樣或招募方式?算法排序又作了什麼篩選?
- 再問測量。 這個指標真的測量了我們聲稱的概念嗎?
- 再問生成。 內容由人類產生、AI輔助產生,還是完全由AI生成?
- 再問驗證。 關鍵主張是否有原始來源、獨立來源與可複製的程序?
- 再問限制。 這個結論不能推論到哪些人、情境和時間?
這套程序是評估實證主張、避免過度推論的重要保障。能否落實,取決於使用者是否願意保留判斷。
AI素養,也包括保留判斷的能力
很多人把AI素養理解為會寫提示詞、會用某個模型,或會建立自動化工作流。這些能力當然重要,但仍屬操作層次。
AI素養還包括後設認知能力,也就是知道何時應該自己想、何時可以借助AI、何時必須親自驗證,以及何時應該堅持自己作判斷。
Lee等人的調查訪問每週在工作中使用生成式AI的知識工作者。受訪者把自己的思考工作描述為逐漸轉向資訊驗證、答案整合和任務監督。這些自述提供了人機分工的經驗線索,也引出哪些判斷應由人承擔的問題。
在張Sir看來,衡量AI素養,不能只看工具使用是否熟練,也要看使用者是否知道,哪些說法必須親自核查,哪些決定不能直接交給AI。
對研究者而言,這意味著要為AI安排合適的工作。
- 讓AI處理可驗證、可重複、低風險的機械工作,例如初步整理資料、轉換格式,以及提供文獻檢索線索。代碼草稿則須在可測試、可審查的條件下使用。
- 概念界定、研究設計、抽樣框架、倫理判斷、因果解釋與結果詮釋等關鍵環節,可以借助AI討論,但須由人類主導審查、作出決定並承擔責任。
- 將AI輸出視為「待檢驗的假說」或「待核查的草稿」,不當作「已完成的知識」。
- 為重要決策保留可供人類審查的證據,包括數據來源、處理步驟、模型版本、提示詞、權重與限制。
成熟的人機協作,需要各自處理合適的工作,並由人承擔不能外包的責任。
回歸科學本質:謙遜、邊界與責任
AI是否會普遍削弱人的思考,仍需要更多證據;但凡答案涉及實證主張、群體概括或公共判斷,數據涵蓋、證據品質與推論邊界都不能省略。即使借助AI,我們仍要繼續追問:
- 這是誰的聲音?
- 這是誰的數據?
- 誰沒有被看見?
- 這個答案能推論到哪裡?
- 我憑什麼相信它?
- 如果它錯了,我如何知道?
母體、抽樣、代表性,這些看似老舊的概念,仍是AI時代重要的判斷依據。這些概念提醒人們,最活躍的留言者、最容易被搜尋的網頁,以及最流暢的模型輸出,都不足以呈現整個世界。真實世界總比手上的數據大,也比現有模型複雜。
科學的價值,是誠實說明我們知道什麼、不知道什麼,以及憑什麼知道。一個看似令人安心的答案,代替不了這些交代。當AI越來越擅長生成答案,人類更要繼續提出那些令人不舒服、不方便,卻不能省略的問題。
@張Sir的AI養生館 – 學習智人
參考資料
澳門互聯網研究學會。(2026)。解碼生成式AI行為:澳門居民的應用、觀點與素養(Decoding generative AI behavior: Applications, perspectives and literacy of Macao residents)。
European Broadcasting Union. (2025, October 21). News integrity in AI assistants. EBU–BBC study. 另見EBU新聞稿(2025年10月22日)。
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. In Proceedings of the 2025 CHI Conference on Human Factors in Computing Systems (Article 1121, pp. 1–22). Association for Computing Machinery.
Lipka, M., & Eddy, K. (2025, October 1). Relatively few Americans are getting news from AI chatbots like ChatGPT. Pew Research Center.
Risko, E. F., & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences, 20(9), 676–688.
Shaw, S. D., & Nave, G. (2026). Thinking—Fast, slow, and artificial: How AI is reshaping human reasoning and the rise of cognitive surrender [Preprint]. The Wharton School Research Paper. SSRN.
Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755–759.
Vicente, P. (2023). Sampling Twitter users for social science research: Evidence from a systematic review of the literature. Quality & Quantity, 57, 5449–5489.