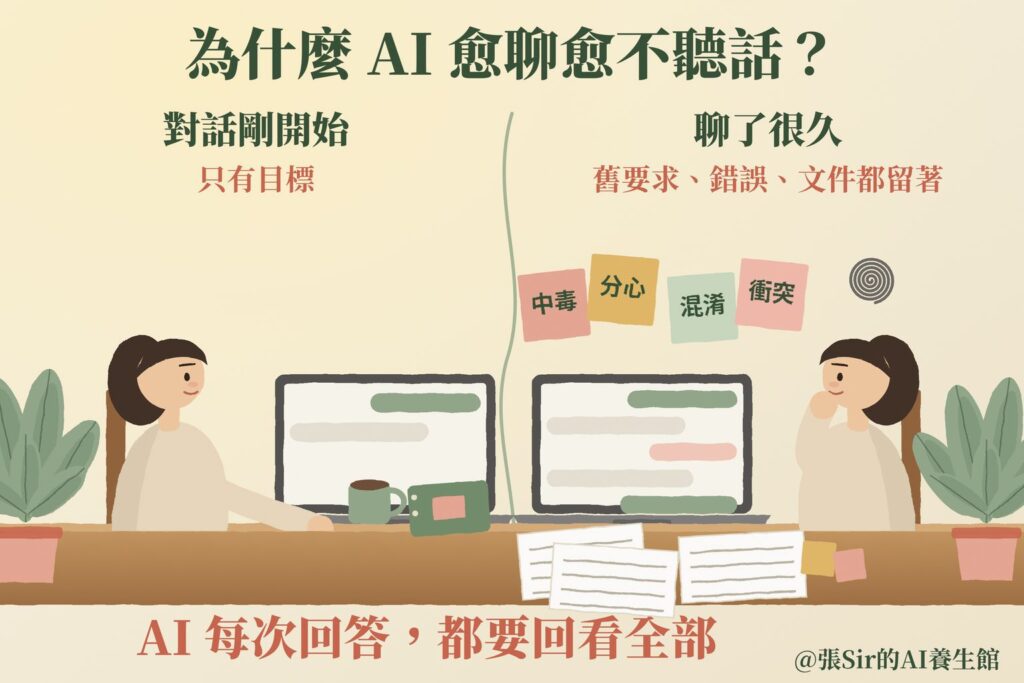
AI 每次回答都會回看前面的對話,錯誤和舊的要求留得愈多,後面愈容易不聽話
協作者:張Sir與AI
上一篇《提示詞還要學嗎?》發出後,有朋友跟張Sir說,他已經照著做,不背提示詞公式,直接和 AI 對話,哪裡不對就叫它改。可是談得愈久,AI 反而愈不聽話,改過的錯處會再出現,後面補的要求也好像視而不見。
這個問題正好補上上一篇沒有講完的一半,把 AI 當同事,用日常說話邊做邊改,方法沒有錯,只是同一段對話拖得太長,錯誤、舊要求和轉題全部堆積在一起,AI 便可能被前面的內容牽著走。
設想一場會議開了幾個小時,主管先叫人按部門整理,後來改為按地區,最後又刪去一項數字。三個版本都放在桌上,卻沒標明哪份仍然有效,同事便可能拿著舊版繼續做。AI 面對長對話,也要同時看著新舊要求、自己之前的答案、文件和工具結果。
聊久了,表現便變得忽好忽壞
今年 4 月,Microsoft Research 和 Salesforce Research 公布一項研究,把原本一次講完的要求拆開,讓 15 個模型逐步收到資料,再和一次講齊的版本比較,共測試超過 20 萬段模擬對話。
研究為 15 個模型完成任務的答案評分。用戶一次講齊要求時,模型平均約有 90 分;要求拆到多輪才逐步講完,平均只剩 65 分。
研究還把同一道題重複測試十次。較高分的一端只下降約 16%,高分和低分之間的距離卻增加 112%。意思是模型仍然答得出好答案,但有一些對話會差得很遠。研究人員回看這些失敗對話,發現模型常在資料還沒講完時先猜答案,後面再沿著早段的猜測走。同一項工作,有時答對,有時從第一步開始走偏,用戶感受到的就是忽好忽壞。
一句更正有時改不回來,是因為新一輪對話不會擦掉前面的答案,模型仍然看得到那條錯路。輪數只是表面,對話裡留下了什麼,對後面的輸出影響更大。
對話裡的內容,不會自動分出輕重
上下文(context)是 AI 當下可以看到的全部內容,包括對話歷史、文件、規則和工具結果。模型的視窗能放得下很多資料,不代表應該全部放進去。裡面每多一項,AI 便多一項內容要分辨和取捨。
長對話究竟會在哪裡出錯?從事 AI 工程工作的 Drew Breunig 看過多種人工智能代理失靈的情況,在 How Long Contexts Fail 文章裡整理成四類,之後再於 How to Fix Your Context 一文說明處理方法。
第一類「中毒」,就是很多人熟悉的人工智能幻覺(hallucination,即 AI 編造出來的內容)留在對話裡。發現後立即改正,問題還不大;後面每一輪都把它當成事實,整段對話便會走偏。
- 中毒(Context Poisoning),AI 出現幻覺,後面一直把錯誤當真。先核對重要資料,錯了便停止沿用。
- 分心(Context Distraction),資料太多,AI 被舊紀錄困住,忘了原來要做什麼。先摘要出目前的目標和進度。
- 混淆(Context Confusion),文件、工具和規則太多,AI 不知道先用哪一個。只保留這次需要的材料。
- 衝突(Context Clash),新舊要求同時存在,像幾個老闆一起發指令。移除舊版本,再交代完整新版本。
以上四種情況也會互相牽連,錯誤先令對話中毒,資料增加後開始分心,用戶再改要求,新舊版本便互相衝突。
這種幻覺怎樣一路留下來,研究論文《Breaking Contextual Inertia》附錄有一個例子。用戶問物理治療總費用,AI 自行加上「保險承擔 80%」,用戶從未提供這個條件。後來用戶補上每小時收費 125 美元,AI 仍沿用保險假設,算出 600 美元;按用戶實際提供的條件,答案應是 3,000 美元。
研究者把這種固守先前推理、連用戶更正也難以扭轉的傾向稱為上下文慣性(contextual inertia)。AI 收到了更正,可是前面的錯誤已經成為後面計算的起點。
就算沒有明顯錯誤,內容太長也會分心。Chroma 的研究團隊稱這種現象為上下文退化(context rot)。他們的技術報告測試 18 個模型,其中一項測試只給約 300 個詞元(token,即 AI 處理文字的基本單位)的相關內容,表現都比讀取約 11.3 萬個詞元的完整歷史好。上下文視窗放得下,不代表全部內容都有幫助。
除了資料太長會分心外,選項太多則會混淆。設想一個人工智能代理(AI agent)有 50 個工具,這次只需查訂單進度,其餘工具的說明仍然全部放在對話裡。可選的工具愈多,選錯的機會也愈多。
辦公室也常見新舊要求的衝突,同事先叫 AI 把各部門的數字分成三張表,主管後來改為合在一張總表。若只補一句「不要分開」,AI 仍不知道原來的欄目和小計是否保留。改成「只交一張總表,以部門為列,不另做分表」,才完整取代舊要求。
要求一路改,AI 最容易掉隊
表格版本改來改去,仍算同一件工作。日常對話還有更大的轉向,連任務的對象和用途也換了。寫一封信,可能經過這幾輪:
- 先幫我寫一封客戶信。
- 語氣再正式一點。
- 不要提到降價。
- 改成給法務看的版本。
- 等等,剛才那個條件還是要保留。
前兩句仍在修改同一封信,到了「改成給法務看」,對象和用途都變了。AI 若沒有重新整理目前版本,法務稿裡仍可能出現已經刪去的降價內容。
這種中途改口和轉題,正是《LLMs Get Lost in Evolving User Intent》測試的情況。研究把交給大語言模型(LLM)的題目由一次問完改成最多七輪,再加入三種變化:補充條件、改掉先前條件,以及轉去做另一項相關工作。轉題可以是先找餐廳,後來改為訂位;放回上面的例子,就是由寫客戶信改成寫法務稿。九個較新的模型在數學題上的表現全部下降,轉題造成的下降最大。
研究者再分開測試對話變長和要求改變。GPT-5.1 做同一批數學題,只用意思不變的內容把四輪延長至七輪,準確率由 87.0% 變成 87.5%;七輪裡加入更多方向轉變,便降至 82.0%。多三輪沒有令成績下降,改方向才有影響。客戶信改成法務稿後,讀者、用途和判斷標準都換了;舊對話仍在談怎樣說服客戶,AI 便容易沿著已經作廢的目標繼續寫。
整理目前版本,再開啟新對話
多輪對話的問題既然來自舊內容累積,處理時就要先把目前仍然有效的內容分出來。對話開始變亂時,先不要再補一句指令。請 AI 整理一份「目前版本」,只留下五類內容:
- 現在要完成什麼。
- 哪些要求仍然有效。
- 哪些舊要求已經作廢。
- 哪些事實、數字和來源已經核對。
- 還有哪些假設和問題未確認。
AI 整理完,人還要看一遍。數字和來源有沒有錯,作廢條件是否仍混在裡面,AI 自行加上的假設有沒有被當成事實,這些都要檢查。確認後,把這份目前版本貼進新對話,讓 AI 只按現行要求繼續工作。
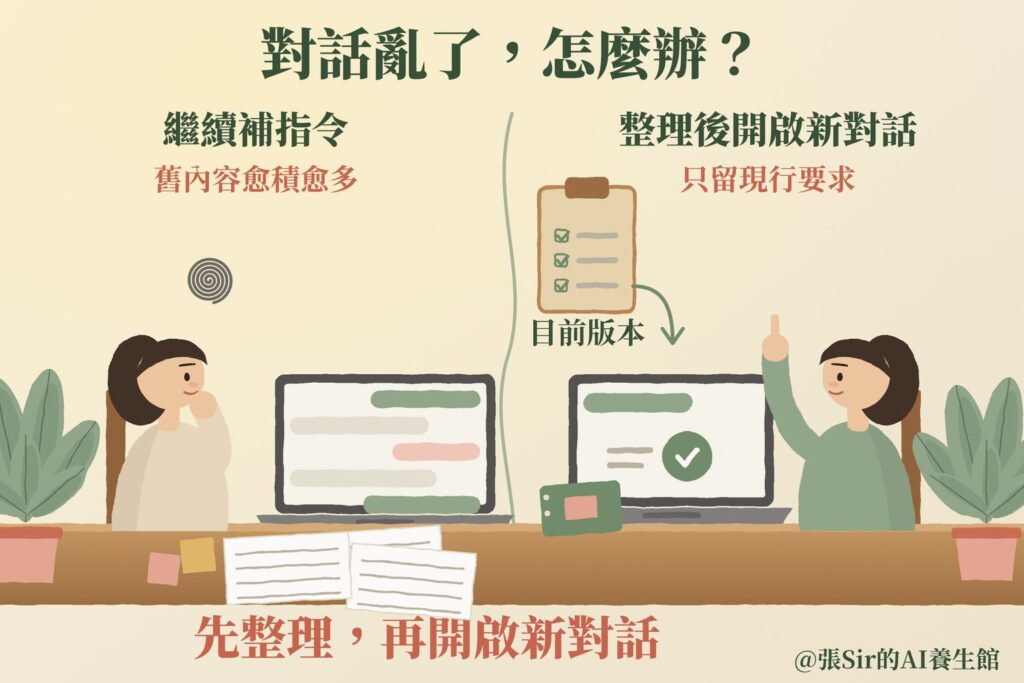
貼進新對話的,就是這次任務的最新狀態。上一篇談過覆盤和 Skill,常用的語氣、標準和流程可寫進 Skill;這次的進度、數字和臨時決定,只放進新對話。兩類資料分開,一次性的要求便不會混入長期規則。
資料分開後,支援 Skill 的 AI agent 可以代為整理;尚未支援的,便由用戶把目前版本貼進新對話。兩種做法都要由人確認目標和核對結果。
本文開頭提到的那位朋友,不用再學一條更長的提示詞。繼續補指令,只會令舊對話更長。整理目前版本,核對後再開啟新對話,AI 看到的便只有現行要求,不必再猜哪一句才算數。這樣,改過的錯處不容易再冒出來,後面補的要求,也較容易被 AI 看見。
@張Sir的AI養生館 – 學習智人
參考資料
Breunig, D. (2025, June 22). How long contexts fail. dbreunig.com.
Breunig, D. (2025, June 26). How to fix your context. dbreunig.com.
Chen, X., Zhang, Z., Guo, S. Y., & Zou, D. (2026). Breaking contextual inertia: Reinforcement learning with single-turn anchors for stable multi-turn interaction. In Findings of the Association for Computational Linguistics: ACL 2026 (pp. 6302–6318). Association for Computational Linguistics.
Hong, K., Troynikov, A., & Huber, J. (2025, July 14). Context rot: How increasing input tokens impacts LLM performance. Chroma.
Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs get lost in multi-turn conversation. The Fourteenth International Conference on Learning Representations.
Tack, J., Laban, P., & Neville, J. (2026). LLMs get lost in evolving user intent (arXiv:2607.20734). arXiv.